Optymalizacja kosztówPrzewodnik
Śledź wydatki API na projekt i otrzymuj alerty budżetowe w Pythonie
Krótki skrypt w Pythonie zamienia Twój log użycia w raport kosztów na projekt i ostrzega przy 50, 75, 95 i 100% miesięcznego budżetu.
Na tej stronie
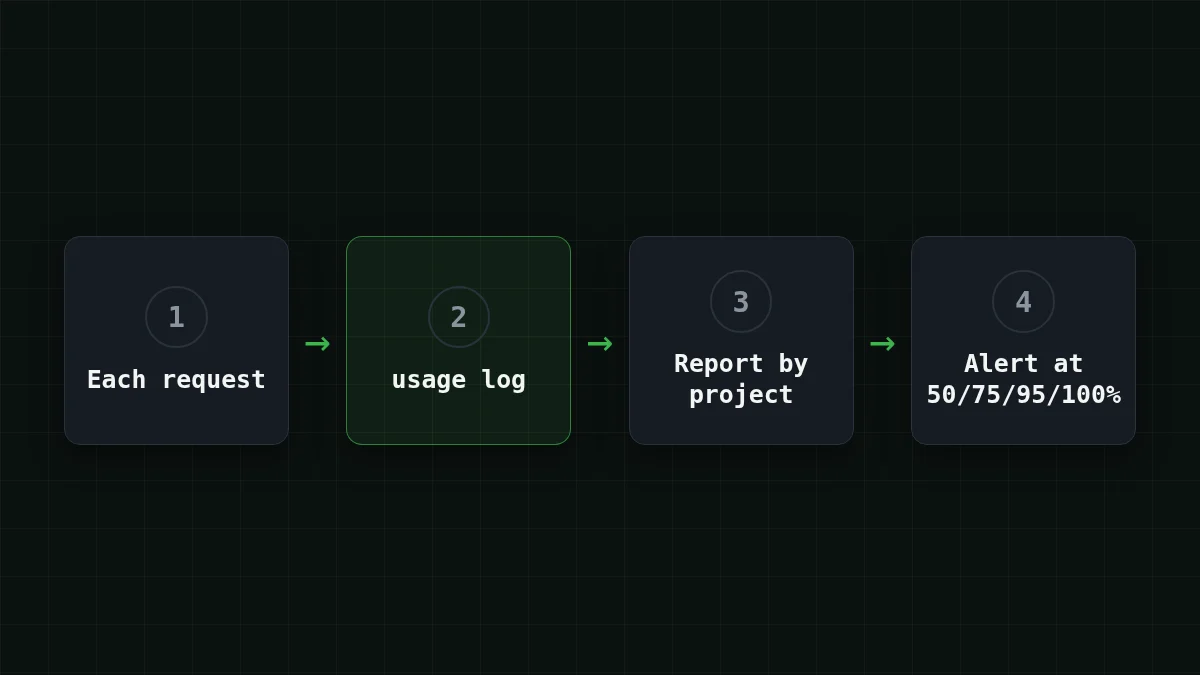
Dodaj jedną linię JSON do pliku po każdym wywołaniu API, oznacz ją nazwą projektu i pozwól 30-liniowemu skryptowi w Pythonie zamienić ten plik w raport kosztów na projekt oraz ostrzeżenie przy 50, 75, 95 i 100% miesięcznego budżetu. To ten sam widok, który Anthropic właśnie udostępnił zespołom Claude Enterprise, zbudowany z Twojego własnego logu.
Załóżmy, że jedno saldo zasila agenta, skrypt do pisania szkiców blogowych i małego bota wsparcia. Nadchodzi koniec miesiąca, saldo jest niższe, niż się spodziewałeś, i nic nie mówi Ci, który z tych trzech to sprawił. To właśnie tę lukę zamyka ten tekst.
Co udostępnił Anthropic i co możesz skopiować#
Ogłoszenie Anthropic (28 października 2026) obejmuje inteligentne raporty, ankiety w aplikacji i wspólne budżety grupowe, ogólnie dostępne tylko w planach Claude Enterprise (source). Dwie części mają tu znaczenie. Raport grupuje pracę zespołu w strumienie pracy i pokazuje wydatki każdego z nich. Wspólny budżet to jedna współdzielona miesięczna kwota, a administratorzy rozliczeń dostają e-mail przy 50%, 75%, 95% i 100% jej wysokości. Anthropic dodaje, że raporty służą do planowania inwestycji, a nie do oceniania poszczególnych osób.
Nie potrzebujesz planu enterprise, żeby uzyskać ten sam kształt. Strumień pracy to po prostu etykieta, którą wybierasz, a cztery progi to jedna lista w kodzie. Grupuj według projektu, nie według osoby, z powodu podanego przez Anthropic.
Szybkie sprawdzenie
Twoje przedpłacone saldo już zatrzymuje żądania przy zerze. Po co dodawać ostrzeżenia przy 50% i 75%?
Pokaż odpowiedź
Odpowiedź: Ponieważ zero to za późno: chcesz zauważyć wymykającą się spod kontroli pętlę, dopóki są jeszcze pieniądze, żeby to zbadać
Saldo to twardy stop, nie alarm. Wczesne progi zamieniają niespodziankę przy 100% w pytanie dziewiątego dnia.
Log: jedna linia na żądanie#
Każda odpowiedź ukończenia czatu zawiera obiekt usage z prompt_tokens i completion_. To wszystko, czego potrzebuje raport, plus etykieta projektu, którą dodajesz sam. Ten wrapper wysyła żądanie i dopisuje jedną linię do miesięcznego pliku (nazwa pliku zmienia się co miesiąc, więc nowy miesiąc zaczyna się od zera):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
Użyj pełnego identyfikatora modelu z dokumentacji CheapTokens (deepseek-, zai-); krótkie nazwy z tabel cen nie są akceptowane przez API. Klucz pochodzi ze zmiennej środowiskowej, nigdy z pliku.
Skrypt: koszt na projekt i alerty progowe#
Zapisz to jako report.py. Ceny są przykładowe: skopiuj aktualne z tabeli cen (oba modele mają tu jedną przykładową cenę tylko po to, by arytmetyka była czytelna).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
Ostatnie cztery linie to część, o której ludzie zapominają. Bez małego pliku stanu skrypt krzyczałby "przekroczono 50%" przy każdym uruchomieniu do końca miesiąca. Z nim każdy poziom uruchamia się raz.
Uruchom to i odczytaj wynik#
Weź zabawkowy log z czterema liniami (prawdziwy ma linię na żądanie, więc tysiące):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
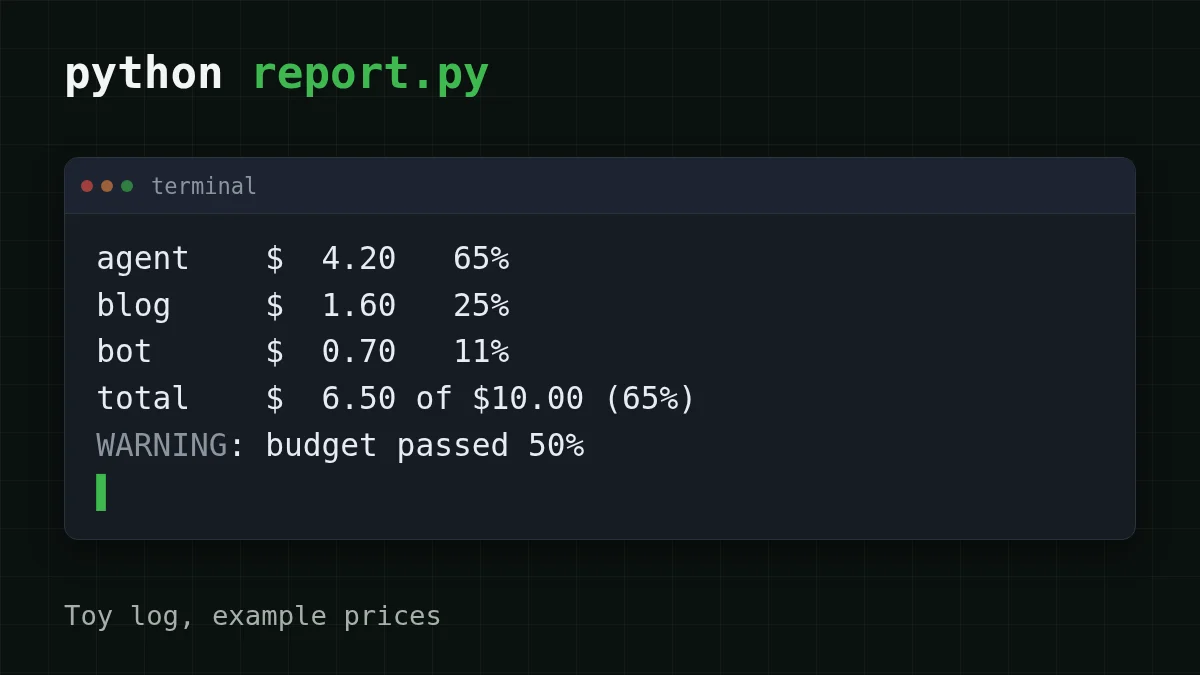
Przy przykładowych cenach i budżecie 10, python report.py wypisuje:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
Agent to prawie dwie trzecie rachunku, a ostrzeżenie przyszło przy 50%, nie na końcu. Uruchom ponownie, a ostrzeżenie pozostanie ciche, dopóki suma nie osiągnie 75%.
Aby to działało co miesiąc, potrzebujesz trzech kroków:
Krok po kroku
Podłącz to w trzech krokach
Loguj każde wywołanie
Przekieruj wszystkie swoje wywołania przez ask(project, model, messages) i wybierz krótką, stabilną etykietę projektu. Zmiana nazw etykiet w połowie miesiąca dzieli jeden projekt na dwa wiersze.
Ustaw ceny i budżet
Wpisz aktualne ceny z tabeli cen do PRICES i wyeksportuj swój limit: export BUDGET_.
Uruchamiaj według harmonogramu
Godzinna linia cron wystarczy: 0 * * * * cd ~/. Wyślij wynik do polecenia mail lub chat, jeśli chcesz otrzymywać ostrzeżenie.
Jak wygląda miesiąc na tanich modelach#
Liczby stają się użyteczne, gdy są Twoimi liczbami. Załóż, że agent z zabawkowego logu zużywa średnio 30 000 tokenów wejściowych i 2 000 wyjściowych na krok, 20 kroków na zadanie, dwa zadania dziennie. Jeden krok na DeepSeek-V4-Flash kosztuje $0.00065; na GLM-5.3-Flash, $0.00068. Dzień to 40 kroków, miesiąc 1 200. Przesuń suwaki, aby dopasować do własnego agenta:
Kalkulator kosztów
Jeden dzień agenta: kroki na zadanie razy zadania na dzień
Tokeny wejściowe na żądanie: 30 000 · Tokeny wyjściowe na żądanie: 2000 · Żądania dziennie: 40
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
A miesiąc przy 1 200 krokach, z wejściem i wyjściem liczonym razem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1200 żądań | OpenRouter, 1200 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
30 000 tokenów wejściowych i 2000 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W sumie, z wejściem i wyjściem liczonym razem, oba modele wypadają taniej niż ceny referencyjne OpenRouter w tej tabeli, z jedną ceną o każdej porze i bez dopłaty za szczyt. DeepSeek-V4-Flash pozwala też na do 32 768 tokenów wyjściowych na odpowiedź i kontekst 380K; GLM-5.3-Flash ma kontekst 390K. Gdy raport pokaże, który projekt jest tym ciężkim, zmiana tylko ciągu model tego projektu to zmiana jednej linii, a jedno saldo obejmuje każdy model. Aby dowiedzieć się, ile tokenów naprawdę zużywa pojedyncze żądanie, zobacz ile tokenów zużywa żądanie API; aby zatrzymać jedno uruchomienie agenta w połowie, zobacz śledzenie kosztu tokenów agenta AI. Ceny i modele są na stronie modeli CheapTokens.
Gdzie to się psuje#
- Brakuje modelu w
PRICES. Skrypt zatrzymuje się zKeyError, który nazywa model. Dodaj go; nie ustawiaj domyślnie zera, bo projekt wygląda wtedy na darmowy. - Wywołania strumieniowe. Ostatni fragment zawiera użycie tylko wtedy, gdy o to poprosisz (
stream_w OpenAI SDK). W przeciwnym razie Twój log ma luki.options={"include_ usage": True} - Nieudane żądania. Loguj tylko odpowiedzi, które mają obiekt
usage; żądanie, które zakończyło się błędem, nie ma czego liczyć. - Raporty na osobę. Trzymaj etykietę jako nazwę projektu lub agenta. Raport o ludziach zaprasza do błędnych wniosków.


