비용 최적화가이드
Python으로 프로젝트별 API 지출을 추적하고 예산 경고 받기
짧은 Python 스크립트가 사용 로그를 프로젝트별 비용 보고서로 바꾸고 월 예산의 50, 75, 95, 100% 지점에서 경고합니다.
이 페이지의 내용
매 API 호출 후 파일에 JSON 한 줄을 추가하고 프로젝트 이름으로 태그한 다음, 30줄짜리 Python 스크립트로 그 파일을 프로젝트별 비용 보고서와 월 예산의 50, 75, 95, 100% 지점 경고로 바꾸세요. Anthropic이 방금 Claude Enterprise 팀에 제공한 것과 같은 뷰를 여러분의 로그로 직접 만드는 것입니다.
하나의 잔액이 에이전트, 블로그 초안 작성 스크립트, 작은 지원 봇을 함께 먹인다고 해봅시다. 월말이 되었는데 잔액은 기대보다 적고, 셋 중 무엇이 그랬는지 알려주는 것은 없습니다. 이 글은 바로 그 간극을 메웁니다.
Anthropic이 출시한 것, 그리고 여러분이 따라 할 수 있는 것#
Anthropic의 발표(2026년 10월 28일)는 스마트 보고서, 인앱 설문, 풀링된 그룹 예산을 다루며, 일반적으로 Claude Enterprise 플랜에서만 제공됩니다(출처). 여기서 중요한 부분은 두 가지입니다. 보고서는 팀의 작업을 워크스트림으로 묶고 각 워크스트림의 지출을 보여줍니다. 풀링된 예산은 하나의 공유 월간 금액이며, 결제 관리자는 그 50%, 75%, 95%, 100% 지점에서 이메일을 받습니다. Anthropic은 이 보고서가 투자 계획을 위한 것이지 개인을 평가하기 위한 것이 아니라고 덧붙입니다.
같은 형태를 만들기 위해 엔터프라이즈 플랜이 필요하지는 않습니다. 워크스트림은 그냥 여러분이 고르는 레이블이고, 네 개의 임계값은 코드 안의 리스트 하나입니다. Anthropic이 밝힌 이유대로 사람이 아니라 프로젝트로 묶으세요.
빠른 확인
선불 잔액은 이미 0에서 요청을 멈춥니다. 왜 50%와 75%에 경고를 추가할까요?
정답 보기
정답: 0은 너무 늦기 때문입니다: 아직 살펴볼 돈이 남아 있을 때 폭주 루프를 알아차리고 싶기 때문입니다
잔액은 경보가 아니라 하드 스톱입니다. 이른 임계값은 100%에서의 깜짝 놀람을 9일째의 질문으로 바꿉니다.
로그: 요청당 한 줄#
모든 채팅 완료 응답은 prompt_tokens과 completion_을 담은 usage 객체를 함께 가집니다. 보고서에 필요한 것은 이것과 여러분이 직접 추가하는 프로젝트 레이블뿐입니다. 이 래퍼는 요청을 보내고 월별 파일에 한 줄을 추가합니다(파일 이름이 매달 바뀌므로 새 달은 0에서 시작합니다):
import json, os, time
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1",
                api_key=os.environ["CHEAPTOKENS_API_KEY"])

def ask(project, model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    with open(time.strftime("usage-%Y-%m.jsonl"), "a") as f:
        f.write(json.dumps({"project": project, "model": model,
                            "prompt_tokens": r.usage.prompt_tokens,
                            "completion_tokens": r.usage.completion_tokens}) + "\n")
    return r

ask("support-bot", "zai-org/GLM-5.3-Flash",
    [{"role": "user", "content": "Where is my order?"}])
CheapTokens 문서의 전체 모델 id를 사용하세요(deepseek-, zai-). 가격표의 짧은 이름은 API가 받지 않습니다. 키는 환경 변수에서 가져오며 파일에서는 절대 가져오지 않습니다.
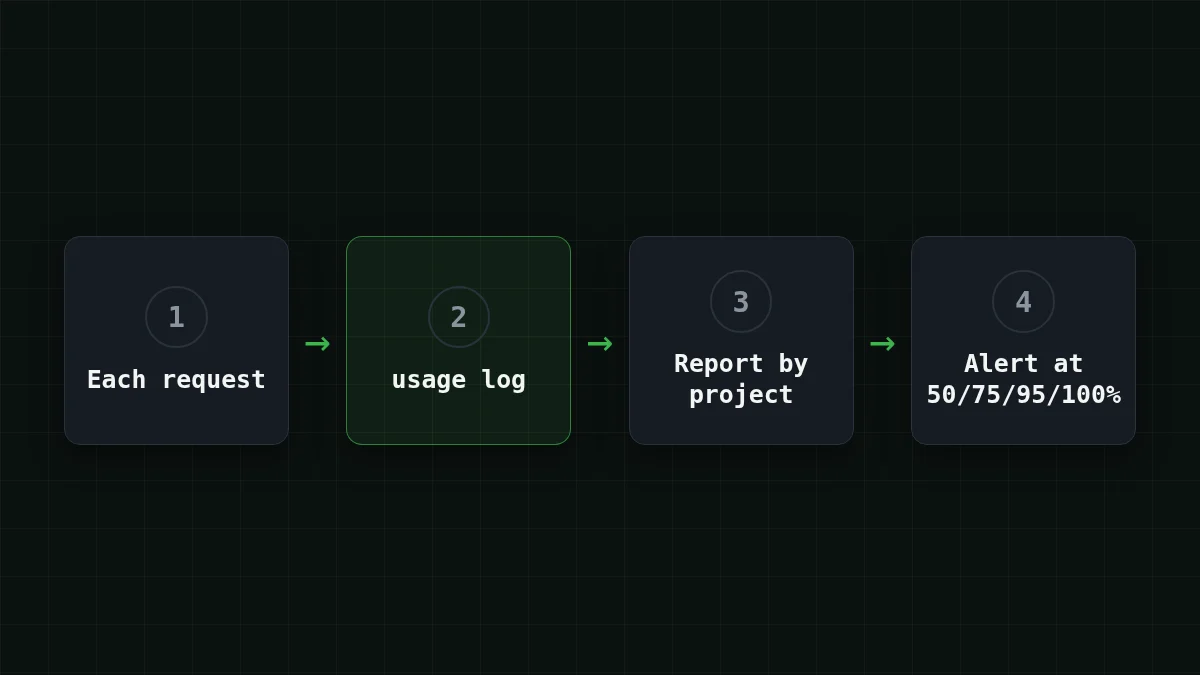
스크립트: 프로젝트별 비용과 임계값 경고#
이것을 report.py로 저장하세요. 가격은 자리표시자입니다: 가격표에서 현재 가격을 복사하세요(여기서 두 모델이 하나의 예시 가격을 공유하는 것은 산술을 읽기 쉽게 유지하기 위해서일 뿐입니다).
import json, os, sys, time
from collections import defaultdict

LOG = time.strftime("usage-%Y-%m.jsonl")
BUDGET = float(os.environ.get("BUDGET_USD", "10"))  # example, substitute your own
STATE = LOG + ".alert"
LEVELS = [50, 75, 95, 100]
PRICES = {  # USD per 1M tokens (input, output): example, substitute current prices
    "deepseek-ai/DeepSeek-V4-Flash-0731": (1.0, 2.0),
    "zai-org/GLM-5.3-Flash": (1.0, 2.0),
}

spend = defaultdict(float)
with open(LOG) as f:
    for line in f:
        r = json.loads(line)
        p_in, p_out = PRICES[r["model"]]
        spend[r["project"]] += (r["prompt_tokens"] * p_in
                                + r["completion_tokens"] * p_out) / 1_000_000

total = sum(spend.values())
if total == 0:
    sys.exit("log is empty")

for name, usd in sorted(spend.items(), key=lambda kv: -kv[1]):
    print(f"{name:<8} ${usd:6.2f} {usd / total:5.0%}")
print(f"{'total':<8} ${total:6.2f} of ${BUDGET:.2f} ({total / BUDGET:.0%})")

last = int(open(STATE).read()) if os.path.exists(STATE) else 0
crossed = [l for l in LEVELS if total >= BUDGET * l / 100 and l > last]
if crossed:
    print(f"WARNING: budget passed {crossed[-1]}%")
    open(STATE, "w").write(str(crossed[-1]))
마지막 네 줄이 사람들이 잊는 부분입니다. 작은 상태 파일이 없으면 스크립트는 남은 한 달 동안 매 실행마다 "50% 초과"를 외칠 것입니다. 상태 파일이 있으면 각 단계는 한 번만 발동합니다.
실행하고 결과 읽기#
네 줄짜리 장난감 로그를 가져옵시다(실제 로그는 요청당 한 줄이므로 수천 줄입니다):
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 2400000, "completion_tokens": 300000}
{"project": "agent", "model": "deepseek-ai/DeepSeek-V4-Flash-0731", "prompt_tokens": 1000000, "completion_tokens": 100000}
{"project": "blog", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 800000, "completion_tokens": 400000}
{"project": "bot", "model": "zai-org/GLM-5.3-Flash", "prompt_tokens": 500000, "completion_tokens": 100000}
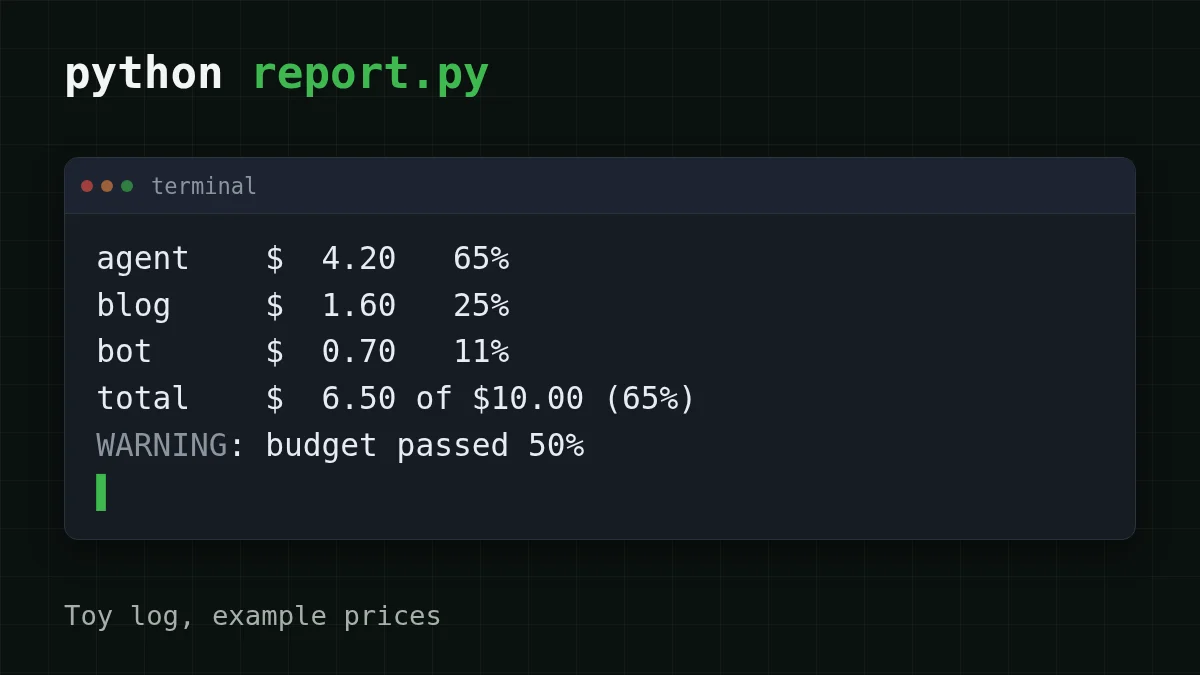
예시 가격과 예산 10으로 python report.py은 다음을 출력합니다:
agent    $  4.20   65%
blog     $  1.60   25%
bot      $  0.70   11%
total    $  6.50 of $10.00 (65%)
WARNING: budget passed 50%
에이전트가 청구서의 거의 3분의 2이고, 경고는 끝이 아니라 50%에서 나왔습니다. 다시 실행하면 총액이 75%에 도달할 때까지 경고는 조용히 있습니다.
매달 이것이 작동하게 하려면 세 단계가 필요합니다:
단계별로
세 단계로 연결하기
모든 호출 기록하기
모든 호출을 ask(project, model, messages)을 통해 라우팅하고 짧고 안정적인 프로젝트 레이블을 고르세요. 월 중간에 레이블 이름을 바꾸면 한 프로젝트가 두 행으로 쪼개집니다.
가격과 예산 설정하기
가격표의 현재 가격을 PRICES에 넣고 한도를 내보내세요: export BUDGET_.
일정에 따라 실행하기
매시간 cron 한 줄이면 충분합니다: 0 * * * * cd ~/. 경고를 직접 받고 싶다면 출력을 메일이나 채팅 명령으로 보내세요.
저렴한 모델에서 한 달은 어떤 모습인가#
숫자는 여러분의 숫자가 되면 유용해집니다. 장난감 로그의 에이전트가 단계당 평균 입력 30,000, 출력 2,000 토큰을 쓰고, 작업당 20단계, 하루 두 작업을 한다고 가정합시다. DeepSeek-V4-Flash에서 한 단계는 $0.00065이고, GLM-5.3-Flash에서는 $0.00068입니다. 하루는 40단계, 한 달은 1,200단계입니다. 슬라이더를 여러분의 에이전트에 맞게 움직이세요:
비용 계산기
에이전트의 하루: 작업당 단계 수 곱하기 하루 작업 수
요청당 입력 토큰: 30,000 · 요청당 출력 토큰: 2,000 · 일일 요청 수: 40
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0272 | $0.816 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.026 | $0.78 |
| MiniMax-M2.7$0.05$0.15 | $0.072 | $2.16 |
그리고 1,200단계의 한 달, 입력과 출력을 함께 계산하면:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,200회 요청 | OpenRouter, 1,200회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.816 | $1.41 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.78 | $2.86 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $2.16 | $25.92 |
요청당 입력 30,000개 및 출력 2,000개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
입력과 출력을 함께 계산한 총액에서 두 모델 모두 그 표의 OpenRouter 참조 가격보다 저렴하며, 어느 시간대든 가격이 하나이고 피크 할증이 없습니다. DeepSeek-V4-Flash는 답변당 최대 32,768 출력 토큰과 380K 컨텍스트를 허용하고, GLM-5.3-Flash는 390K 컨텍스트를 가집니다. 보고서가 어느 프로젝트가 무거운지 보여주면, 그 프로젝트의 model 문자열만 바꾸는 것이 한 줄 변경이며, 하나의 잔액이 모든 모델을 커버합니다. 단일 요청이 실제로 얼마나 많은 토큰을 쓰는지는 API 요청이 사용하는 토큰 수를, 에이전트 실행을 중간에 멈추는 방법은 AI 에이전트 토큰 비용 추적을 참고하세요. 가격과 모델은 CheapTokens 모델 페이지에 있습니다.
이 방법이 잘못되는 지점#
PRICES에 모델이 없음. 스크립트는 모델 이름을 밝히는KeyError과 함께 멈춥니다. 모델을 추가하세요; 0으로 기본값을 두지 마세요. 그러면 프로젝트가 무료처럼 보입니다.- 스트리밍 호출. 마지막 청크는 요청해야만 사용량을 담습니다(OpenAI SDK의
stream_). 그렇지 않으면 로그에 빈틈이 생깁니다.options={"include_ usage": True} - 실패한 요청.
usage객체가 있는 응답만 기록하세요; 오류로 끝난 요청은 셀 것이 없습니다. - 사람별 보고서. 레이블은 프로젝트나 에이전트 이름으로 유지하세요. 사람에 대한 보고서는 잘못된 결론을 부릅니다.


