AI per principiantiGuida
Limita il costo di un batch LLM in Python: un registro e un budget rigido
Registra token e costo di ogni chiamata API in un file JSONL, ferma il batch a un budget e stima il conto prima di eseguirlo. Codice Python incluso.
In questa pagina
Il tuo script esegue il loop su 200 prompt, chiudi il coperchio del portatile e al mattino scopri quanto è costata la notte. Due piccole abitudini risolvono il problema. Dopo ogni chiamata API, aggiungi una riga con token e costo a un file di registro. Prima di ogni chiamata, confronta il totale corrente con un budget e fermati se è stato raggiunto. Sono meno di 50 righe di Python, e un'esecuzione di prova con 5 prompt ti dice il conto prima che inizi l'esecuzione reale.
Cosa fa l'esecuzione di Clocktower che puoi copiare#
Dwarkesh Patel, host del Dwarkesh Podcast, ha fatto gareggiare 11 modelli l'uno contro l'altro in Blood on the Clocktower, 386 partite secondo il README, e ha pubblicato il codice, i log e le valutazioni (github.com/dwarkeshsp/clocktower, verificato l'8 novembre 2026). Due dettagli del repo vale la pena rubarli. Ogni directory di partita mantiene un log per chiamata con token e costo, e la spesa va in games/. Un flag --budget limita la spesa totale; il valore predefinito è $1.000. Il sito del benchmark aggiunge una terza protezione: ogni modello ha lo stesso tetto di 8.000 token per turno (clocktowerbench.com).
Quindi: un tetto su ogni chiamata, un log di ogni chiamata, un limite sul totale. Un torneo ha bisogno di tutti e tre, e anche la tua esecuzione notturna, solo più piccola.
Pensa al registro come al rotolo di ricevute nella cassa di un negozio. Ogni vendita stampa una riga; il manager può sommare il rotolo in qualsiasi momento e sa quando il fondo di cassa del giorno è finito.
Il registro: un file, una riga per chiamata#
Ecco tutto. Usa il pacchetto openai puntato su CheapTokens (https:/, vedi la documentazione per la chiave e gli id dei modelli).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
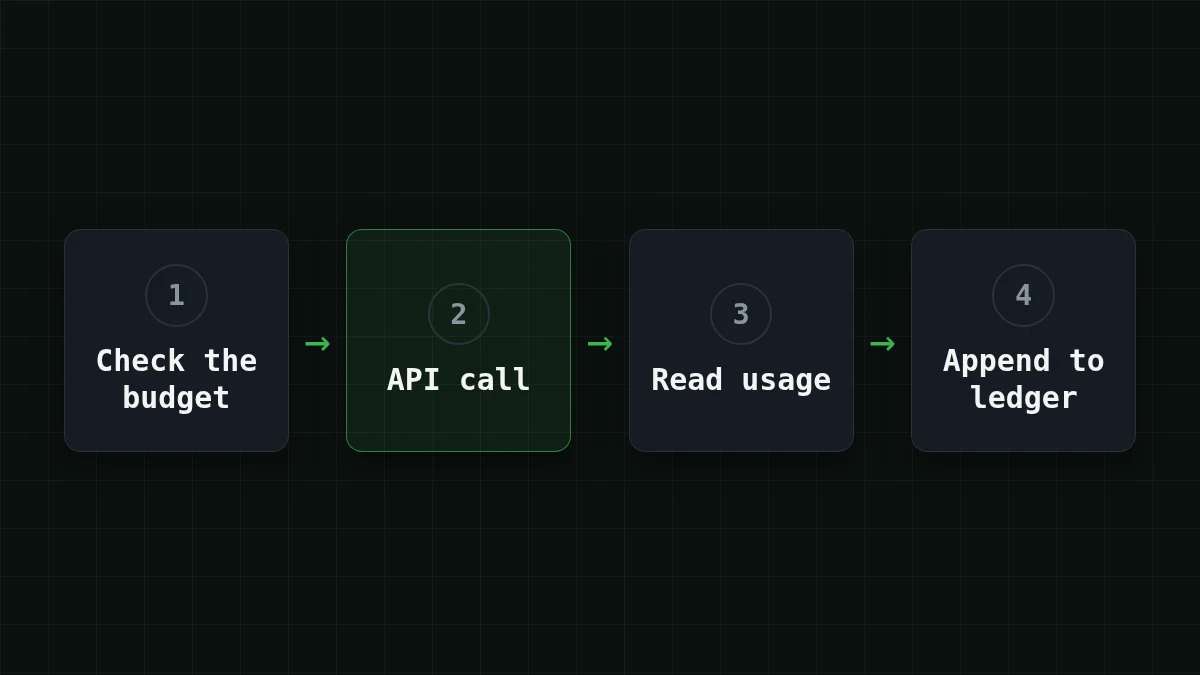
Ogni chiamata passa attraverso gli stessi quattro passaggi:
Tre scelte sono deliberate.
- Un oggetto JSON per riga (JSONL), aperto in modalità append. Se lo script va in crash alla chiamata 130, le chiamate da 1 a 129 sono già su disco.
- Il totale viene dal file, non da una variabile. Riavvia lo script e il limite tiene ancora, perché il registro ricorda quanto ha speso l'esecuzione precedente.
finish_reasonviene registrato accanto ai token. Una riga che dicelengthsignifica che la risposta ha raggiunto il tuomax_tokensed è stata troncata. Ti servirà saperlo dopo.
Le due costanti PRICE_ sono segnaposto. Prendi i numeri correnti dalla tabella dei prezzi. Per DeepSeek-V4-Flash al momento in cui leggi questo, sono $0.015 per 1M token di input e $0.10 per 1M token di output. Cambia MODEL in zai- o MiniMaxAI/ e le due costanti, e lo stesso registro funziona per loro.
Il ciclo batch: salta ciò che è fatto, fermati al limite#
Il ciclo è breve. Supponiamo che i tuoi prompt stiano in un dict con chiave un id di unità, il nome di un'unità di lavoro, come doc-001:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
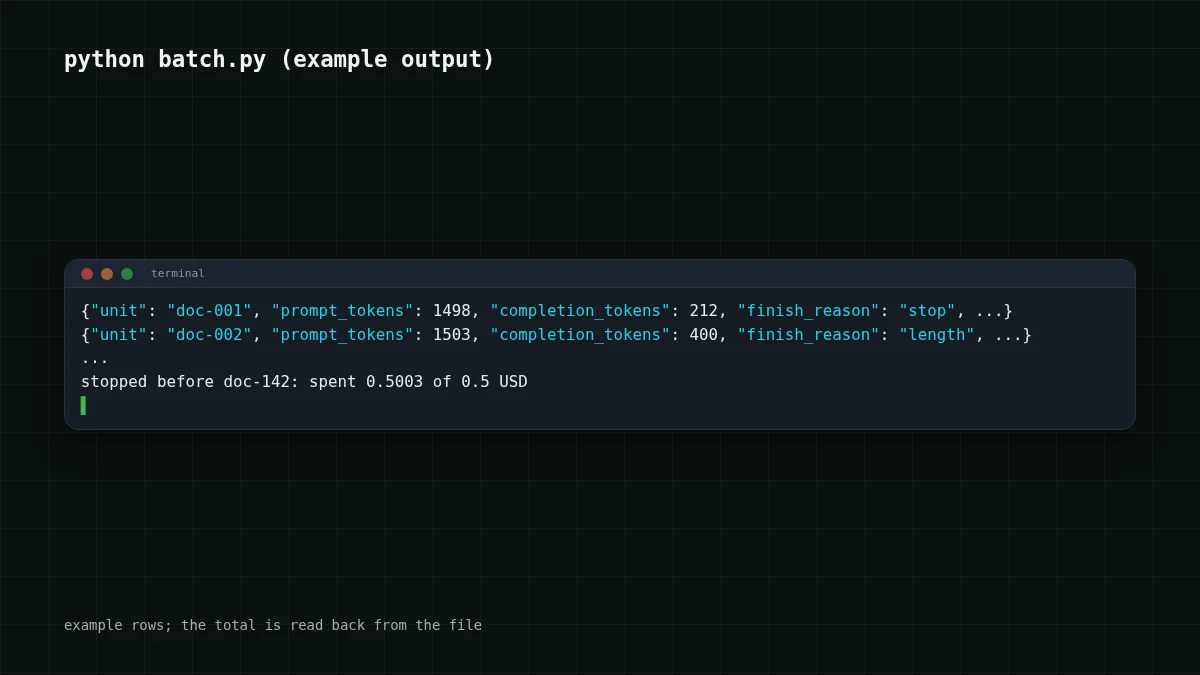
Esegui, premi Ctrl+C a metà, esegui di nuovo: le unità completate vengono saltate, quindi il registro funge anche da file di avanzamento. Lascia che il budget si esaurisca e ottieni una riga invece di una sorpresa, qualcosa come stopped before doc-.
Nota la parola prima. Il controllo avviene prima di ogni chiamata, quindi l'ultima chiamata può spingere il totale leggermente oltre il budget. Di quanto oltre è limitato: una chiamata non può costare più del tuo prompt più lungo più max_tokens. Per un prompt di 1.500 token e max_tokens=400 è al massimo $0.000063. Ecco perché ogni chiamata nel wrapper ha un max_tokens: trasforma un rischio illimitato in un numero su cui puoi pianificare.
Stima il conto prima di premere run#
Ora l'altra metà: conoscere il costo prima del lancio. Esegui i primi cinque prompt attraverso ask() con un budget piccolo e leggi il registro. Supponiamo che le cinque righe abbiano in media 1.500 token di input e 400 token di output. Quelli sono i tuoi numeri per l'intero batch.
Per 200 prompt sono 200 × 1.500 = 300.000 token di input e 200 × 400 = 80.000 token di output. Ecco quel carico sui prezzi live:
| Modello | Input $/1M | Output $/1M | Per richiesta | 200 richieste | OpenRouter, 200 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
1500 token di input e 400 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
La tabella ha anche una colonna OpenRouter. Con input e output contati insieme, DeepSeek-V4-Flash risulta più economico di OpenRouter per questo carico, e quella somma è ciò che il batch paga davvero.
I prompt differiscono in lunghezza, quindi cinque campioni sono una stima, non una promessa. Usa il più lungo dei cinque quando vuoi un limite superiore sicuro, poi lascia che il limite di budget catturi il resto. Vuoi confrontare due modelli sugli stessi 200 prompt? Dai a ogni modello il proprio file di registro, ad esempio Ledger(f'ledger-, e i due totali si affiancano dopo.
Prova il tuo batch qui: imposta i token per richiesta dal tuo campione e quante richieste prevedi.
Calcolatore di costi
Il tuo batch: token dal tuo campione di 5 prompt
Token di input per richiesta: 1500 · Token di output per richiesta: 400 · Richieste al giorno: 200
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
Per saperne di più sul conteggio dei token prima dell'invio, vedi conteggio dei token con tiktoken.
Quando il conto è più grande del previsto: leggi il registro#
Il terzo scenario del lettore è quello brutto. Un'esecuzione di un agente va storta e va in loop, e la dashboard mostra solo un totale. Il registro mostra dove è andata. Ordina le righe per costo:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
Per un agente, dai il nome all'unità in base al passo (step-17) così puoi vedere la forma dell'esecuzione. Alcuni pattern emergono ancora e ancora; abbina ciascuno alla sua causa abituale:
Abbina le coppie
Abbina ogni pattern del registro alla sua causa abituale
Tocca un elemento a sinistra, poi il suo abbinamento
- prompt_tokens cresce un po' su ogni rigaIl loop reinvia l'intera cronologia a ogni passo
- completion_tokens è uguale a max_tokens e finish_reason è lengthLe risposte sono troncate al tuo limite, e paghi per il testo troncato
- La stessa unità appare molte volte di seguitoUn loop di retry, o un agente che ripete un passo
- Una riga costa molto più di tutte le altreUn input sovradimensionato, come un intero file incollato nel prompt
Ogni pattern è visibile nel registro molto prima della fattura. Il primo è trattato in perché un agente rilegge la sua cronologia.
Se vuoi anche la spesa per progetto e avvisi fuori dallo script, questa guida agli avvisi di budget per progetto copre quel lato. Il registro qui è la parte che vive nel tuo codice e può dire stop.
Prima di lanciare#
Lista di controllo
Prima della prima esecuzione reale
La dimensione del contesto e il limite di risposta di DeepSeek-V4-Flash, utili quando scegli max_tokens, sono sulla sua pagina: DeepSeek-V4-Flash su CheapTokens.


