AI 입문가이드
Python으로 LLM 배치 비용 상한 설정하기: 원장과 하드 예산
모든 API 호출의 토큰과 비용을 JSONL 파일에 기록하고, 예산에서 배치를 중지하고, 실행 전에 청구서를 추정하세요. Python 코드 포함.
이 페이지의 내용
스크립트가 200개의 프롬프트를 반복 실행하고, 노트북 덮개를 닫고, 아침에 밤사이 비용이 얼마였는지 알게 됩니다. 두 가지 작은 습관이면 이 문제를 해결할 수 있습니다. 매 API 호출 후에 토큰과 비용을 원장 파일에 한 줄씩 추가하세요. 매 호출 전에 누적 합계를 예산과 비교하고, 예산에 도달하면 멈추세요. Python 50줄 미만이며, 5개 프롬프트 시험 실행으로 실제 실행 전에 청구서를 알 수 있습니다.
Clocktower 실행에서 따라 할 수 있는 것#
Dwarkesh Podcast의 진행자 Dwarkesh Patel은 Blood on the Clocktower에서 11개 모델을 서로 대결시켰고, README에 따르면 386게임을 진행했으며, 코드, 로그, 평점을 공개했습니다 (github.com/dwarkeshsp/clocktower, 2026년 11월 8일 확인). 저장소에서 훔칠 만한 세부 사항이 두 가지 있습니다. 각 게임 디렉터리는 토큰과 비용이 담긴 호출별 로그를 유지하고, 지출은 games/에 기록됩니다. --budget 플래그가 총 지출을 제한하며, 기본값은 $1,000입니다. 벤치마크 사이트는 세 번째 보호 장치를 추가합니다. 모든 모델은 턴당 동일한 8,000토큰 상한을 받습니다 (clocktowerbench.com).
즉, 각 호출에 대한 상한, 각 호출에 대한 로그, 총액에 대한 상한입니다. 토너먼트에는 세 가지가 모두 필요하며, 야간 실행에도 필요합니다. 다만 규모가 더 작을 뿐입니다.
원장은 상점 금전등록기의 영수증 롤이라고 생각하세요. 판매할 때마다 한 줄이 출력되고, 관리자는 언제든 롤을 합산하여 그날의 준비금이 언제 소진되는지 알 수 있습니다.
원장: 파일 하나, 호출당 한 줄#
전체 내용은 다음과 같습니다. CheapTokens를 가리키는 openai 패키지를 사용합니다 (https:/, 키와 모델 ID는 문서 참조).
import json
import os
from pathlib import Path

from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 1.00, 2.00  # USD per 1M tokens: example, substitute current ones


class BudgetExceeded(Exception):
    pass


class Ledger:
    def __init__(self, path, budget_usd):
        self.path = Path(path)
        self.budget = budget_usd
        self.rows = []
        if self.path.exists():
            with self.path.open() as f:
                self.rows = [json.loads(line) for line in f if line.strip()]

    @property
    def spent(self):
        return sum(r['cost_usd'] for r in self.rows)

    def done(self):
        return {r['unit'] for r in self.rows}

    def check(self, unit):
        if self.spent >= self.budget:
            raise BudgetExceeded(
                f'stopped before {unit}: spent {self.spent:.4f} of {self.budget} USD'
            )

    def add(self, unit, usage, finish_reason):
        cost = (usage.prompt_tokens * PRICE_IN
                + usage.completion_tokens * PRICE_OUT) / 1_000_000
        row = {
            'unit': unit,
            'model': MODEL,
            'prompt_tokens': usage.prompt_tokens,
            'completion_tokens': usage.completion_tokens,
            'finish_reason': finish_reason,
            'cost_usd': round(cost, 6),
        }
        self.rows.append(row)
        with self.path.open('a') as f:
            f.write(json.dumps(row) + '\n')


def ask(ledger, unit, prompt, max_tokens=400):
    ledger.check(unit)
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{'role': 'user', 'content': prompt}],
        max_tokens=max_tokens,
    )
    ledger.add(unit, resp.usage, resp.choices[0].finish_reason)
    return resp.choices[0].message.content
각 호출은 동일한 네 단계를 거칩니다:
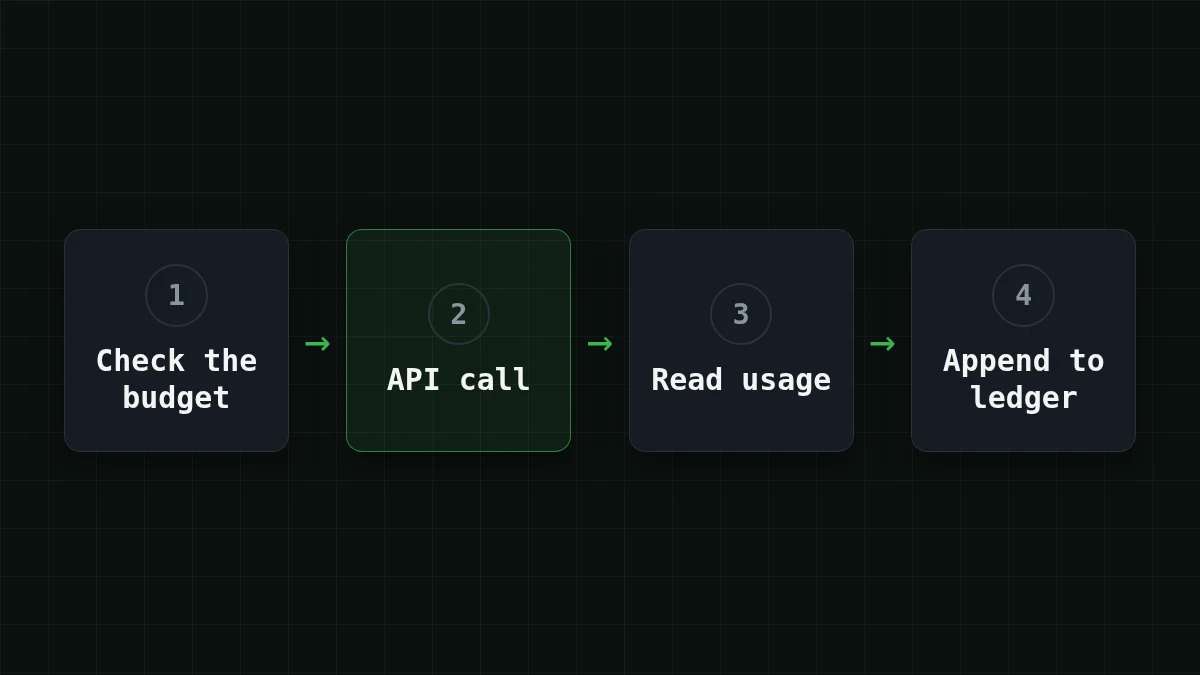
여기서 세 가지 선택은 의도적입니다.
- 줄당 하나의 JSON 객체(JSONL), 추가 모드로 열기. 스크립트가 130번째 호출에서 충돌해도 1~129번째 호출은 이미 디스크에 있습니다.
- 합계는 변수가 아니라 파일에서 가져옵니다. 스크립트를 다시 시작해도 상한이 유지됩니다. 원장이 이전 실행에서 지출한 내용을 기억하기 때문입니다.
finish_reason는 토큰 옆에 기록됩니다.length이라고 표시된 행은 응답이max_tokens에 도달하여 잘렸다는 뜻입니다. 나중에 이 사실을 알고 싶을 것입니다.
두 개의 PRICE_ 상수는 자리 표시자입니다. 현재 숫자는 가격표에서 가져오세요. 이 글을 읽는 시점의 DeepSeek-V4-Flash의 경우 1M 입력 토큰당 $0.015, 1M 출력 토큰당 $0.10입니다. MODEL를 zai- 또는 MiniMaxAI/로 바꾸고 두 상수를 바꾸면 동일한 원장이 그들에게도 작동합니다.
배치 루프: 완료된 것은 건너뛰고, 상한에서 멈추기#
루프는 짧습니다. 프롬프트가 작업 단위 ID를 키로 하는 딕셔너리에 있다고 가정해 봅시다. 예를 들어 doc-001 같은 것입니다:
prompts = {
    'doc-001': 'Summarize this ticket in one sentence: ...',
    'doc-002': 'Summarize this ticket in one sentence: ...',
    # ... your 200 prompts
}

ledger = Ledger('ledger.jsonl', budget_usd=0.50)
already = ledger.done()

for unit, prompt in prompts.items():
    if unit in already:
        continue
    try:
        answer = ask(ledger, unit, prompt)
    except BudgetExceeded as e:
        print(e)
        break
    Path(f'out-{unit}.txt').write_text(answer)
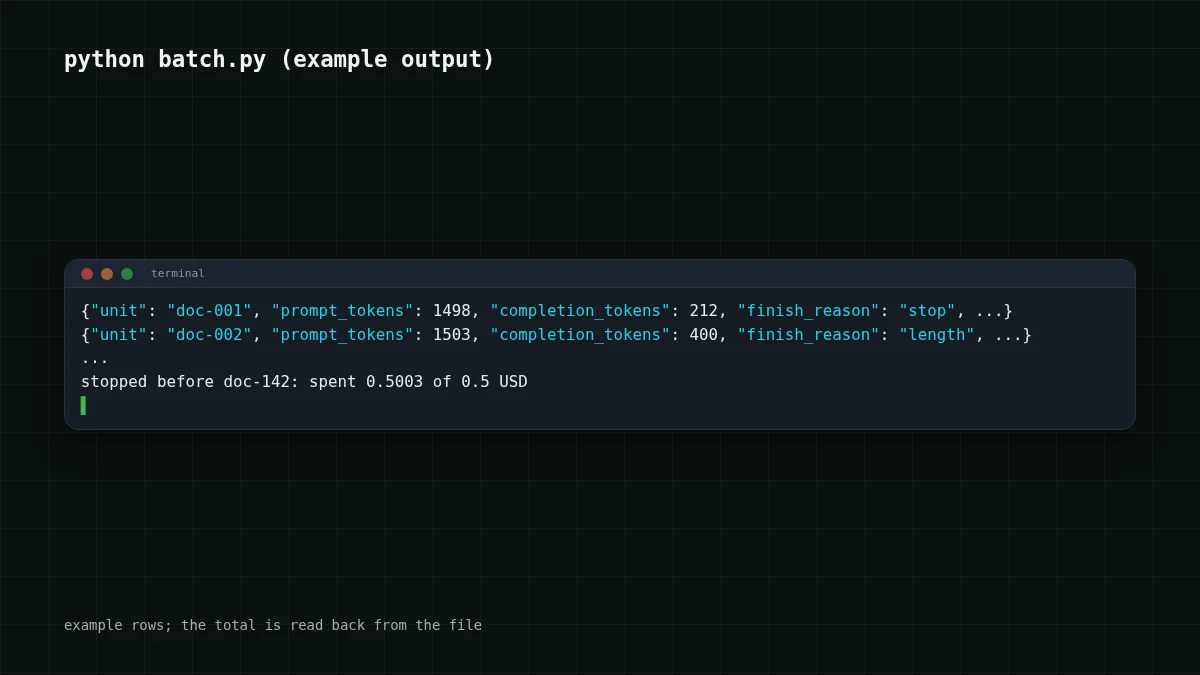
실행하고, 중간에 Ctrl+C를 누르고, 다시 실행하세요. 완료된 단위는 건너뛰므로 원장이 진행 파일 역할도 합니다. 예산이 소진되면 예상치 못한 일 대신 한 줄을 얻게 됩니다. 예를 들어 stopped before doc- 같은 것입니다.
전에라는 단어에 주목하세요. 확인은 각 호출 전에 이루어지므로 마지막 호출이 총액을 예산보다 약간 초과할 수 있습니다. 초과 폭은 제한됩니다. 한 번의 호출은 가장 긴 프롬프트에 max_tokens를 더한 것보다 더 많은 비용이 들 수 없습니다. 1,500토큰 프롬프트와 max_tokens=400의 경우 최대 $0.000063입니다. 그래서 래퍼의 모든 호출에 max_tokens가 있습니다. 끝없는 위험을 계획할 수 있는 숫자로 바꿔줍니다.
실행 버튼을 누르기 전에 청구서 추정하기#
이제 나머지 절반입니다. 실행 전에 비용을 아는 것입니다. 처음 5개 프롬프트를 작은 예산으로 ask()을 통해 실행하고 원장을 읽으세요. 5개 행의 평균이 입력 1,500토큰, 출력 400토큰이라고 가정해 봅시다. 이것이 전체 배치에 대한 숫자입니다.
200개 프롬프트의 경우 200 × 1,500 = 300,000 입력 토큰, 200 × 400 = 80,000 출력 토큰입니다. 다음은 실제 가격으로 계산한 해당 워크로드입니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 200회 요청 | OpenRouter, 200회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000046 | $0.0092 | $0.0167 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000063 | $0.0125 | $0.0322 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00014 | $0.027 | $0.324 |
요청당 입력 1,500개 및 출력 400개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
표에는 OpenRouter 열도 있습니다. 입력과 출력을 합산하면 DeepSeek-V4-Flash가 이 부하에서 OpenRouter보다 저렴하며, 그 합계가 배치가 실제로 지불하는 금액입니다.
프롬프트 길이가 다르므로 5개 샘플은 약속이 아니라 추측입니다. 안전한 상한을 원하면 5개 중 가장 긴 것을 사용하고, 나머지는 예산 상한이 잡도록 하세요. 동일한 200개 프롬프트에서 두 모델을 비교하고 싶으신가요? 각 모델에 자체 원장 파일을 주세요. 예를 들어 Ledger(f'ledger-처럼요. 그러면 나중에 두 합계를 나란히 볼 수 있습니다.
여기서 자신의 배치를 시험해 보세요: 샘플에서 요청당 토큰과 계획한 요청 수를 설정하세요.
비용 계산기
내 배치: 5개 프롬프트 샘플의 토큰
요청당 입력 토큰: 1,500 · 요청당 출력 토큰: 400 · 일일 요청 수: 200
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0092 | $0.276 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0125 | $0.375 |
| MiniMax-M2.7$0.05$0.15 | $0.027 | $0.81 |
전송 전에 토큰을 세는 방법에 대한 자세한 내용은 tiktoken으로 토큰 세기를 참조하세요.
청구서가 예상보다 클 때: 원장 읽기#
세 번째 독자 시나리오는 까다로운 경우입니다. 에이전트 실행이 잘못되어 루프에 빠지고, 대시보드는 총액만 보여줍니다. 원장은 어디서 발생했는지 보여줍니다. 행을 비용순으로 정렬하세요:
rows = [json.loads(line) for line in open('ledger.jsonl')]
for r in sorted(rows, key=lambda r: r['cost_usd'], reverse=True)[:5]:
    print(r['unit'], r['prompt_tokens'], r['completion_tokens'], r['finish_reason'])
에이전트의 경우 단위 이름을 단계 이름으로 지정하세요 (step-17). 그러면 실행의 형태를 볼 수 있습니다. 몇 가지 패턴이 반복적으로 나타납니다. 각 패턴을 일반적인 원인과 연결하세요:
짝 맞추기
각 원장 패턴을 일반적인 원인과 연결하세요
왼쪽 항목을 탭한 다음 짝을 탭하세요
- prompt_tokens가 행마다 조금씩 증가루프가 각 단계에서 전체 기록을 다시 전송함
- completion_tokens가 max_tokens와 같고 finish_reason이 length임응답이 상한에서 잘리고, 잘린 텍스트에 비용을 지불함
- 동일한 단위가 연속으로 여러 번 나타남재시도 루프 또는 에이전트가 한 단계를 반복함
- 한 행의 비용이 다른 모든 행보다 훨씬 큼하나의 과대 입력, 예를 들어 전체 파일을 프롬프트에 붙여넣음
각 패턴은 청구서보다 훨씬 전에 원장에서 보입니다. 첫 번째는 에이전트가 기록을 다시 읽는 이유에서 다룹니다.
스크립트 외부에서 프로젝트별 지출과 알림도 원한다면 프로젝트별 예산 알림 가이드가 그 부분을 다룹니다. 여기서 원장은 코드 안에 살면서 중지라고 말할 수 있는 부분입니다.
실행 전에#
체크리스트
첫 실제 실행 전에
max_tokens를 선택할 때 유용한 DeepSeek-V4-Flash의 컨텍스트 크기와 응답 한도는 해당 페이지에 있습니다: CheapTokens의 DeepSeek-V4-Flash.


