AI 입문가이드
AI 에이전트가 매 단계마다 전체 이력을 다시 읽는 이유
Claude Code 상태 표시줄 수정 사항은 긴 에이전트 세션이 왜 비싸지는지 보여줍니다. 모든 호출이 대화를 다시 보냅니다. 비용을 추정하고 줄이세요.
에이전트가 10분 동안 실행됐는데 청구서는 작업 규모에 비해 너무 큽니다. 거의 항상 이유는 같습니다. 모델은 호출 사이에 아무것도 기억하지 못하므로, 매 단계마다 지금까지의 전체 대화를 다시 입력으로 보냅니다. 50단계 세션은 첫 메시지에 대해 50번 비용을 지불하며, 그래서 비용이 실제 작업량보다 빠르게 증가합니다.
Anthropic이 2026년 11월 4~5일에 Claude Code용으로 발표한 수정 사항은 이를 작은 한 곳에서 보여줍니다. 아래에서는 무엇이 바뀌었는지, 50단계 루프의 산수, 그리고 이에 대해 무엇을 할 수 있는지 다룹니다.
모든 것을 다시 읽던 상태 표시줄#
Claude Code는 백그라운드 서브에이전트를 시작할 수 있습니다. 사용자가 계속 작업하는 동안 부수적인 작업을 처리하는 도우미 에이전트입니다. 각 서브에이전트는 '테스트 실행 중, 8개 중 3개 완료' 같은 한 줄 상태를 표시합니다.
X의 ClaudeDevs 계정이 변경 사항을 발표했습니다 (게시물 날짜는 2026년 11월 5일이며, 2차 보도에서는 11월 4일 또는 5일이라고 합니다). 상태는 30초마다 갱신되었고, 갱신할 때마다 서브에이전트의 전체 대화를 다시 읽었습니다. 이제 Haiku 5.5가 짧은 메모로부터 상태를 작성하며, Anthropic은 이를 갱신당 약 99% 더 저렴하다고 설명합니다. 이는 갱신당 수치이지 세션당 수치가 아닙니다. 서브에이전트의 실제 작업은 여전히 자신의 이력을 읽습니다.
예전 방식이 무엇을 의미했는지 그려 보세요. 서브에이전트가 20분 시점에 60,000토큰의 대화를 가지고 있다고 가정합니다. 상태 자체는 아마 30토큰일 것입니다. 하지만 그 30토큰을 작성하려면 모델이 60,000토큰 전부를 다시 읽어야 했고, 서브에이전트가 실행되는 동안 분당 두 번씩 읽어야 했습니다.
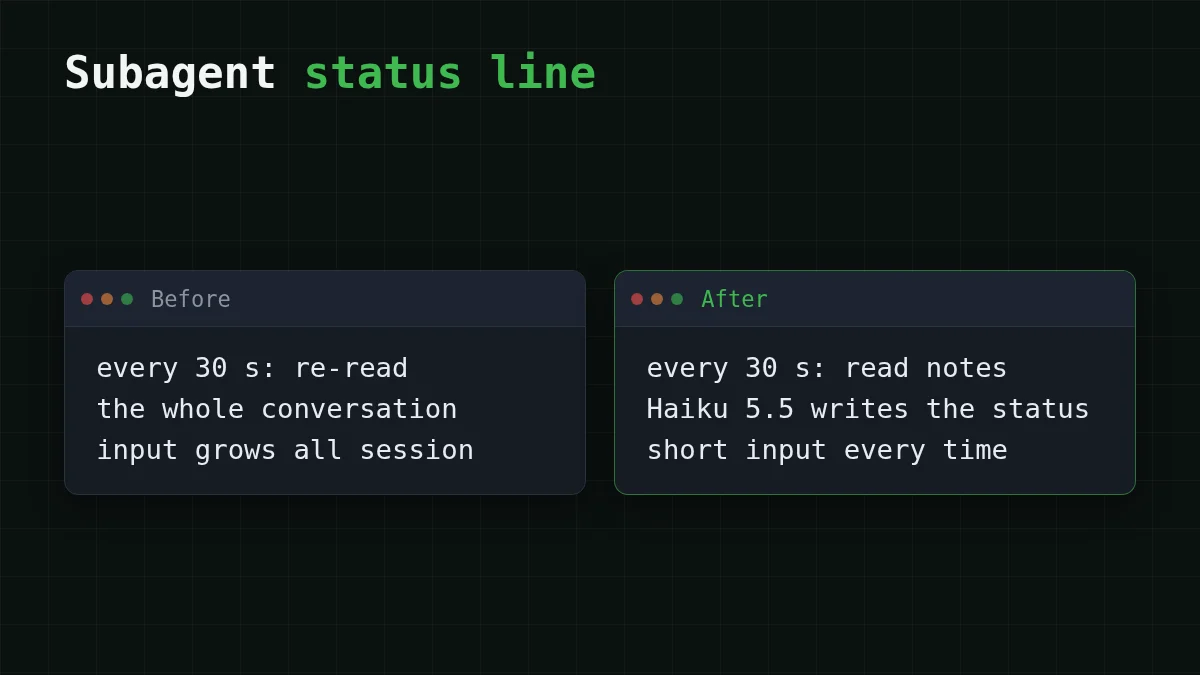
'running tests'라고 말하는 데 전체 대화 기록이 필요한 사람은 없습니다. 몇 줄의 메모(내가 하는 일, 끝난 일)면 충분합니다. 그것이 수정의 전부입니다. 부수 작업에는 대화 기록이 아니라 메모를 주는 것입니다.
왜 매 단계마다 이력을 다시 보내는가#
답장하는 순간 당신을 잊어버리는 사람에게 편지를 보낸다고 생각해 보세요. 계속하려면 전체 서신에 새 줄을 더해 다시 보내야 합니다. 에이전트 단계는 정확히 그런 호출입니다. 시스템 프롬프트, 작업, 모든 이전 답변과 모든 도구 결과가 다시 들어갑니다. (이 이야기의 채팅 버전은 긴 AI 채팅이 더 비싼 이유에 있습니다.)
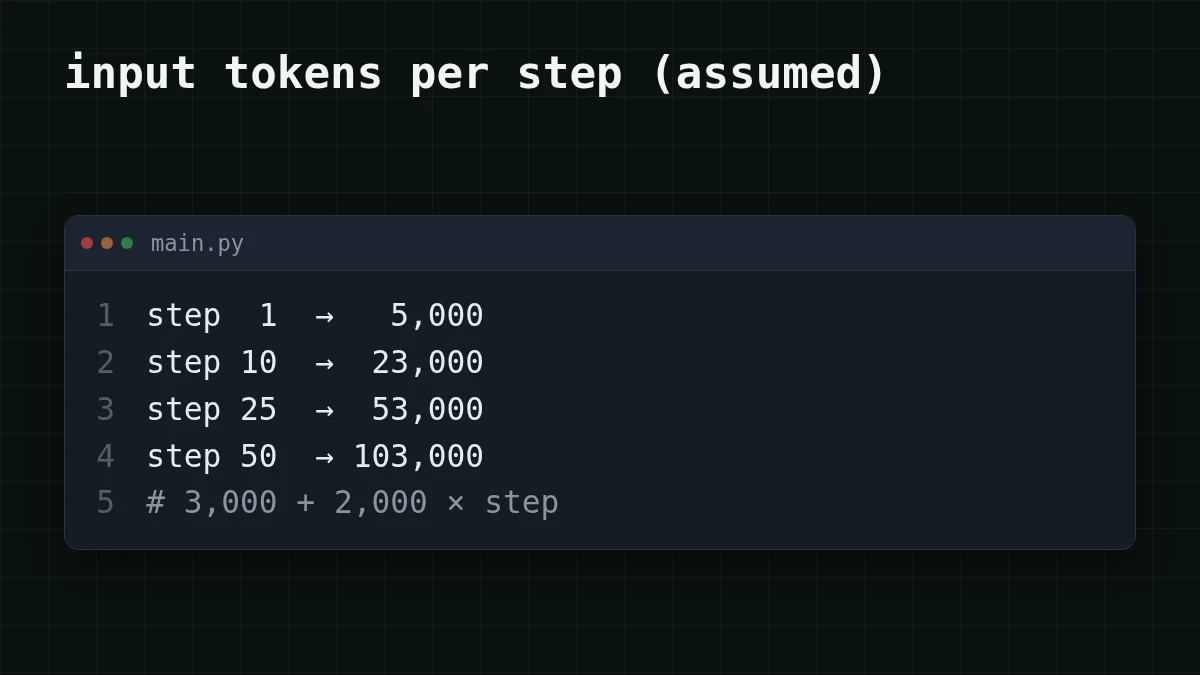
숫자를 넣어 봅시다. 시스템 프롬프트와 작업이 3,000토큰을 차지하고, 각 단계가 약 2,000토큰을 추가한다고 가정합니다(모델의 답변과 그것이 읽는 도구 출력). 그러면 n단계는 3,000 + 2,000 × n 토큰을 보냅니다. 1단계에서 5,000, 10단계에서 23,000, 50단계에서 103,000입니다.
숫자 맞히기
이 에이전트의 50단계는 입력 토큰을 몇 개 보낼까요?
내 추측
0200,000
정답 보기
정답: 103,000
3,000 + 2,000 × 50 = 103,000. 모델은 시작 프롬프트와 이전 49단계를 모두 다시 읽고, 그 위에 새 단계를 더합니다.
이제 50단계를 모두 더해 봅시다. 증가하는 부분은 2,000 × 1,275 = 2,550,000이며, 여기서 1,275는 1 + 2 + … + 50입니다. 매번 전송되는 시작 프롬프트는 50 × 3,000 = 150,000입니다. 합치면 150,000 + 2,550,000 = 2,700,000 입력 토큰입니다. 완성된 대화는 103,000토큰만 담고 있습니다. 103,000토큰의 대화 기록을 얻기 위해 270만 토큰을 모델에 밀어 넣은 것이며, 청구서는 첫 번째 숫자를 따릅니다.
비용은 얼마인가: 작업 하나, 하루#
같은 50단계 에이전트를 DeepSeek-V4-Flash에서 가격으로 계산해 봅시다. 평균 단계는 54,000토큰을 보내므로 총 54,000 × 50 = 2,700,000 입력 토큰이고, 단계당 약 400토큰을 작성합니다(400 × 50 = 20,000). 전체 작업 비용은 $0.0425입니다. 다음은 OpenRouter와 비교한, 보유한 모든 모델에서의 동일한 워크로드입니다:
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 50회 요청 | OpenRouter, 50회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
요청당 입력 54,000개 및 출력 400개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
표에서 모든 모델은 입력과 출력을 합산한 총액 기준으로 OpenRouter보다 저렴합니다.
이제 상태 표시줄입니다. 120회 갱신은 서브에이전트 하나의 1시간이며, 각 갱신은 약 30토큰을 작성합니다(30 × 120 = 3,600 출력). 예전 방식: 60,000 × 120 = 7,200,000 입력 토큰으로, 위의 50단계 작업 두 개 반이 넘는 양을 상태 텍스트에만 사용한 것입니다. 500토큰 메모를 사용하면 500 × 120 = 60,000입니다. GLM-5.3-Flash에서는 $0.0013 대비 $0.144입니다.
자신의 에이전트로 시도해 보세요: 단계당 토큰, 단계 수, 하루 작업 수.
비용 계산기
이러한 작업 10개로 이루어진 하루
요청당 입력 토큰: 54,000 · 요청당 출력 토큰: 400 · 일일 요청 수: 500
| 모델 | 일일 | 월간 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, 키, 첫 요청은 CheapTokens 문서에 있으며, 모든 모델의 현재 가격은 가격 페이지에 있습니다.
비용을 줄이는 네 가지 방법#
어느 것도 특별한 도구가 필요하지 않습니다. '이 호출에 정말 이력이 필요한가?'라고 묻는 습관입니다.
메모 패턴#
에이전트가 작업하는 동안 몇 줄의 메모를 유지하고, 상태나 요약이 필요할 때 그것만 작은 모델에 넘기세요. GLM-5.3-Flash(zai-, 390K 컨텍스트, 답변당 최대 8,192 출력 토큰)에서의 예입니다:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
짧은 한 줄을 돌려받고, 사용량 쌍은 입력이 수만 토큰이 아니라 수십 토큰임을 보여줍니다. Claude Code 변경 사항과 같은 아이디어를 십여 줄로 구현한 것입니다.
어떤 습관이 당신의 상황에 맞을까요?
사례 선택하기
당신의 상황은 무엇인가요?
답을 보려면 옵션을 선택하세요
한 세션에서 주제가 바뀌었을 때
새 세션을 시작하세요. 이전 대화 기록 대신 다섯 줄의 메모(목표, 완료된 것, 다음 할 일)를 붙여 넣으세요. 트리밍 옵션은 채팅 기록 트리밍: 슬라이딩 윈도우 또는 요약에 있습니다.
부수 작업: 상태, 요약, 제목
이력이 아니라 메모를 주고, 위 코드처럼 작은 모델로 보내세요.
거대한 도구 출력: 로그, 테스트 덤프
이력을 벗어나게 하세요. 전체 덤프가 아니라 마지막 20줄이나 실패한 테스트 하나만 보여 주세요. 유지하는 모든 줄은 이후 모든 단계에서 다시 전송됩니다. Claude Code 토큰 사용량: 도구 출력을 컨텍스트 밖에 두기에서 방법을 보여줍니다.
매 호출마다 같은 긴 프롬프트
프로바이더에게 프롬프트 캐싱을 문의하세요. 매번 새로 읽는 대신 반복되는 프롬프트 시작 부분을 재사용할 수 있습니다.
Claude Code를 사용한다면 업데이트하고 변경 로그에서 상태 표시줄 관련 내용을 확인하세요.
루프 자체에는 DeepSeek-V4-Flash(deepseek-)가 380K 컨텍스트, 답변당 최대 32,768 출력 토큰, 시간대와 무관한 단일 가격을 제공합니다. 예시의 103,000토큰 끝부분은 그 윈도우에 세 번 이상 들어갑니다. 메모와 요약에는 GLM-5.3-Flash를 사용하세요. 다른 모델은 모델 페이지에 있습니다.


