AI入門ガイド
なぜAIエージェントは毎ステップで履歴全体を読み直すのか
Claude Codeのステータス行の修正は、長いエージェントセッションがなぜ高くつくかを示している。呼び出しのたびに会話を再送している。コストを見積もり、削減しよう。
あなたのエージェントが10分間動いただけで、タスクの見た目より請求額が大きくなる。ほぼ必ず理由は同じだ。モデルは呼び出しの間で何も覚えていないため、各ステップでそれまでの会話全体を入力として再送している。50ステップのセッションは最初のメッセージに50回分を支払う。だからコストは作業量より速く増える。
Anthropicが2026年11月4〜5日にClaude Code向けに発表した修正は、このことを小さな一箇所で示している。以下では、何が変わったか、50ステップのループの計算、そしてそれに対して何ができるかを扱う。
すべてを読み直していたステータス行#
Claude Codeはバックグラウンドのサブエージェントを起動できる。あなたが作業を続ける間に脇の仕事を進める補助エージェントだ。それぞれが1行のステータスを表示する。たとえば「テスト実行中、8件中3件完了」のようなものだ。
XのClaudeDevsアカウントが変更を発表した(投稿の日付は2026年11月5日。二次報道では11月4日または5日とされている)。以前はステータスが30秒ごとに更新され、更新のたびにサブエージェントの会話全体を読み直していた。今はHaiku 5.5が短いメモからステータスを書き、Anthropicはそれを更新あたり約99%安くなるとしている。これは更新あたりの数字であり、セッションあたりではない。サブエージェントの実際の作業は依然として履歴を読む。
以前の方式が何を意味したか想像してほしい。サブエージェントが20分時点で60,000トークンの会話を持っているとする。ステータス自体はおそらく30トークンだ。しかしその30トークンを書くために、モデルは60,000トークンすべてを、1分に2回、サブエージェントが動いている間ずっと読み直さなければならなかった。
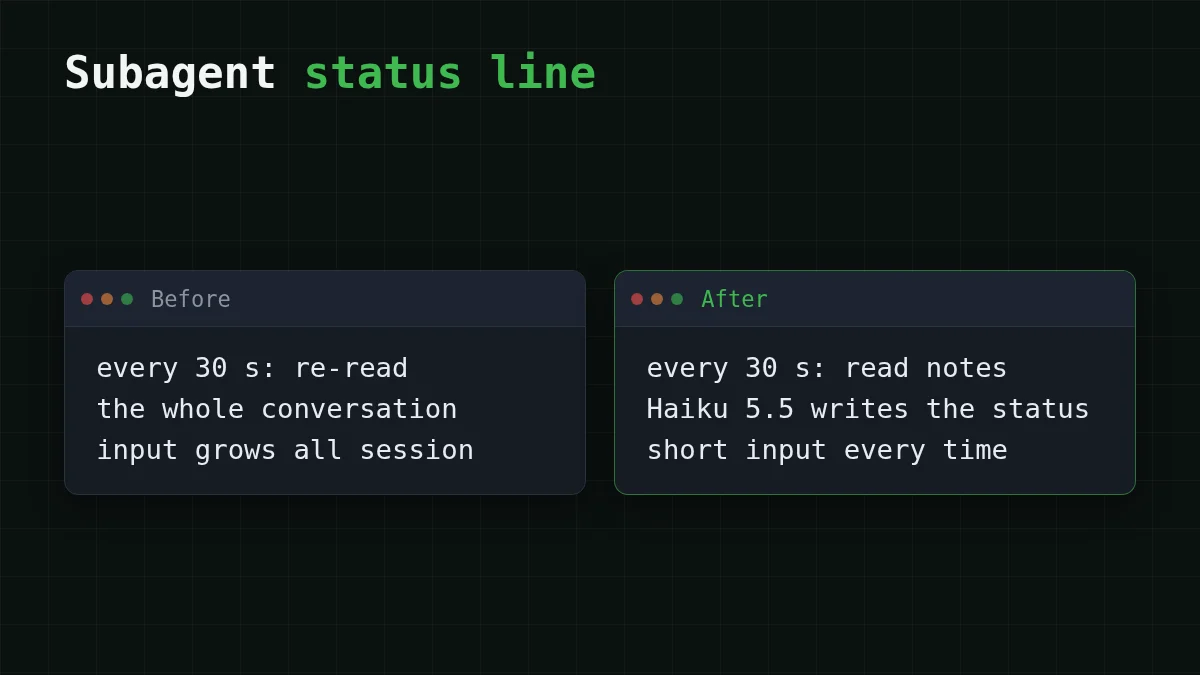
「テスト実行中」と言うのに完全な記録は誰も必要としない。数行のメモ(何をしているか、何が終わったか)で十分だ。それが修正のすべてだ。脇のタスクには記録ではなくメモを渡す。
なぜ各ステップが履歴を再送するのか#
返信した瞬間にあなたを忘れる相手への手紙を考えてほしい。続けるには、これまでのやり取り全体に新しい一行を加えて送り直す。エージェントのステップはまさにその呼び出しだ。システムプロンプト、あなたのタスク、それまでのすべての応答、すべてのツール結果が再び入力される。(この話のチャット版は長いAIチャットが高くつく理由にある。)
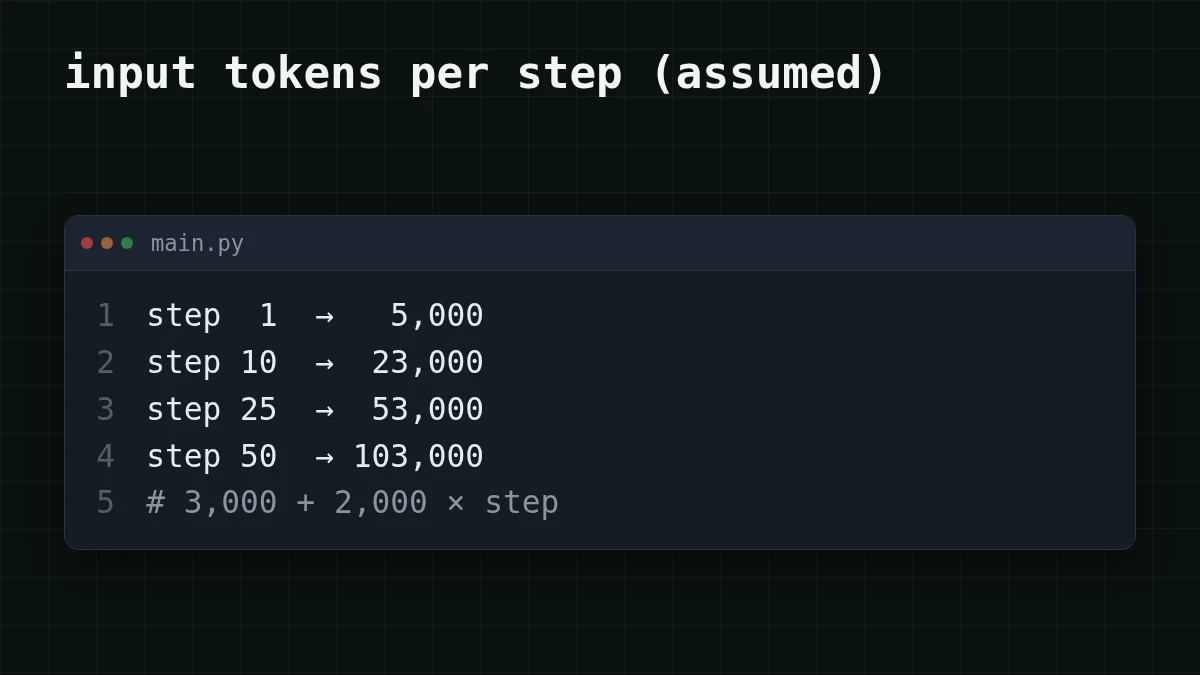
数字を当てはめてみよう。システムプロンプトとタスクで3,000トークン、各ステップが約2,000トークン(モデルの応答と読み取ったツール出力)を加えるとする。するとステップnは3,000 + 2,000 × nトークンを送る。ステップ1で5,000、ステップ10で23,000、ステップ50で103,000だ。
数字を当てる
このエージェントのステップ50は何トークンの入力を送るか?
あなたの予想
0200,000
答えを表示
答え: 103,000
3,000 + 2,000 × 50 = 103,000。モデルは開始プロンプトとそれ以前の49ステップすべてを読み直し、その上に新しいステップを加える。
次に50ステップすべてを合計する。増加する部分は2,000 × 1,275 = 2,550,000で、1,275は1 + 2 + … + 50だ。毎回送られる開始プロンプトは50 × 3,000 = 150,000。合わせて150,000 + 2,550,000 = 2,700,000入力トークンになる。完成した会話は103,000トークンしかない。103,000トークンの記録を得るために270万トークンをモデルに通したのであり、請求は最初の数字に従う。
いくらかかるか:1タスク、1日#
同じ50ステップのエージェントをDeepSeek-V4-Flashで価格計算する。平均ステップは54,000トークンを送るので、合計54,000 × 50 = 2,700,000入力トークンとなり、各ステップで約400トークンを書く(400 × 50 = 20,000)。タスク全体で$0.0425かかる。同じワークロードを全モデルで、OpenRouterと並べて示す:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 50 リクエスト | OpenRouter、50 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
リクエストあたり 54,000 入力トークンと 400 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
表では、入力と出力を合計すると、すべてのモデルがOpenRouterより安い。
次にステータス行。120回の更新は1つのサブエージェントの1時間分で、それぞれ約30トークンを書く(30 × 120 = 3,600出力)。以前の方式では60,000 × 120 = 7,200,000入力トークン、つまり上記の50ステップタスク2.5個分以上を、ステータステキストのためだけに費やしていた。500トークンのメモなら500 × 120 = 60,000だ。GLM-5.3-Flashでは$0.144対$0.0013になる。
自分のエージェントで試してみよう:1ステップあたりのトークン、ステップ数、1日あたりのタスク数。
コスト計算機
そのようなタスク10個の1日
リクエストあたりの入力トークン数: 54,000 · リクエストあたりの出力トークン数: 400 · 1日あたりのリクエスト数: 500
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
ベースURL、キー、最初のリクエストはCheapTokensのドキュメントにあり、全モデルの現在の価格は価格ページにある。
削減する4つの方法#
どれも特別なツールを必要としない。「この呼び出しは本当に履歴を必要とするか?」と問う習慣だ。
メモのパターン#
エージェントが動いている間、数行のメモを保ち、ステータスや要約が必要なときはそれだけを小さなモデルに渡す。GLM-5.3-Flash(zai-、390Kコンテキスト、1回答あたり最大8,192出力トークン)での例:
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
短い1行が返り、使用量のペアは入力が数万ではなく数十トークンであることを示す。これはClaude Codeの変更と同じ考えを十数行で表したものだ。
どの習慣があなたのケースに合うか?
ケースを選ぶ
あなたの状況は?
オプションを選択して答えを表示
1つのセッションで話題が変わった
新しいセッションを開始する。古い記録ではなく5行のメモ(目標、完了したこと、次にやること)を貼り付ける。トリミングの選択肢はチャット履歴のトリミング:スライディングウィンドウか要約かにある。
脇の仕事:ステータス、要約、タイトル
履歴ではなくメモを渡し、上のコードのように小さなモデルに送る。
巨大なツール出力:ログ、テストダンプ
履歴に入れない。ダンプ全体ではなく最後の20行か失敗したテスト1件だけを見せる。残した行はすべて以降の各ステップで再送される。Claude Codeのトークン使用量:ツール出力をコンテキストから外すに方法が示されている。
毎回同じ長いプロンプト
プロバイダーにプロンプトキャッシュについて尋ねる。毎回新しく読む代わりに、プロンプトの繰り返される先頭部分を再利用できる。
Claude Codeを使っているなら、更新して変更履歴でステータス行の記述を確認しよう。
ループ自体には、DeepSeek-V4-Flash(deepseek-)が380Kコンテキスト、1回答あたり最大32,768出力トークン、どの時間帯でも同一価格を提供する。例の終端の103,000トークンはそのウィンドウに3回以上収まる。メモと要約にはGLM-5.3-Flash。他のモデルはモデルページにある。


