IA pour débutantsGuide
Pourquoi un agent IA relit tout son historique à chaque étape
Un correctif de ligne de statut dans Claude Code montre pourquoi les longues sessions d'agent coûtent cher : chaque appel renvoie la conversation. Estimez le coût et réduisez-le.
Sur cette page
Votre agent a tourné pendant dix minutes, et la facture est plus grosse que la tâche n'en a l'air. Presque toujours, la raison est la même : le modèle ne se souvient de rien entre les appels, donc chaque étape renvoie toute la conversation jusqu'ici comme entrée. Une session de 50 étapes paie ses premiers messages 50 fois, ce qui explique pourquoi le coût croît plus vite que le travail effectué.
Un correctif qu'Anthropic a annoncé pour Claude Code les 4–5 novembre 2026 le montre en un petit endroit. Ci-dessous : ce qui a changé, l'arithmétique d'une boucle de 50 étapes, et ce que vous pouvez y faire.
Une ligne de statut qui relisait tout#
Claude Code peut lancer des sous-agents en arrière-plan : des agents auxiliaires qui travaillent sur une tâche annexe pendant que vous continuez. Chacun affiche un statut d'une ligne, du genre « running tests, 3 of 8 done ».
Le compte ClaudeDevs sur X a annoncé le changement (le post est daté du 5 novembre 2026 ; des rapports secondaires disent 4 ou 5 novembre). Le statut se rafraîchissait toutes les 30 secondes, et chaque rafraîchissement relisait toute la conversation du sous-agent. Désormais Haiku 5.5 écrit le statut à partir de notes courtes, et Anthropic estime cela environ 99 % moins cher par mise à jour. C'est un chiffre par mise à jour, pas par session : le vrai travail du sous-agent lit toujours son historique.
Imaginez ce que signifiait l'ancienne méthode. Disons qu'un sous-agent a 60 000 tokens de conversation à la vingtième minute. Le statut lui-même fait peut-être 30 tokens. Mais pour écrire ces 30 tokens, le modèle devait relire les 60 000, deux fois par minute, aussi longtemps que le sous-agent tournait.
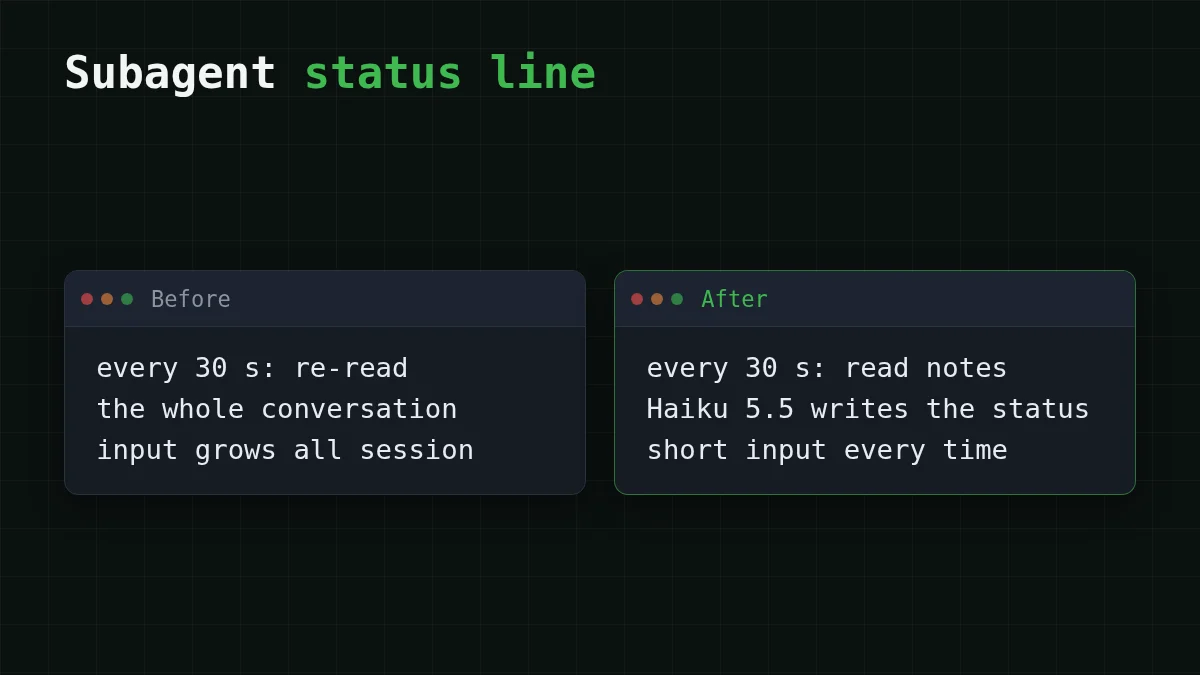
Personne n'a besoin de la transcription complète pour dire « running tests ». Quelques lignes de notes (ce que je fais, ce qui est terminé) suffisent. C'est tout le correctif : donner à une tâche annexe les notes, pas la transcription.
Pourquoi chaque étape renvoie l'historique#
Pensez à une lettre adressée à quelqu'un qui vous oublie dès qu'il répond. Pour continuer, vous renvoyez toute la correspondance plus la nouvelle ligne. Une étape d'agent est exactement cet appel : le prompt système, votre tâche, chaque réponse précédente et chaque résultat d'outil sont renvoyés. (La version chat de cette histoire est dans pourquoi un long chat IA coûte plus cher.)
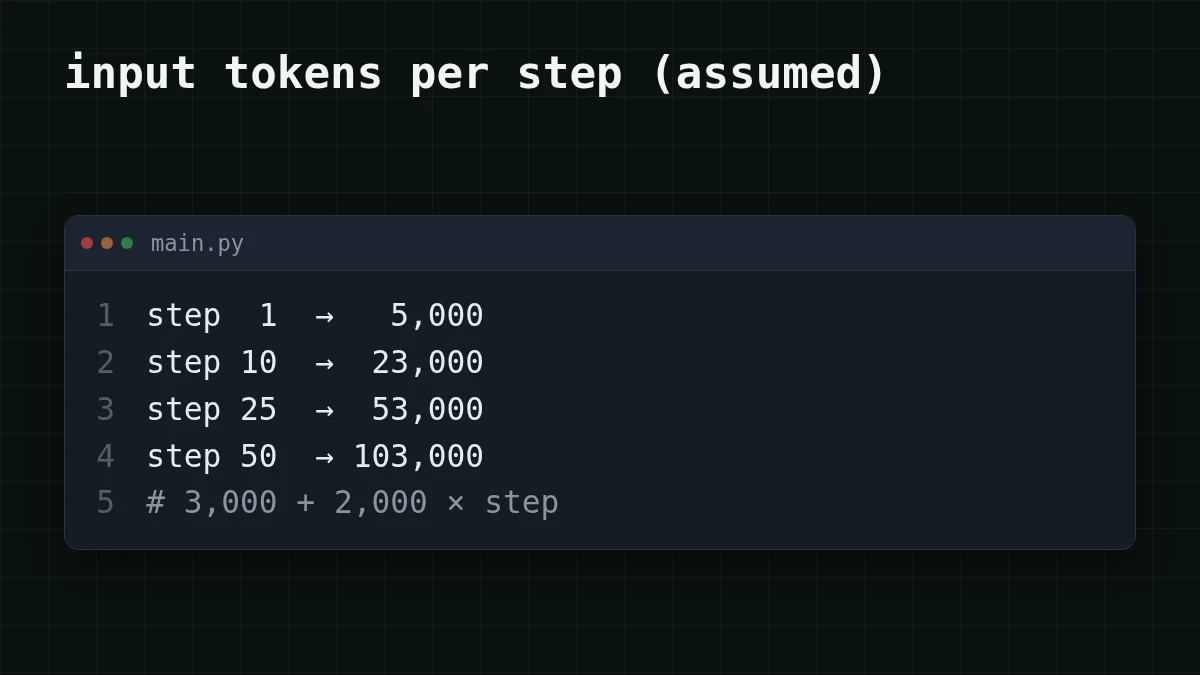
Mettons des chiffres. Disons que le prompt système et la tâche prennent 3 000 tokens, et que chaque étape en ajoute environ 2 000 (la réponse du modèle plus la sortie d'outil qu'il lit). L'étape n envoie alors 3 000 + 2 000 × n tokens : 5 000 à l'étape 1, 23 000 à l'étape 10, 103 000 à l'étape 50.
Devinez le nombre
Combien de tokens d'entrée l'étape 50 de cet agent envoie-t-elle ?
Votre estimation
0200 000
Afficher la réponse
Réponse: 103 000
3 000 + 2 000 × 50 = 103 000. Le modèle relit le prompt de départ et les 49 étapes précédentes, puis votre nouvelle étape par-dessus.
Maintenant, additionnez les 50 étapes. La partie croissante est 2,000 × 1,275 = 2,550,000, où 1 275 vaut 1 + 2 + … + 50. Le prompt de départ, envoyé à chaque fois, est 50 × 3,000 = 150,000. Ensemble : 150,000 + 2,550,000 = 2,700,000 tokens d'entrée. La conversation terminée ne contient que 103 000. Vous avez fait passer 2,7 millions de tokens dans le modèle pour obtenir une transcription de 103 000 tokens, et la facture suit le premier chiffre.
Ce que ça coûte : une tâche, un jour#
Tarifons le même agent de 50 étapes sur DeepSeek-V4-Flash. L'étape moyenne envoie 54 000 tokens, donc 54,000 × 50 = 2,700,000 tokens d'entrée au total, et il écrit environ 400 par étape (400 × 50 = 20,000). La tâche entière coûte $0.0425. Voici la même charge de travail sur chaque modèle dont nous disposons, à côté d'OpenRouter :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 50 requêtes | OpenRouter, 50 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54 000 tokens d'entrée et 400 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Dans le tableau, chaque modèle est moins cher qu'OpenRouter au total, entrée et sortie comptées ensemble.
Maintenant, la ligne de statut. 120 mises à jour, c'est une heure d'un sous-agent, et chacune écrit environ 30 tokens (30 × 120 = 3,600 en sortie). L'ancienne méthode : 60,000 × 120 = 7,200,000 tokens d'entrée, plus de deux fois et demie les tâches de 50 étapes ci-dessus, dépensés pour rien d'autre qu'un texte de statut. Avec une note de 500 tokens, c'est 500 × 120 = 60,000. Sur GLM-5.3-Flash, cela fait $0.144 contre $0.0013.
Essayez avec votre propre agent : tokens par étape, étapes et tâches par jour.
Calculateur de coût
Une journée de dix telles tâches
Tokens d'entrée par requête: 54 000 · Tokens de sortie par requête: 400 · Requêtes par jour: 500
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
L'URL de base, la clé et une première requête sont dans la doc CheapTokens ; les prix actuels de chaque modèle sont sur la page des tarifs.
Quatre façons de réduire#
Aucune ne nécessite d'outil spécial. C'est une habitude à prendre : cet appel a-t-il vraiment besoin de l'historique ?
Le motif des notes#
Gardez quelques lignes de notes pendant que l'agent travaille, et ne donnez que celles-ci à un petit modèle quand vous avez besoin d'un statut ou d'un résumé. Voici sur GLM-5.3-Flash (zai-, contexte de 390K, jusqu'à 8 192 tokens de sortie par réponse) :
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Vous récupérez une courte ligne, et la paire d'usage montre une entrée en dizaines de tokens, pas en dizaines de milliers. C'est la même idée que le changement de Claude Code, en une douzaine de lignes.
Quelle habitude convient à votre cas ?
Choisissez votre cas
Quelle est votre situation ?
Choisissez une option pour voir la réponse
Une session, le sujet a changé
Démarrez une nouvelle session. Collez cinq lignes de notes (objectif, ce qui est fait, ce qui suit) au lieu de l'ancienne transcription. Les options de découpage sont dans tronquer l'historique de chat : fenêtre glissante ou résumé.
Une tâche annexe : statut, résumé, titre
Donnez-lui les notes, pas l'historique, et envoyez-la à un petit modèle, comme dans le code ci-dessus.
Une sortie d'outil énorme : logs, dumps de tests
Gardez-la hors de l'historique. Montrez les 20 dernières lignes ou le seul test qui échoue, pas tout le dump : chaque ligne conservée est renvoyée à chaque étape suivante. Utilisation des tokens de Claude Code : garder la sortie d'outil hors du contexte montre comment.
Le même long prompt à chaque appel
Renseignez-vous auprès de votre fournisseur sur la mise en cache de prompt, qui peut réutiliser un début de prompt répété au lieu de le relire à chaque fois.
Si vous utilisez Claude Code, mettez-le à jour et parcourez le changelog pour la note sur la ligne de statut.
Pour la boucle elle-même, DeepSeek-V4-Flash (deepseek-) vous offre un contexte de 380K, jusqu'à 32 768 tokens de sortie par réponse et un prix à toute heure. Le bout de 103 000 tokens de notre exemple tient plus de trois fois dans cette fenêtre. Pour les notes et les résumés, GLM-5.3-Flash. Les autres modèles sont sur la page des modèles.


