AI untuk pemulaPanduan
Mengapa agen AI membaca ulang seluruh riwayatnya pada setiap langkah
Perbaikan baris status Claude Code menunjukkan mengapa sesi agen yang panjang menjadi mahal: setiap panggilan mengirim ulang percakapan. Perkirakan biayanya dan pangkas.
Di halaman ini
Agen Anda berjalan selama sepuluh menit, dan tagihannya lebih besar daripada yang terlihat dari tugasnya. Hampir selalu penyebabnya sama: model tidak mengingat apa pun di antara panggilan, jadi setiap langkah mengirim ulang seluruh percakapan sejauh ini sebagai input. Sesi 50 langkah membayar pesan pertamanya 50 kali, itulah sebabnya biaya tumbuh lebih cepat daripada pekerjaan yang dilakukan.
Perbaikan yang diumumkan Anthropic untuk Claude Code pada 4–5 November 2026 menunjukkan hal ini di satu tempat kecil. Berikut: apa yang berubah, aritmetika loop 50 langkah, dan apa yang bisa Anda lakukan.
Baris status yang membaca ulang semuanya#
Claude Code dapat menjalankan subagen latar belakang: agen pembantu yang mengerjakan tugas sampingan sementara Anda melanjutkan. Masing-masing menampilkan status satu baris, kira-kira 'menjalankan tes, 3 dari 8 selesai'.
Akun ClaudeDevs di X mengumumkan perubahan itu (postingan bertanggal 5 November 2026; laporan sekunder menyebut 4 atau 5 November). Statusnya dulu diperbarui setiap 30 detik, dan setiap pembaruan membaca ulang seluruh percakapan subagen. Sekarang Haiku 5.5 menulis status dari catatan singkat, dan Anthropic memperkirakan itu sekitar 99% lebih murah per pembaruan. Itu angka per pembaruan, bukan per sesi: pekerjaan nyata subagen tetap membaca riwayatnya.
Bayangkan apa arti cara lama. Katakanlah sebuah subagen memiliki 60.000 token percakapan pada menit kedua puluh. Statusnya sendiri mungkin 30 token. Tetapi untuk menulis 30 token itu, model harus membaca ulang semua 60.000, dua kali semenit, selama subagen berjalan.
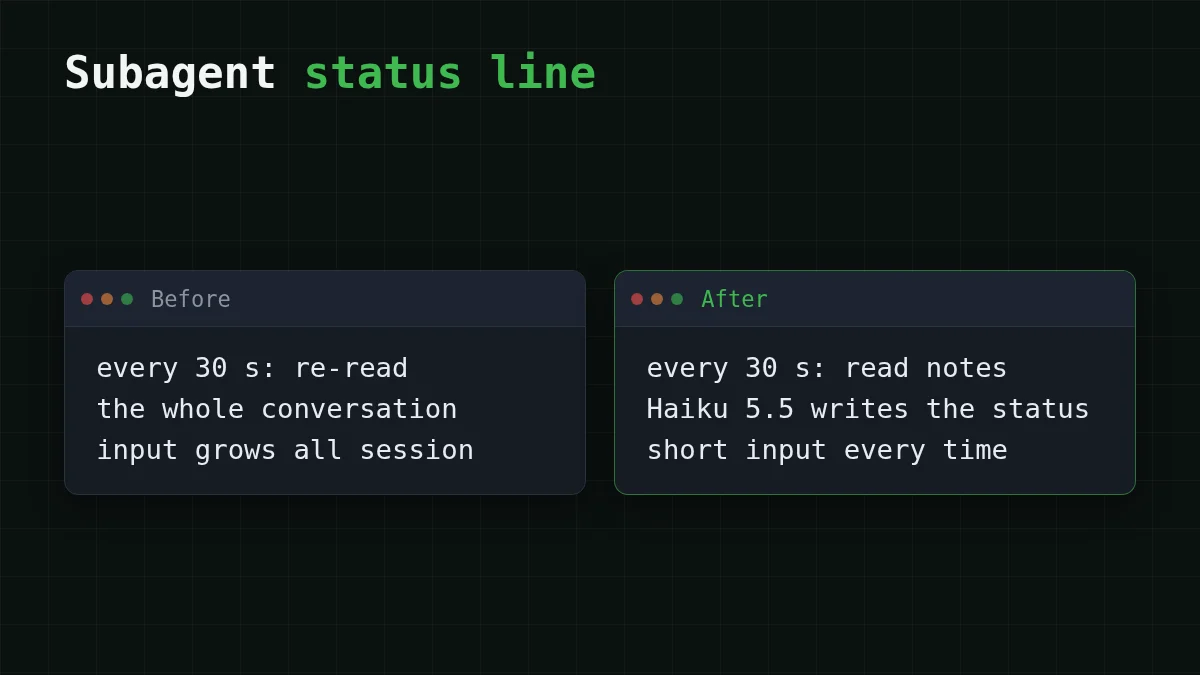
Tidak ada yang perlu transkrip lengkap untuk mengatakan 'menjalankan tes'. Beberapa baris catatan (apa yang sedang saya lakukan, apa yang sudah selesai) sudah cukup. Itulah seluruh perbaikannya: beri tugas sampingan catatannya, bukan transkripnya.
Mengapa setiap langkah mengirim ulang riwayat#
Bayangkan surat kepada seseorang yang melupakan Anda begitu mereka membalas. Untuk melanjutkan, Anda mengirim seluruh korespondensi lagi ditambah baris baru. Langkah agen persis seperti panggilan itu: system prompt, tugas Anda, setiap jawaban sebelumnya dan setiap hasil tool masuk lagi. (Versi obrolan dari cerita ini ada di mengapa obrolan AI yang panjang lebih mahal.)
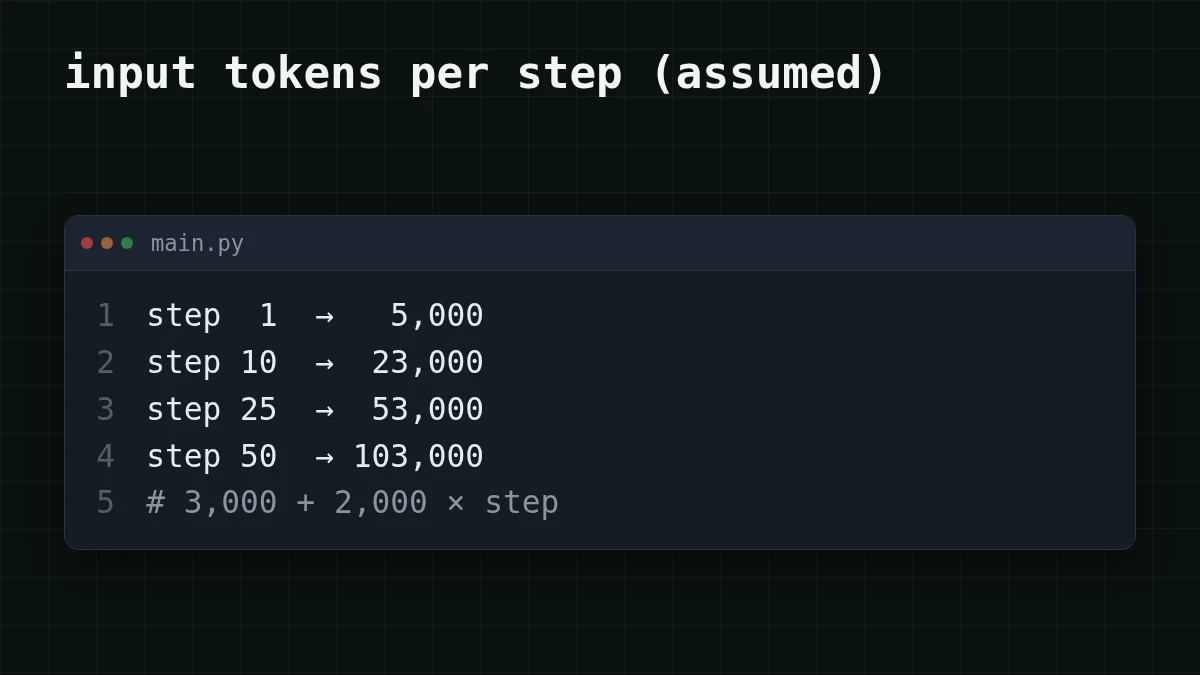
Mari kita beri angka. Katakanlah system prompt dan tugas memakan 3.000 token, dan setiap langkah menambah sekitar 2.000 (balasan model ditambah output tool yang dibacanya). Langkah n lalu mengirim 3.000 + 2.000 × n token: 5.000 pada langkah 1, 23.000 pada langkah 10, 103.000 pada langkah 50.
Tebak angkanya
Berapa banyak token input yang dikirim langkah 50 agen ini?
Tebakan Anda
0200.000
Tampilkan jawaban
Jawaban: 103.000
3.000 + 2.000 × 50 = 103.000. Model membaca ulang prompt awal dan semua 49 langkah sebelumnya, lalu langkah baru Anda di atasnya.
Sekarang jumlahkan semua 50 langkah. Bagian yang tumbuh adalah 2,000 × 1,275 = 2,550,000, di mana 1.275 adalah 1 + 2 + … + 50. Prompt awal, yang dikirim setiap kali, adalah 50 × 3,000 = 150,000. Bersama-sama: 150,000 + 2,550,000 = 2,700,000 token input. Percakapan yang selesai hanya berisi 103.000. Anda mendorong 2,7 juta token melalui model untuk mendapatkan transkrip 103.000 token, dan tagihannya mengikuti angka pertama.
Berapa biayanya: satu tugas, satu hari#
Hitung harga agen 50 langkah yang sama pada DeepSeek-V4-Flash. Langkah rata-rata mengirim 54.000 token, jadi 54,000 × 50 = 2,700,000 token input totalnya, dan menulis sekitar 400 per langkah (400 × 50 = 20,000). Seluruh tugas berbiaya $0.0425. Berikut beban kerja yang sama pada setiap model yang kami miliki, di samping OpenRouter:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 50 permintaan | OpenRouter, 50 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 token input dan 400 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Dalam tabel, setiap model lebih murah daripada OpenRouter secara total, dengan input dan output dihitung bersama.
Sekarang baris status. 120 pembaruan adalah satu jam dari satu subagen, dan masing-masing menulis sekitar 30 token (30 × 120 = 3,600 output). Cara lama: 60,000 × 120 = 7,200,000 token input, lebih dari dua setengah tugas 50 langkah di atas, dihabiskan untuk tidak lain hanya teks status. Dengan catatan 500 token menjadi 500 × 120 = 60,000. Pada GLM-5.3-Flash itu $0.144 dibandingkan $0.0013.
Coba agen Anda sendiri: token per langkah, langkah dan tugas per hari.
Kalkulator biaya
Sehari sepuluh tugas seperti itu
Token input per permintaan: 54.000 · Token output per permintaan: 400 · Permintaan per hari: 500
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, key dan permintaan pertama ada di dokumentasi CheapTokens; harga terkini untuk setiap model ada di halaman harga.
Empat cara memangkasnya#
Tidak satu pun dari ini membutuhkan tool khusus. Ini kebiasaan bertanya: apakah panggilan ini benar-benar membutuhkan riwayat?
Pola catatan#
Simpan beberapa baris catatan saat agen bekerja, dan berikan hanya itu ke model kecil ketika Anda membutuhkan status atau ringkasan. Berikut pada GLM-5.3-Flash (zai-, konteks 390K, hingga 8.192 token output per jawaban):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Anda mendapat kembali satu baris singkat, dan pasangan usage menunjukkan input dalam puluhan token, bukan puluhan ribu. Itu ide yang sama dengan perubahan Claude Code, dalam selusin baris.
Kebiasaan mana yang cocok untuk kasus Anda?
Pilih kasus Anda
Bagaimana situasi Anda?
Pilih opsi untuk melihat jawabannya
Satu sesi, topiknya berubah
Mulai sesi baru. Tempelkan lima baris catatan (tujuan, apa yang sudah selesai, apa selanjutnya) alih-alih transkrip lama. Opsi pemangkasan ada di memangkas riwayat obrolan: sliding window atau ringkasan.
Tugas sampingan: status, ringkasan, judul
Beri catatannya, bukan riwayatnya, dan kirim ke model kecil, seperti pada kode di atas.
Output tool yang besar: log, dump tes
Jauhkan dari riwayat. Tampilkan 20 baris terakhir atau satu tes yang gagal, bukan seluruh dump: setiap baris yang Anda simpan dikirim ulang pada setiap langkah berikutnya. Penggunaan token Claude Code: jauhkan output tool dari konteks menunjukkan caranya.
Prompt panjang yang sama pada setiap panggilan
Tanyakan kepada penyedia Anda tentang prompt caching, yang dapat menggunakan ulang awal prompt yang berulang alih-alih membacanya baru setiap kali.
Jika Anda menggunakan Claude Code, perbarui dan telusuri changelog untuk catatan baris status.
Untuk loop itu sendiri, DeepSeek-V4-Flash (deepseek-) memberi Anda konteks 380K, hingga 32.768 token output per jawaban dan satu harga pada jam berapa pun. Ujung 103.000 token dari contoh kami muat di jendela itu lebih dari tiga kali. Untuk catatan dan ringkasan, GLM-5.3-Flash. Model lain ada di halaman model.


