AI สำหรับผู้เริ่มต้นคู่มือ
ทำไมเอเจนต์ AI จึงอ่านประวัติทั้งหมดซ้ำในทุกขั้นตอน
การแก้ไขบรรทัดสถานะของ Claude Code แสดงให้เห็นว่าทำไมเซสชันเอเจนต์ยาว ๆ จึงมีค่าใช้จ่ายสูง: ทุกการเรียกส่งบทสนทนาซ้ำ ประเมินค่าใช้จ่ายและลดมัน
ในหน้านี้
เอเจนต์ของคุณทำงานสิบนาที แต่บิลกลับสูงกว่างานที่ดูเหมือนจะเป็นเกือบทุกครั้งเหตุผลก็เหมือนเดิม: โมเดลไม่จำอะไรเลยระหว่างการเรียกแต่ละครั้ง ดังนั้นทุกขั้นตอนจึงส่งบทสนทนาทั้งหมดที่ผ่านมาเป็นอินพุตอีกครั้ง เซสชัน 50 ขั้นตอนจ่ายค่าข้อความแรก 50 ครั้ง นี่คือเหตุผลที่ค่าใช้จ่ายโตเร็วกว่างานที่ทำ
การแก้ไขที่ Anthropic ประกาศสำหรับ Claude Code เมื่อวันที่ 4–5 พฤศจิกายน 2026 แสดงให้เห็นในจุดเล็ก ๆ จุดหนึ่ง ด้านล่าง: สิ่งที่เปลี่ยนไป เลขคณิตของลูป 50 ขั้นตอน และสิ่งที่คุณทำได้
บรรทัดสถานะที่อ่านทุกอย่างซ้ำ#
Claude Code สามารถเริ่มซับเอเจนต์เบื้องหลังได้: เอเจนต์ผู้ช่วยที่ทำงานข้างเคียงขณะที่คุณทำงานต่อ แต่ละตัวแสดงสถานะหนึ่งบรรทัด เช่น 'running tests, 3 of 8 done'
บัญชี ClaudeDevs บน X ประกาศการเปลี่ยนแปลง (โพสต์ลงวันที่ 5 พฤศจิกายน 2026; รายงานทุติยภูมิบอกว่า 4 หรือ 5 พฤศจิกายน) เดิมสถานะรีเฟรชทุก 30 วินาที และแต่ละครั้งอ่านบทสนทนาทั้งหมดของซับเอเจนต์ใหม่ ตอนนี้ Haiku 5.5 เขียนสถานะจากบันทึกสั้น ๆ และ Anthropic ระบุว่าถูกลงประมาณ 99% ต่อการอัปเดต นั่นคือตัวเลขต่อการอัปเดต ไม่ใช่ต่อเซสชัน: งานจริงของซับเอเจนต์ยังคงอ่านประวัติของมัน
ลองนึกภาพว่าวิธีเดิมหมายถึงอะไร สมมติซับเอเจนต์มีบทสนทนา 60,000 โทเคนภายในนาทีที่ยี่สิบ ตัวสถานะเองอาจมีแค่ 30 โทเคน แต่การจะเขียน 30 โทเคนนั้น โมเดลต้องอ่านทั้งหมด 60,000 โทเคนอีกครั้ง สองครั้งต่อนาที ตลอดเวลาที่ซับเอเจนต์ทำงาน
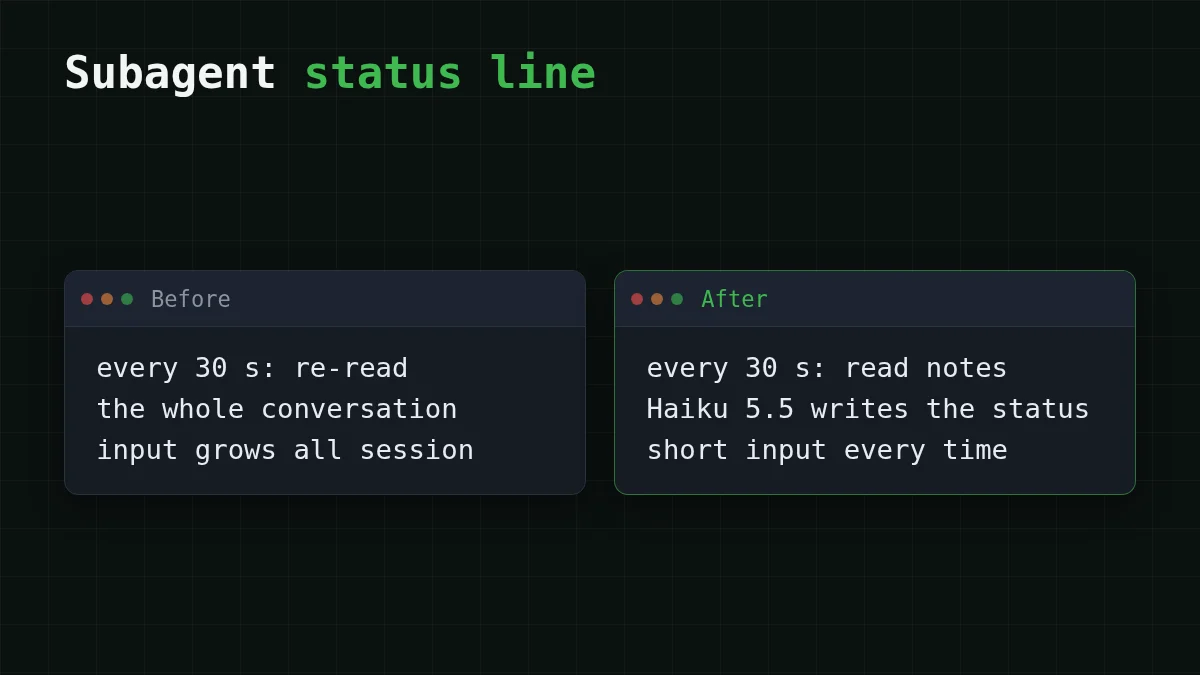
ไม่มีใครต้องใช้บทสนทนาทั้งหมดเพื่อพูดว่า 'running tests' บันทึกไม่กี่บรรทัด (กำลังทำอะไร อะไรเสร็จแล้ว) ก็เพียงพอ นั่นคือการแก้ไขทั้งหมด: ให้บันทึกกับงานข้างเคียง ไม่ใช่บทสนทนาทั้งหมด
ทำไมทุกขั้นตอนจึงส่งประวัติซ้ำ#
ลองนึกถึงจดหมายถึงคนที่ลืมคุณทันทีที่ตอบกลับ หากต้องการคุยต่อ คุณต้องส่งจดหมายทั้งหมดอีกครั้งพร้อมบรรทัดใหม่ ขั้นตอนของเอเจนต์คือการเรียกแบบนั้นเป๊ะ ๆ: system prompt งานของคุณ ทุกคำตอบก่อนหน้า และทุกผลลัพธ์จากเครื่องมือถูกส่งเข้าไปใหม่ (เวอร์ชันแชตของเรื่องนี้อยู่ใน ทำไมแชต AI ยาว ๆ จึงมีค่าใช้จ่ายสูงขึ้น)
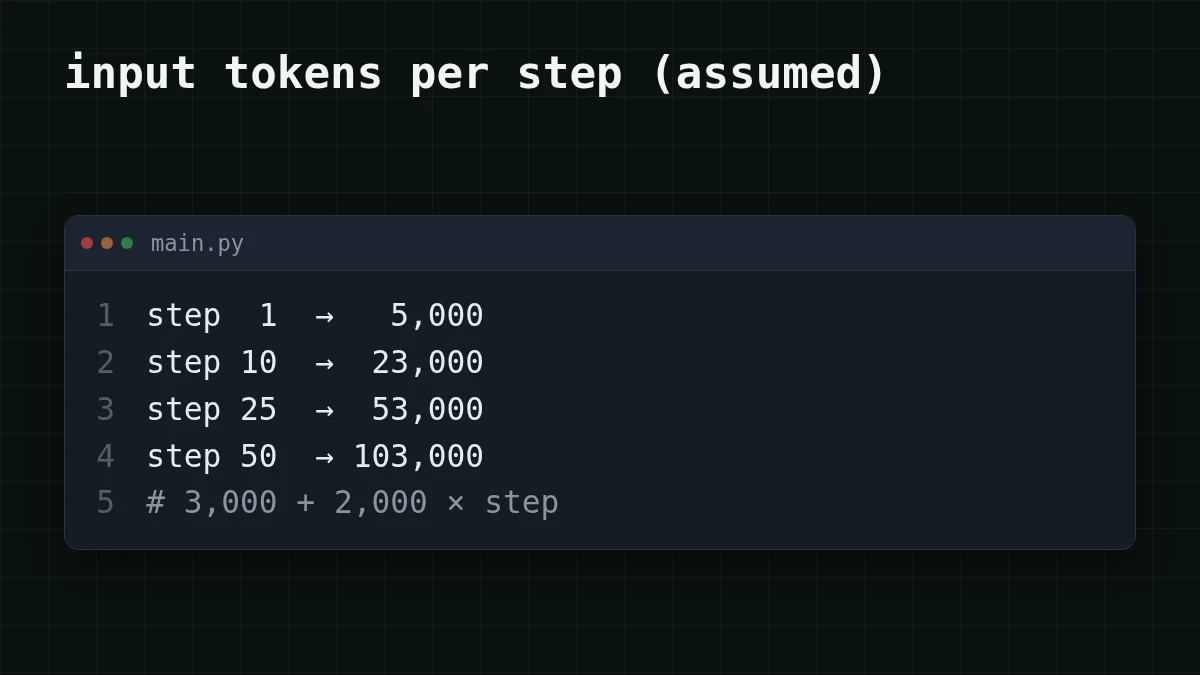
มาใส่ตัวเลขกัน สมมติ system prompt และงานใช้ 3,000 โทเคน และแต่ละขั้นตอนเพิ่มประมาณ 2,000 (คำตอบของโมเดลบวกผลลัพธ์เครื่องมือที่อ่าน) ขั้นตอนที่ n จึงส่ง 3,000 + 2,000 × n โทเคน: 5,000 ที่ขั้นตอนที่ 1, 23,000 ที่ขั้นตอนที่ 10, 103,000 ที่ขั้นตอนที่ 50
ทายตัวเลข
ขั้นตอนที่ 50 ของเอเจนต์นี้ส่งโทเคนอินพุตกี่โทเคน?
คำตอบของคุณ
0200,000
แสดงคำตอบ
คำตอบ: 103,000
3,000 + 2,000 × 50 = 103,000 โมเดลอ่าน prompt เริ่มต้นและทั้ง 49 ขั้นตอนก่อนหน้าซ้ำ แล้วจึงเพิ่มขั้นตอนใหม่ของคุณ
ตอนนี้รวมทั้ง 50 ขั้นตอน ส่วนที่โตคือ 2,000 × 1,275 = 2,550,000 โดย 1,275 คือ 1 + 2 + … + 50 prompt เริ่มต้นที่ส่งทุกครั้งคือ 50 × 3,000 = 150,000 รวมกัน: 150,000 + 2,550,000 = 2,700,000 โทเคนอินพุต บทสนทนาที่เสร็จแล้วมีเพียง 103,000 คุณผลัก 2.7 ล้านโทเคนผ่านโมเดลเพื่อให้ได้บทสนทนา 103,000 โทเคน และบิลก็ตามตัวเลขแรก
ค่าใช้จ่าย: หนึ่งงาน หนึ่งวัน#
คิดราคาเอเจนต์ 50 ขั้นตอนเดียวกันบน DeepSeek-V4-Flash ขั้นตอนเฉลี่ยส่ง 54,000 โทเคน ดังนั้น 54,000 × 50 = 2,700,000 โทเคนอินพุตทั้งหมด และเขียนประมาณ 400 ต่อขั้นตอน (400 × 50 = 20,000) งานทั้งหมดมีค่าใช้จ่าย $0.0425 นี่คือภาระงานเดียวกันบนทุกโมเดลที่เรามี เทียบกับ OpenRouter:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 50 คำขอ | OpenRouter, 50 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54,000 โทเค็นอินพุตและ 400 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ในตาราง ทุกโมเดลถูกกว่า OpenRouter ในภาพรวม โดยนับอินพุตและเอาต์พุตรวมกัน
ตอนนี้มาดูบรรทัดสถานะ 120 การอัปเดตคือหนึ่งชั่วโมงของซับเอเจนต์หนึ่งตัว และแต่ละครั้งเขียนประมาณ 30 โทเคน (30 × 120 = 3,600 เอาต์พุต) วิธีเดิม: 60,000 × 120 = 7,200,000 โทเคนอินพุต มากกว่าสองเท่าครึ่งของงาน 50 ขั้นตอนข้างต้น ใช้ไปกับข้อความสถานะเท่านั้น ด้วยบันทึก 500 โทเคนจะเป็น 500 × 120 = 60,000 บน GLM-5.3-Flash นั่นคือ $0.144 เทียบกับ $0.0013
ลองกับเอเจนต์ของคุณเอง: โทเคนต่อขั้นตอน ขั้นตอน และงานต่อวัน
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของงานแบบนี้สิ้งาน
โทเค็นอินพุตต่อคำขอ: 54,000 · โทเค็นเอาต์พุตต่อคำขอ: 400 · คำขอต่อวัน: 500
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, คีย์ และคำขอแรกอยู่ใน เอกสาร CheapTokens; ราคาปัจจุบันของทุกโมเดลอยู่ที่ หน้าราคา
สี่วิธีลดค่าใช้จ่าย#
ไม่มีวิธีใดต้องใช้เครื่องมือพิเศษ เป็นนิสัยของการถามว่า: การเรียกนี้จำเป็นต้องใช้ประวัติจริง ๆ หรือไม่?
รูปแบบบันทึก#
เก็บบันทึกไม่กี่บรรทัดขณะเอเจนต์ทำงาน และส่งเฉพาะบันทึกนั้นให้โมเดลเล็กเมื่อต้องการสถานะหรือสรุป นี่คือตัวอย่างบน GLM-5.3-Flash (zai-, คอนเท็กซ์ 390K, เอาต์พุตสูงสุด 8,192 โทเคนต่อคำตอบ):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
คุณจะได้กลับมาหนึ่งบรรทัดสั้น ๆ และคู่ usage แสดงอินพุตเป็นสิบโทเคน ไม่ใช่หมื่นโทเคน นั่นคือแนวคิดเดียวกับการเปลี่ยนแปลงของ Claude Code ในโค้ดสิบกว่าบรรทัด
นิสัยแบบไหนเหมาะกับกรณีของคุณ?
เลือกกรณีของคุณ
สถานการณ์ของคุณคืออะไร?
เลือกตัวเลือกเพื่อดูคำตอบ
เซสชันเดียว หัวข้อเปลี่ยน
เริ่มเซสชันใหม่ วางบันทึกห้าบรรทัด (เป้าหมาย อะไรเสร็จแล้ว อะไรต่อไป) แทนบทสนทนาเก่า ตัวเลือกการตัดทอนอยู่ใน ตัดประวัติแชต: หน้าต่างเลื่อนหรือสรุป
งานข้างเคียง: สถานะ สรุป หัวข้อ
ให้บันทึก ไม่ใช่ประวัติ และส่งไปยังโมเดลเล็ก ดังในโค้ดข้างต้น
เอาต์พุตเครื่องมือขนาดใหญ่: ล็อก, ดัมป์การทดสอบ
เก็บมันออกจากประวัติ แสดง 20 บรรทัดสุดท้ายหรือการทดสอบที่ล้มเหลวเพียงรายการเดียว ไม่ใช่ดัมป์ทั้งหมด: ทุกบรรทัดที่คุณเก็บจะถูกส่งซ้ำในทุกขั้นตอนถัดไป การใช้โทเคนของ Claude Code: เก็บเอาต์พุตเครื่องมือออกจากคอนเท็กซ์ แสดงวิธีทำ
prompt ยาวเดิมทุกครั้งที่เรียก
ถามผู้ให้บริการของคุณเกี่ยวกับ prompt caching ซึ่งสามารถใช้ prompt เริ่มต้นที่ซ้ำกันซ้ำได้แทนการอ่านใหม่ทุกครั้ง
หากคุณใช้ Claude Code ให้อัปเดตและดู changelog สำหรับบันทึกบรรทัดสถานะ
สำหรับลูปเอง DeepSeek-V4-Flash (deepseek-) ให้คอนเท็กซ์ 380K เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ และราคาเดียวทุกชั่วโมง ปลายทาง 103,000 โทเคนของตัวอย่างเราพอดีในหน้าต่างนั้นมากกว่าสามเท่า สำหรับบันทึกและสรุป ใช้ GLM-5.3-Flash โมเดลอื่น ๆ อยู่ที่ หน้ารุ่น


