কেন একটি AI এজেন্ট প্রতিটি ধাপে তার পুরো ইতিহাস আবার পড়ে
Claude Code স্ট্যাটাস-লাইন সমাধান দেখায় কেন দীর্ঘ এজেন্ট সেশন ব্যয়বহুল হয়: প্রতিটি কল কথোপকথন আবার পাঠায়। খরচ অনুমান করুন এবং কমান।
এই পৃষ্ঠায়
আপনার এজেন্ট দশ মিনিট ধরে চলল, আর বিলটা কাজের চেহারার চেয়ে অনেক বড়। প্রায় সবসময় কারণ একই: মডেল কলের মধ্যে কিছুই মনে রাখে না, তাই প্রতিটি ধাপ আগের পুরো কথোপকথন আবার ইনপুট হিসেবে পাঠায়। ৫০ ধাপের একটি সেশন তার প্রথম বার্তাগুলোর জন্য ৫০ বার খরচ দেয়, এজন্যই খরচ করা কাজের চেয়ে দ্রুত বাড়ে।
Anthropic ৪–৫ নভেম্বর ২০২৬-এ Claude Code-এর জন্য যে সমাধান ঘোষণা করেছে তা একটি ছোট জায়গায় এটি দেখায়। নিচে: কী বদলাল, ৫০ ধাপের লুপের হিসাব, এবং আপনি এ নিয়ে কী করতে পারেন।
একটি স্ট্যাটাস লাইন যা সবকিছু আবার পড়ত#
Claude Code ব্যাকগ্রাউন্ড সাবএজেন্ট চালু করতে পারে: সহায়ক এজেন্ট যারা আপনি কাজ চালিয়ে যাওয়ার সময় একটি পাশের কাজে কাজ করে। প্রতিটি একটি এক-লাইনের স্ট্যাটাস দেখায়, যেমন 'running tests, 3 of 8 done'।
X-এ ClaudeDevs অ্যাকাউন্ট পরিবর্তনটি ঘোষণা করেছে (পোস্টটি ৫ নভেম্বর ২০২৬ তারিখের; মাধ্যমিক প্রতিবেদনে ৪ বা ৫ নভেম্বর বলা হয়েছে)। স্ট্যাটাস প্রতি ৩০ সেকেন্ডে রিফ্রেশ হত, এবং প্রতিটি রিফ্রেশ সাবএজেন্টের পুরো কথোপকথন আবার পড়ত। এখন Haiku 5.5 সংক্ষিপ্ত নোট থেকে স্ট্যাটাস লেখে, এবং Anthropic এটিকে প্রতি আপডেটে প্রায় ৯৯% সস্তা বলে উল্লেখ করেছে। এটি প্রতি-আপডেটের সংখ্যা, প্রতি-সেশনের নয়: সাবএজেন্টের আসল কাজ এখনও তার ইতিহাস পড়ে।
পুরনো পদ্ধতির অর্থ কী তা ভাবুন। ধরুন একটি সাবএজেন্টের বিশ মিনিটে ৬০,০০০ টোকেন কথোপকথন হয়েছে। স্ট্যাটাস নিজে হয়তো ৩০ টোকেন। কিন্তু সেই ৩০ টোকেন লিখতে মডেলকে আবার পুরো ৬০,০০০ পড়তে হত, মিনিটে দুইবার, যতক্ষণ সাবএজেন্ট চলত।
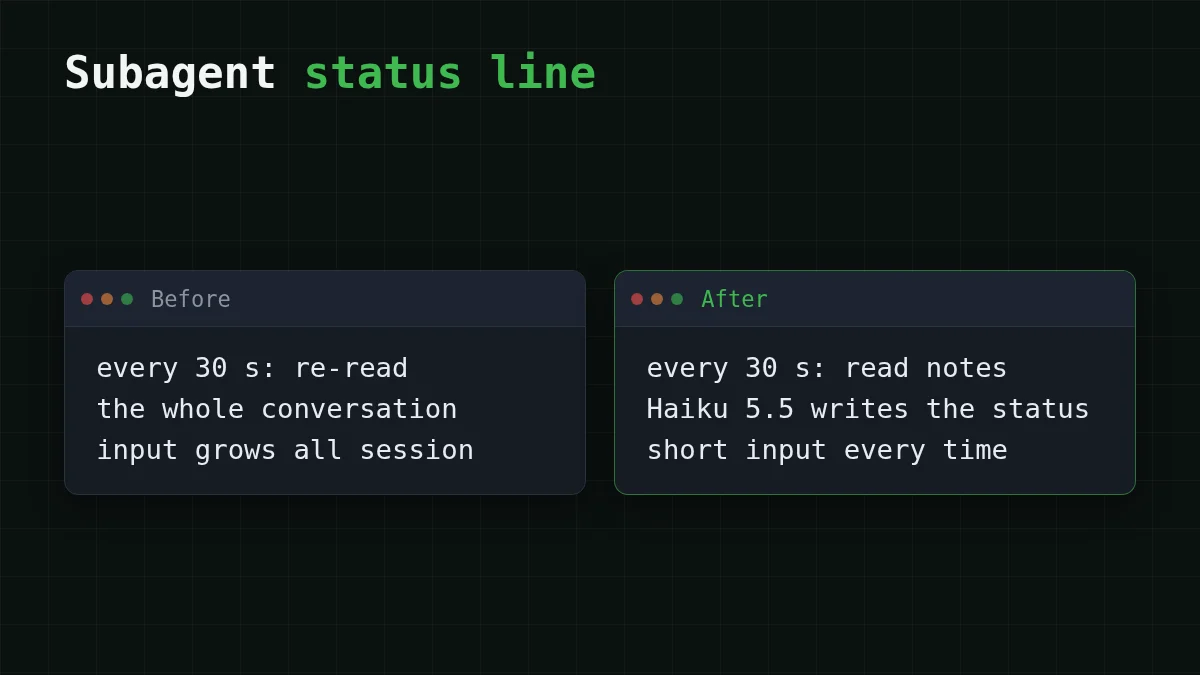
'running tests' বলতে কারও পুরো ট্রান্সক্রিপ্ট দরকার নেই। কয়েক লাইন নোট (আমি কী করছি, কী শেষ হয়েছে) যথেষ্ট। এটাই পুরো সমাধান: একটি পাশের কাজকে ট্রান্সক্রিপ্ট নয়, নোট দিন।
কেন প্রতিটি ধাপ ইতিহাস আবার পাঠায়#
এমন কাউকে চিঠি লেখার কথা ভাবুন যে উত্তর দেওয়ার সাথে সাথেই আপনাকে ভুলে যায়। চালিয়ে যেতে, আপনাকে পুরো চিঠিপত্র আবার পাঠাতে হয় plus নতুন লাইন। একটি এজেন্ট ধাপ ঠিক সেই কল: সিস্টেম প্রম্পট, আপনার কাজ, প্রতিটি আগের উত্তর এবং প্রতিটি টুল ফলাফল আবার ভিতরে যায়। (এই গল্পের চ্যাট সংস্করণ কেন একটি দীর্ঘ AI চ্যাট বেশি খরচ করে-এ আছে।)
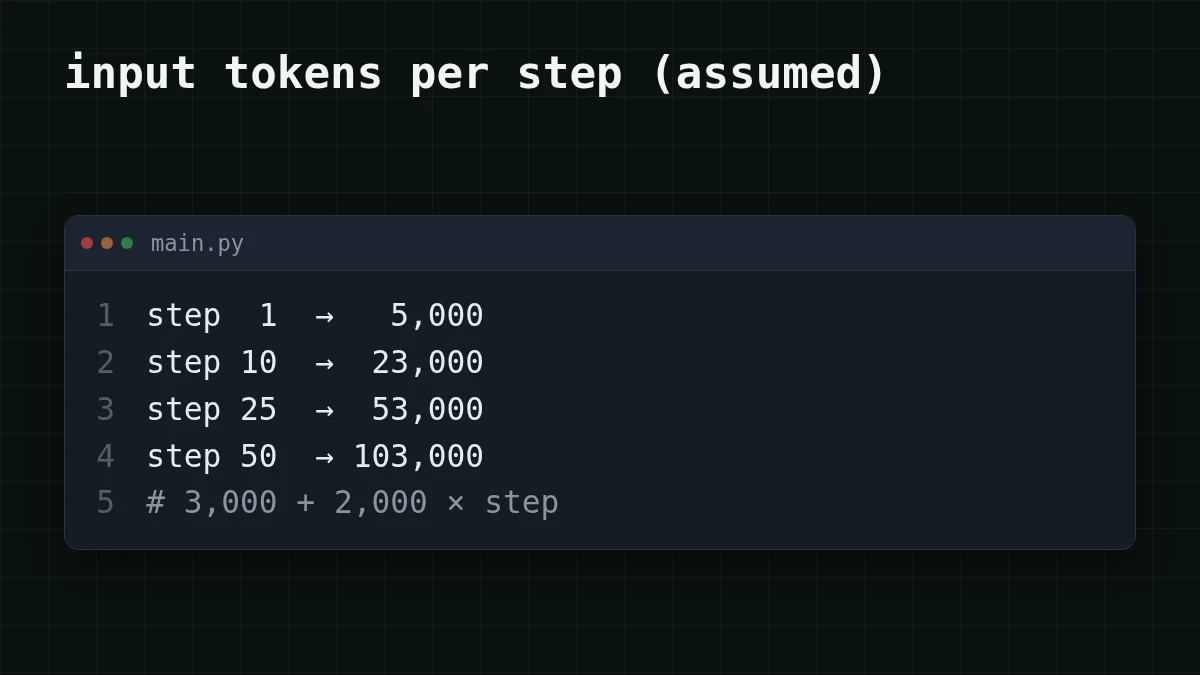
সংখ্যায় বসাই। ধরুন সিস্টেম প্রম্পট এবং কাজ ৩,০০০ টোকেন নেয়, এবং প্রতিটি ধাপ প্রায় ২,০০০ যোগ করে (মডেলের উত্তর plus যে টুল আউটপুট এটি পড়ে)। তাহলে ধাপ n পাঠায় ৩,০০০ + ২,০০০ × n টোকেন: ধাপ ১-এ ৫,০০০, ধাপ ১০-এ ২৩,০০০, ধাপ ৫০-এ ১০৩,০০০।
সংখ্যা অনুমান করুন
এই এজেন্টের ধাপ ৫০ কত ইনপুট টোকেন পাঠায়?
আপনার অনুমান
০২,০০,০০০
উত্তর দেখান
উত্তর: ১,০৩,০০০
৩,০০০ + ২,০০০ × ৫০ = ১০৩,০০০। মডেল শুরুর প্রম্পট এবং আগের ৪৯টি ধাপ আবার পড়ে, তারপর উপরে আপনার নতুন ধাপ।
এখন সব ৫০টি ধাপ যোগ করুন। বাড়তে থাকা অংশটি 2,000 × 1,275 = 2,550,000, যেখানে ১,২৭৫ হল ১ + ২ + … + ৫০। শুরুর প্রম্পট, প্রতিবার পাঠানো, 50 × 3,000 = 150,000। একসাথে: 150,000 + 2,550,000 = 2,700,000 ইনপুট টোকেন। সম্পূর্ণ কথোপকথনে ধরে মাত্র ১০৩,০০০। ১০৩,০০০-টোকেন ট্রান্সক্রিপ্ট পেতে আপনি মডেলের মধ্য দিয়ে ২.৭ মিলিয়ন টোকেন চালিয়েছেন, এবং বিল প্রথম সংখ্যাটি অনুসরণ করে।
এতে কত খরচ হয়: একটি কাজ, এক দিন#
DeepSeek-V4-Flash-এ একই ৫০-ধাপের এজেন্টের দাম করুন। গড় ধাপ ৫৪,০০০ টোকেন পাঠায়, তাই মোট 54,000 × 50 = 2,700,000 ইনপুট টোকেন, এবং এটি প্রতি ধাপে প্রায় ৪০০ লেখে (400 × 50 = 20,000)। পুরো কাজটির খরচ $0.0425। এখানে OpenRouter-এর পাশে আমাদের সব মডেলে একই কাজের চাপ:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ৫০টি অনুরোধ | OpenRouter, ৫০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
প্রতি অনুরোধে ৫৪,০০০ ইনপুট এবং ৪০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
টেবিলে, প্রতিটি মডেল মোটে OpenRouter-এর চেয়ে সস্তা, ইনপুট ও আউটপুট একসাথে গণনা করে।
এখন স্ট্যাটাস লাইন। ১২০টি আপডেট হল এক সাবএজেন্টের এক ঘণ্টা, এবং প্রতিটি প্রায় ৩০ টোকেন লেখে (30 × 120 = 3,600 আউটপুট)। পুরনো পদ্ধতি: 60,000 × 120 = 7,200,000 ইনপুট টোকেন, উপরের ৫০-ধাপের কাজগুলোর আড়াইটিরও বেশি, শুধু একটি স্ট্যাটাস টেক্সটে খরচ। ৫০০-টোকেন নোটে এটি 500 × 120 = 60,000। GLM-5.3-Flash-এ এটি $0.144 বনাম $0.0013।
নিজের এজেন্ট চেষ্টা করুন: প্রতি ধাপে টোকেন, ধাপ এবং প্রতিদিন কাজ।
খরচ ক্যালকুলেটর
এমন দশটি কাজের এক দিন
প্রতি অনুরোধে ইনপুট টোকেন: ৫৪,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ৪০০ · প্রতিদিন অনুরোধ: ৫০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
বেস URL, কী এবং প্রথম অনুরোধ CheapTokens ডকস-এ আছে; প্রতিটি মডেলের বর্তমান দাম প্রাইসিং পেজ-এ।
কমানোর চারটি উপায়#
এগুলোর কোনোটিরই বিশেষ টুল দরকার নেই। এটি জিজ্ঞাসা করার অভ্যাস: এই কলের কি সত্যিই ইতিহাস দরকার?
নোট প্যাটার্ন#
এজেন্ট কাজ করার সময় কয়েক লাইন নোট রাখুন, এবং স্ট্যাটাস বা সারাংশ দরকার হলে শুধু সেগুলো একটি ছোট মডেলকে দিন। এখানে GLM-5.3-Flash-এ (zai-, ৩৯০K কনটেক্সট, প্রতি উত্তরে ৮,১৯২ পর্যন্ত আউটপুট টোকেন):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
আপনি একটি ছোট লাইন ফেরত পান, এবং ব্যবহারের জোড়া দেখায় ইনপুট দশ টোকেনে, হাজার হাজারে নয়। এটি Claude Code পরিবর্তনের মতোই ধারণা, এক ডজন লাইনে।
কোন অভ্যাস আপনার ক্ষেত্রে মানায়?
আপনার কেস বেছে নিন
আপনার পরিস্থিতি কী?
উত্তর দেখতে একটি বিকল্প বেছে নিন
একটি সেশন, বিষয় বদলে গেছে
নতুন সেশন শুরু করুন। পুরনো ট্রান্সক্রিপ্টের বদলে পাঁচ লাইন নোট (লক্ষ্য, কী হয়েছে, পরবর্তী কী) পেস্ট করুন। ছাঁটাইয়ের বিকল্পগুলো চ্যাট ইতিহাস ছাঁটাই: স্লাইডিং উইন্ডো বা সারাংশ-এ আছে।
একটি পাশের কাজ: স্ট্যাটাস, সারাংশ, শিরোনাম
এটিকে ইতিহাস নয়, নোট দিন, এবং উপরের কোডের মতো একটি ছোট মডেলে পাঠান।
বিশাল টুল আউটপুট: লগ, টেস্ট ডাম্প
এটি ইতিহাসের বাইরে রাখুন। শেষ ২০ লাইন বা একমাত্র ব্যর্থ টেস্ট দেখান, পুরো ডাম্প নয়: আপনি যে প্রতিটি লাইন রাখেন তা প্রতিটি পরবর্তী ধাপে আবার পাঠানো হয়। Claude Code টোকেন ব্যবহার: টুল আউটপুট কনটেক্সটের বাইরে রাখুন দেখায় কীভাবে।
প্রতিটি কলে একই দীর্ঘ প্রম্পট
আপনার প্রদানকারীকে প্রম্পট ক্যাশিং সম্পর্কে জিজ্ঞাসা করুন, যা প্রতিবার নতুন করে পড়ার বদলে প্রম্পটের পুনরাবৃত্ত শুরুর অংশ পুনরায় ব্যবহার করতে পারে।
আপনি যদি Claude Code ব্যবহার করেন, এটি আপডেট করুন এবং স্ট্যাটাস-লাইন নোটের জন্য চেঞ্জলগ দেখুন।
লুপের জন্য, DeepSeek-V4-Flash (deepseek-) আপনাকে ৩৮০K কনটেক্সট, প্রতি উত্তরে ৩২,৭৬৮ পর্যন্ত আউটপুট টোকেন এবং যেকোনো সময়ে একই দাম দেয়। আমাদের উদাহরণের ১০৩,০০০-টোকেন প্রান্তটি সেই উইন্ডোতে তিনবারেরও বেশি ফিট করে। নোট এবং সারাংশের জন্য, GLM-5.3-Flash। অন্যান্য মডেল মডেল পেজ-এ আছে।


