AI cho người mớiHướng dẫn
Vì sao một AI agent đọc lại toàn bộ lịch sử ở mỗi bước
Một bản sửa dòng trạng thái của Claude Code cho thấy vì sao các phiên agent dài lại tốn kém: mỗi lần gọi gửi lại cuộc hội thoại. Hãy ước tính chi phí và cắt giảm nó.
Trên trang này
Agent của bạn chạy mười phút, và hoá đơn lớn hơn nhiều so với vẻ ngoài của công việc. Gần như lúc nào lý do cũng giống nhau: model không nhớ gì giữa các lần gọi, nên mỗi bước lại gửi toàn bộ cuộc hội thoại tính đến thời điểm đó làm đầu vào. Một phiên 50 bước trả tiền cho những tin nhắn đầu tiên của nó 50 lần, đó là lý do chi phí tăng nhanh hơn khối lượng công việc đã làm.
Một bản sửa mà Anthropic công bố cho Claude Code vào ngày 4–5 tháng 11 năm 2026 cho thấy điều này ở một chỗ nhỏ. Dưới đây: điều gì đã thay đổi, phép tính của một vòng lặp 50 bước, và bạn có thể làm gì với nó.
Một dòng trạng thái đọc lại mọi thứ#
Claude Code có thể khởi chạy các subagent chạy nền: những agent phụ làm một việc bên lề trong khi bạn tiếp tục. Mỗi cái hiển thị một dòng trạng thái, đại loại như 'đang chạy test, xong 3 trên 8'.
Tài khoản ClaudeDevs trên X đã công bố thay đổi (bài đăng ghi ngày 5 tháng 11 năm 2026; các báo cáo thứ cấp nói ngày 4 hoặc 5 tháng 11). Trước đây trạng thái được làm mới mỗi 30 giây, và mỗi lần làm mới lại đọc lại toàn bộ cuộc hội thoại của subagent. Giờ Haiku 5.5 viết trạng thái từ những ghi chú ngắn, và Anthropic ước tính việc đó rẻ hơn khoảng 99% mỗi lần cập nhật. Đó là con số cho mỗi lần cập nhật, không phải cho mỗi phiên: công việc thực sự của subagent vẫn đọc lịch sử của nó.
Hãy hình dung cách cũ nghĩa là gì. Giả sử một subagent có 60.000 token hội thoại vào phút thứ hai mươi. Bản thân trạng thái có lẽ khoảng 30 token. Nhưng để viết 30 token đó, model phải đọc lại toàn bộ 60.000, hai lần mỗi phút, chừng nào subagent còn chạy.
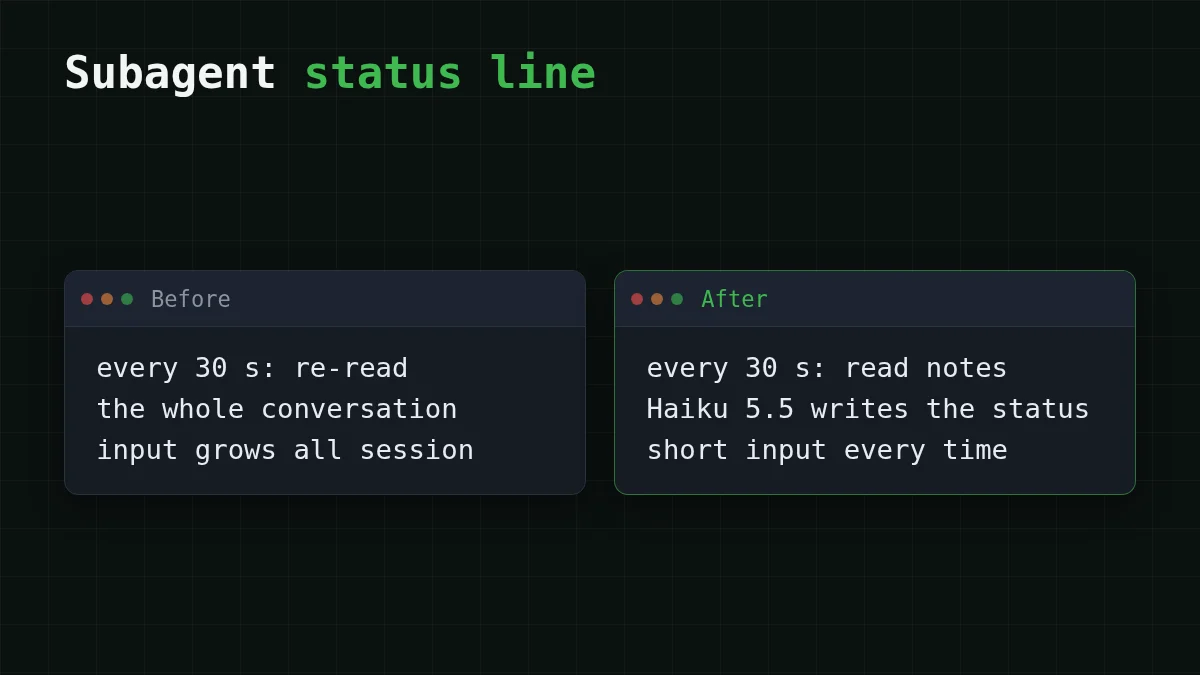
Không ai cần toàn bộ bản ghi để nói 'đang chạy test'. Vài dòng ghi chú (tôi đang làm gì, cái gì đã xong) là đủ. Đó chính là toàn bộ bản sửa: cho một việc bên lề những ghi chú, không phải bản ghi.
Vì sao mỗi bước lại gửi lại lịch sử#
Hãy nghĩ đến một lá thư gửi cho người quên bạn ngay khi vừa trả lời. Để tiếp tục, bạn gửi lại toàn bộ thư từ cộng thêm dòng mới. Một bước của agent chính xác là lần gọi đó: system prompt, nhiệm vụ của bạn, mọi câu trả lời trước đó và mọi kết quả công cụ lại được đưa vào. (Phiên bản chat của câu chuyện này nằm trong vì sao một cuộc chat AI dài tốn hơn.)
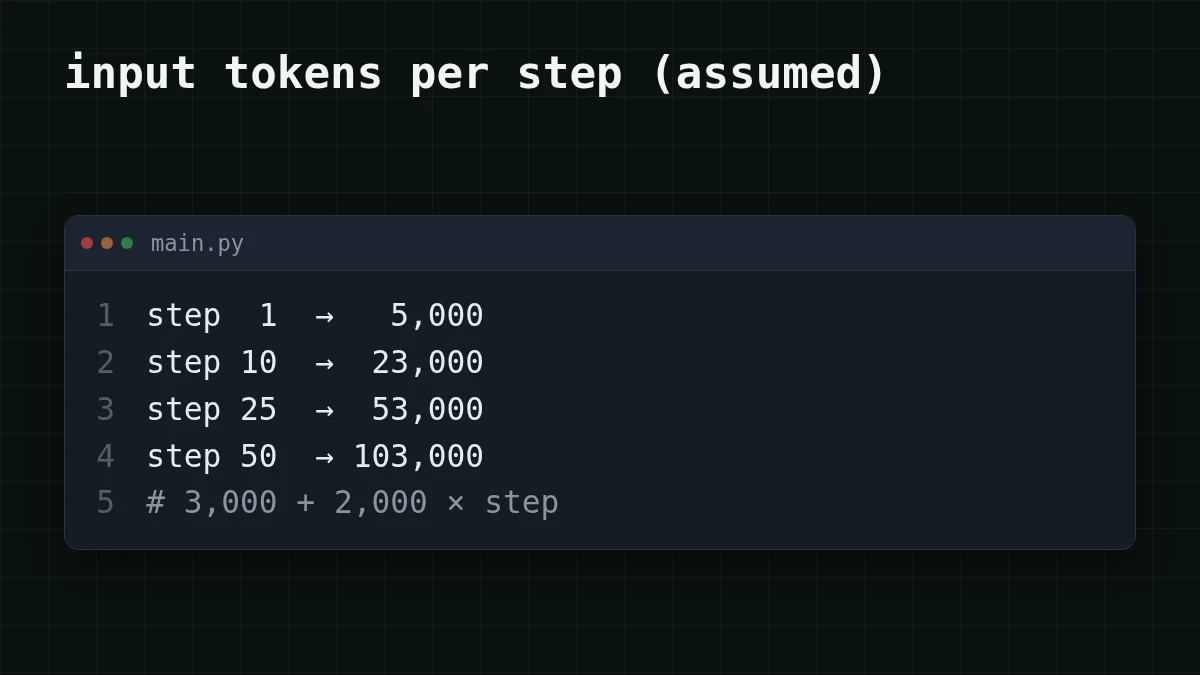
Hãy đặt con số vào. Giả sử system prompt và nhiệm vụ chiếm 3.000 token, và mỗi bước thêm khoảng 2.000 (câu trả lời của model cộng với đầu ra công cụ mà nó đọc). Bước n khi đó gửi 3.000 + 2.000 × n token: 5.000 ở bước 1, 23.000 ở bước 10, 103.000 ở bước 50.
Đoán số
Bước 50 của agent này gửi bao nhiêu token đầu vào?
Dự đoán của bạn
0200.000
Hiện đáp án
Trả lời: 103.000
3.000 + 2.000 × 50 = 103.000. Model đọc lại prompt khởi đầu và cả 49 bước trước đó, rồi thêm bước mới của bạn lên trên.
Giờ cộng tất cả 50 bước. Phần tăng dần là 2,000 × 1,275 = 2,550,000, trong đó 1.275 là 1 + 2 + … + 50. Prompt khởi đầu, được gửi mỗi lần, là 50 × 3,000 = 150,000. Cộng lại: 150,000 + 2,550,000 = 2,700,000 token đầu vào. Cuộc hội thoại hoàn chỉnh chỉ chứa 103.000. Bạn đã đẩy 2,7 triệu token qua model để có một bản ghi 103.000 token, và hoá đơn theo con số đầu tiên.
Nó tốn bao nhiêu: một việc, một ngày#
Hãy tính giá cho cùng agent 50 bước đó trên DeepSeek-V4-Flash. Bước trung bình gửi 54.000 token, vậy tổng cộng 54,000 × 50 = 2,700,000 token đầu vào, và nó viết khoảng 400 mỗi bước (400 × 50 = 20,000). Toàn bộ công việc tốn $0.0425. Đây là cùng khối lượng công việc trên mọi model chúng tôi có, bên cạnh OpenRouter:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 50 yêu cầu | OpenRouter, 50 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 token đầu vào và 400 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Trong bảng, mọi model đều rẻ hơn OpenRouter về tổng cộng, khi tính cả đầu vào và đầu ra.
Giờ đến dòng trạng thái. 120 lần cập nhật là một giờ của một subagent, và mỗi lần viết khoảng 30 token (30 × 120 = 3,600 đầu ra). Cách cũ: 60,000 × 120 = 7,200,000 token đầu vào, hơn hai lần rưỡi các việc 50 bước ở trên, tiêu vào chẳng gì ngoài một dòng chữ trạng thái. Với một ghi chú 500 token thì là 500 × 120 = 60,000. Trên GLM-5.3-Flash đó là $0.144 so với $0.0013.
Hãy thử với agent của chính bạn: token mỗi bước, số bước và số việc mỗi ngày.
Máy tính chi phí
Một ngày với mười việc như vậy
Token đầu vào mỗi yêu cầu: 54.000 · Token đầu ra mỗi yêu cầu: 400 · Số yêu cầu mỗi ngày: 500
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, key và một request đầu tiên nằm trong tài liệu CheapTokens; giá hiện tại cho mọi model ở trang giá.
Bốn cách để cắt giảm#
Không cách nào trong số này cần công cụ đặc biệt. Đó là thói quen tự hỏi: lần gọi này có thực sự cần lịch sử không?
Mẫu ghi chú#
Giữ vài dòng ghi chú trong khi agent làm việc, và chỉ đưa những dòng đó cho một model nhỏ khi bạn cần trạng thái hoặc bản tóm tắt. Đây là nó trên GLM-5.3-Flash (zai-, ngữ cảnh 390K, tối đa 8.192 token đầu ra mỗi câu trả lời):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Bạn nhận lại một dòng ngắn, và cặp usage cho thấy đầu vào tính bằng hàng chục token, không phải hàng chục nghìn. Đó chính là ý tưởng của thay đổi ở Claude Code, trong chục dòng code.
Thói quen nào hợp với trường hợp của bạn?
Chọn trường hợp của bạn
Tình huống của bạn là gì?
Chọn một tùy chọn để xem đáp án
Một phiên, chủ đề đã đổi
Bắt đầu một phiên mới. Dán năm dòng ghi chú (mục tiêu, cái gì đã xong, cái gì tiếp theo) thay vì bản ghi cũ. Các tuỳ chọn cắt gọn nằm trong cắt gọn lịch sử chat: cửa sổ trượt hay tóm tắt.
Một việc bên lề: trạng thái, tóm tắt, tiêu đề
Đưa cho nó ghi chú, không phải lịch sử, và gửi đến một model nhỏ, như trong code ở trên.
Đầu ra công cụ khổng lồ: log, kết xuất test
Giữ nó ngoài lịch sử. Chỉ hiện 20 dòng cuối hoặc test đang lỗi, không phải toàn bộ kết xuất: mỗi dòng bạn giữ lại đều được gửi lại ở mọi bước sau. Mức dùng token của Claude Code: giữ đầu ra công cụ ngoài ngữ cảnh chỉ cách làm.
Cùng một prompt dài ở mọi lần gọi
Hỏi nhà cung cấp của bạn về prompt caching, có thể tái sử dụng phần đầu lặp lại của prompt thay vì đọc lại từ đầu mỗi lần.
Nếu bạn dùng Claude Code, hãy cập nhật nó và xem qua changelog để tìm ghi chú về dòng trạng thái.
Với chính vòng lặp, DeepSeek-V4-Flash (deepseek-) cho bạn ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời và một mức giá ở mọi giờ. Đầu 103.000 token của ví dụ chúng ta vừa vặn trong cửa sổ đó hơn ba lần. Với ghi chú và tóm tắt, dùng GLM-5.3-Flash. Các model khác ở trang model.


