AI 入门指南
为什么 AI agent 每一步都重新读取它的整个历史
一个 Claude Code 状态行修复说明了为什么长 agent 会话会变贵:每次调用都重新发送对话。估算成本并削减它。
你的 agent 运行了十分钟,账单却比任务看起来大得多。原因几乎总是一样的:模型在两次调用之间什么都不记得,所以每一步都会把到目前为止的整个对话作为输入重新发送。一个 50 步的会话要为它的第一批消息付费 50 次,这就是为什么成本增长得比完成的工作更快。
Anthropic 在 2026 年 11 月 4–5 日为 Claude Code 宣布的一项修复,在一个小地方展示了这一点。下面:改了什么、50 步循环的算术,以及你能做些什么。
一个重新读取一切的状态行#
Claude Code 可以启动后台子 agent:在你继续工作的同时处理副任务的辅助 agent。每个子 agent 显示一行状态,类似“running tests, 3 of 8 done”。
X 上的 ClaudeDevs 账号宣布了这项变更(帖子日期为 2026 年 11 月 5 日;二手报道说是 11 月 4 日或 5 日)。状态过去每 30 秒刷新一次,每次刷新都会重新读取子 agent 的整个对话。现在 Haiku 5.5 根据简短笔记写出状态,Anthropic 称每次更新便宜约 99%。这是每次更新的数字,不是每个会话的数字:子 agent 的实际工作仍然会读取它的历史。
想象旧方式意味着什么。假设一个子 agent 到第二十分钟时有 60,000 个 token 的对话。状态本身大概 30 个 token。但为了写出这 30 个 token,模型不得不再次读取全部 60,000 个 token,每分钟两次,只要子 agent 还在运行。
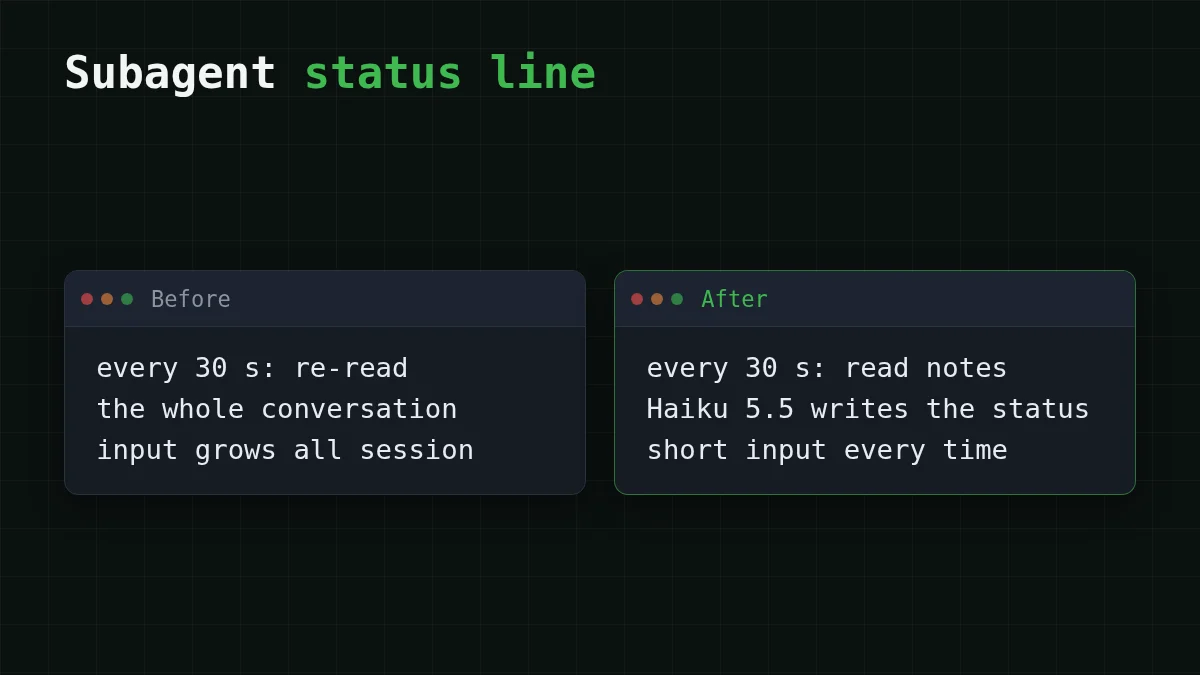
没有人需要完整记录才能说出“running tests”。几行笔记(我在做什么、什么已完成)就够了。这就是整个修复:给副任务笔记,而不是记录。
为什么每一步都重新发送历史#
想象给一个在你回复的瞬间就忘记你的人写信。要继续,你得把整份往来信件再加上新的一行重新寄过去。agent 的一步正是这样的调用:系统提示、你的任务、每一个先前的回答和每一个工具结果都会再次进入。(这个故事的聊天版本在为什么长 AI 聊天更贵中。)
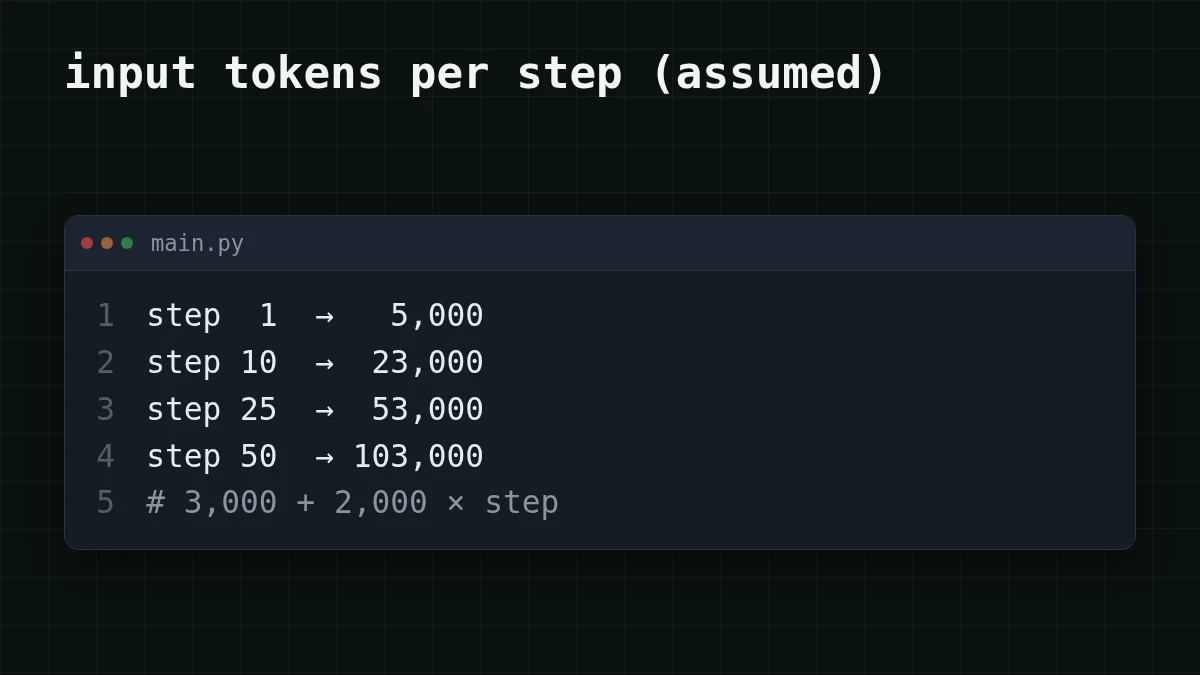
让我们用数字说明。假设系统提示和任务占 3,000 个 token,每一步增加约 2,000(模型的回复加上它读取的工具输出)。那么第 n 步发送 3,000 + 2,000 × n 个 token:第 1 步 5,000,第 10 步 23,000,第 50 步 103,000。
猜数字
这个 agent 的第 50 步发送多少输入 token?
你的猜测
0200,000
显示答案
答案: 103,000
3,000 + 2,000 × 50 = 103,000。模型重新读取起始提示和所有 49 个先前步骤,然后再加上你的新步骤。
现在把全部 50 步加起来。增长的部分是 2,000 × 1,275 = 2,550,000,其中 1,275 是 1 + 2 + … + 50。每次都发送的起始提示是 50 × 3,000 = 150,000。合计:150,000 + 2,550,000 = 2,700,000 个输入 token。完成的对话只包含 103,000。你让 270 万个 token 通过了模型,才得到一份 103,000 token 的记录,而账单跟着第一个数字走。
成本是多少:一个任务,一天#
在 DeepSeek-V4-Flash 上为同样的 50 步 agent 定价。平均每步发送 54,000 个 token,所以总共 54,000 × 50 = 2,700,000 个输入 token,每步写出约 400 个(400 × 50 = 20,000)。整个任务花费 $0.0425。下面是同样的工作负载在我们所有模型上的表现,与 OpenRouter 对比:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 50 次请求 | OpenRouter,50 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
每次请求 54,000 个输入 token 和 400 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
在表中,每个模型的总计都比 OpenRouter 便宜,输入和输出合并计算。
现在看状态行。120 次更新是一个子 agent 一小时,每次写出约 30 个 token(30 × 120 = 3,600 输出)。旧方式:60,000 × 120 = 7,200,000 个输入 token,超过上面两个半的 50 步任务,全花在状态文本上。用 500 token 的笔记则是 500 × 120 = 60,000。在 GLM-5.3-Flash 上,这是 $0.144 对 $0.0013。
试试你自己的 agent:每步 token 数、步数和每天任务数。
成本计算器
一天十个这样的任务
每次请求的输入 token 数: 54,000 · 每次请求的输出 token 数: 400 · 每日请求数: 500
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL、密钥和第一个请求在 CheapTokens 文档中;每个模型的当前价格在定价页面上。
四种削减方法#
这些都不需要特殊工具。这是一种习惯:问一问,这次调用真的需要历史吗?
笔记模式#
在 agent 工作时保留几行笔记,当你需要状态或摘要时,只把这些交给小模型。下面是 GLM-5.3-Flash 上的示例(zai-,390K 上下文,每次回答最多 8,192 个输出 token):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
你得到一行简短回复,用量对显示输入是几十个 token,而不是几万个。这和 Claude Code 的变更思路相同,只用十几行代码。
哪种习惯适合你的情况?
选择你的情况
你的情况是什么?
选择一个选项以查看答案
一个会话,话题变了
开始一个新会话。粘贴五行笔记(目标、已完成、下一步),而不是旧记录。裁剪选项在裁剪聊天历史:滑动窗口还是摘要中。
副任务:状态、摘要、标题
给它笔记,而不是历史,并发送给小模型,如上面的代码所示。
巨大的工具输出:日志、测试转储
把它挡在历史之外。只显示最后 20 行或那一个失败的测试,而不是整个转储:你保留的每一行都会在之后每一步重新发送。Claude Code token 用量:把工具输出挡在上下文之外展示了怎么做。
每次调用都发送同样的长提示
向你的提供商询问提示缓存,它可以复用重复的提示开头,而不是每次都重新读取。
如果你使用 Claude Code,更新它并查看变更日志中的状态行说明。
对于循环本身,DeepSeek-V4-Flash(deepseek-)提供 380K 上下文、每次回答最多 32,768 个输出 token,并且任何时段都是同一价格。我们示例末尾的 103,000 个 token 在这个窗口里能放三次以上。对于笔记和摘要,用 GLM-5.3-Flash。其他模型在模型页面上。


