AI для початківцівПосібник
Чому AI-агент перечитує всю свою історію на кожному кроці
Виправлення рядка стану в Claude Code показує, чому довгі сесії агента стають дорогими: кожен виклик знову надсилає розмову. Оцініть вартість і скоротіть її.
На цій сторінці
Ваш агент працював десять хвилин, а рахунок більший, ніж виглядає завдання. Майже завжди причина одна й та сама: модель нічого не пам'ятає між викликами, тож кожен крок знову надсилає всю розмову досі як вхідні дані. Сесія на 50 кроків платить за свої перші повідомлення 50 разів, і саме тому вартість зростає швидше за виконану роботу.
Виправлення, яке Anthropic оголосила для Claude Code 4–5 листопада 2026 року, показує це в одному маленькому місці. Нижче: що змінилося, арифметика циклу на 50 кроків і що ви можете з цим зробити.
Рядок стану, який перечитував усе#
Claude Code може запускати фонові субагенти: допоміжні агенти, що працюють над побічним завданням, поки ви продовжуєте. Кожен із них показує рядок стану, щось на кшталт «запускаю тести, 3 з 8 готово».
Акаунт ClaudeDevs у X оголосив про зміну (допис датований 5 листопада 2026 року; вторинні повідомлення кажуть про 4 або 5 листопада). Раніше стан оновлювався кожні 30 секунд, і кожне оновлення перечитувало всю розмову субагента. Тепер Haiku 5.5 пише стан із коротких нотаток, і Anthropic оцінює це приблизно як на 99% дешевше за оновлення. Це цифра на одне оновлення, а не на сесію: справжня робота субагента все одно читає свою історію.
Уявіть, що означав старий спосіб. Скажімо, у субагента 60 000 токенів розмови на двадцятій хвилині. Сам стан — це, можливо, 30 токенів. Але щоб написати ці 30 токенів, модель мала перечитати всі 60 000 знову, двічі на хвилину, стільки, скільки працював субагент.
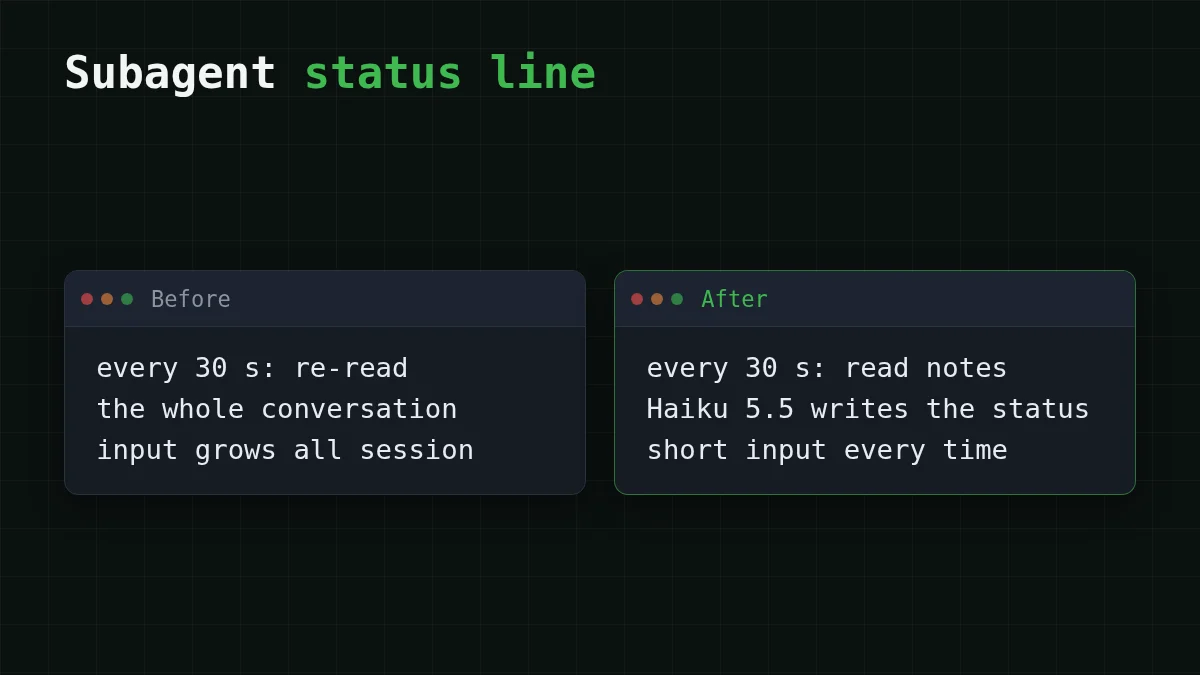
Нікому не потрібен повний транскрипт, щоб сказати «запускаю тести». Кількох рядків нотаток (що я роблю, що завершено) достатньо. Ось і все виправлення: дайте побічному завданню нотатки, а не транскрипт.
Чому кожен крок знову надсилає історію#
Уявіть лист комусь, хто забуває вас тієї ж миті, як відповідає. Щоб продовжити, ви надсилаєте все листування знову плюс новий рядок. Крок агента — це саме такий виклик: системний промпт, ваше завдання, кожна попередня відповідь і кожен результат інструмента знову йдуть на вхід. (Версія цієї історії для чату — у чому довгий AI-чат коштує дорожче.)
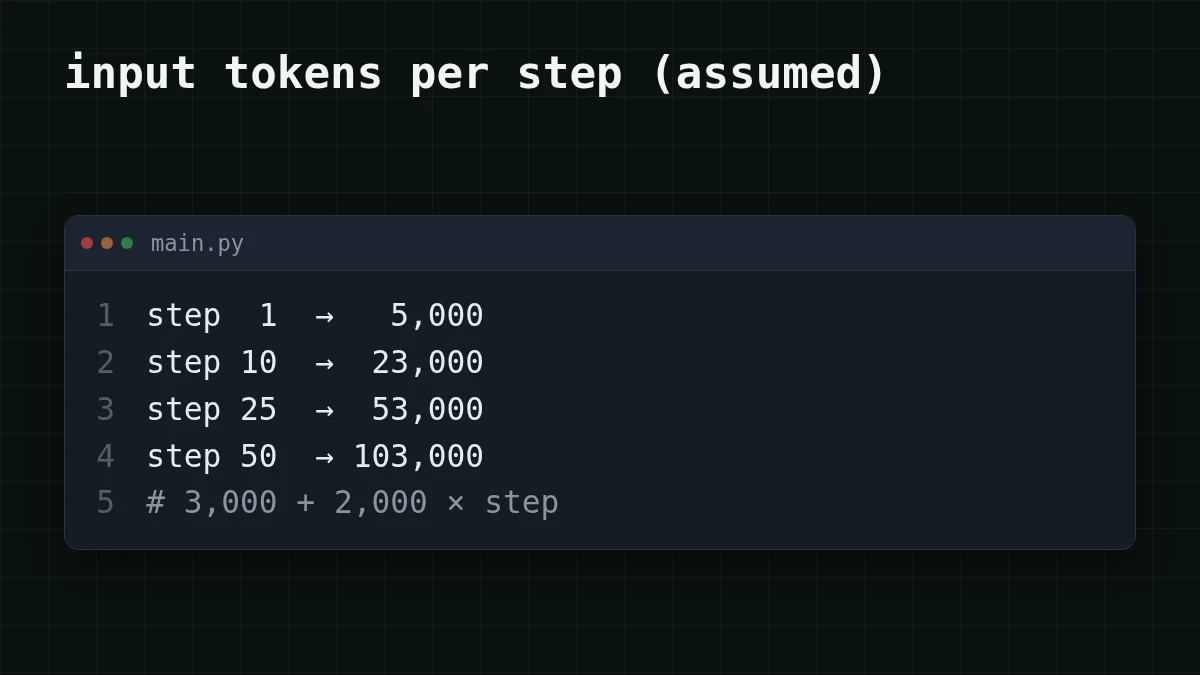
Порахуймо. Скажімо, системний промпт і завдання займають 3 000 токенів, а кожен крок додає близько 2 000 (відповідь моделі плюс вивід інструмента, який вона читає). Тоді крок n надсилає 3 000 + 2 000 × n токенів: 5 000 на кроці 1, 23 000 на кроці 10, 103 000 на кроці 50.
Вгадайте число
Скільки вхідних токенів надсилає крок 50 цього агента?
Ваше припущення
0200 000
Показати відповідь
Відповідь: 103 000
3 000 + 2 000 × 50 = 103 000. Модель перечитує стартовий промпт і всі 49 попередніх кроків, а потім ваш новий крок зверху.
Тепер додайте всі 50 кроків. Частина, що зростає, — це 2,000 × 1,275 = 2,550,000, де 1 275 — це 1 + 2 + … + 50. Стартовий промпт, що надсилається щоразу, — це 50 × 3,000 = 150,000. Разом: 150,000 + 2,550,000 = 2,700,000 вхідних токенів. Завершена розмова містить лише 103 000. Ви пропустили 2,7 мільйона токенів через модель, щоб отримати транскрипт на 103 000 токенів, і рахунок іде за першим числом.
Скільки це коштує: одне завдання, один день#
Порахуймо вартість того самого агента на 50 кроків на DeepSeek-V4-Flash. Середній крок надсилає 54 000 токенів, тож загалом 54,000 × 50 = 2,700,000 вхідних токенів, і він пише близько 400 на крок (400 × 50 = 20,000). Усе завдання коштує $0.0425. Ось те саме навантаження на кожній моделі, яка в нас є, поруч з OpenRouter:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 50 запитів | OpenRouter, 50 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54 000 вхідних і 400 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
У таблиці кожна модель дешевша за OpenRouter загалом, з урахуванням входу й виходу разом.
Тепер рядок стану. 120 оновлень — це година одного субагента, і кожне пише близько 30 токенів (30 × 120 = 3,600 виходу). Старий спосіб: 60,000 × 120 = 7,200,000 вхідних токенів, більше ніж два з половиною завдання на 50 кроків вище, витрачених ні на що, крім тексту стану. З нотаткою на 500 токенів це 500 × 120 = 60,000. На GLM-5.3-Flash це $0.144 проти $0.0013.
Спробуйте свій власний агент: токени на крок, кроки й завдання на день.
Калькулятор вартості
День із десяти таких завдань
Вхідні токени на запит: 54 000 · Вихідні токени на запит: 400 · Запитів на день: 500
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, ключ і перший запит — у документації CheapTokens; актуальні ціни для кожної моделі — на сторінці цін.
Чотири способи це скоротити#
Жоден із них не потребує спеціального інструмента. Це звичка питати: чи справді цьому виклику потрібна історія?
Патерн нотаток#
Тримайте кілька рядків нотаток, поки агент працює, і передавайте лише їх маленькій моделі, коли потрібен стан або підсумок. Ось це на GLM-5.3-Flash (zai-, контекст 390K, до 8 192 вихідних токенів на відповідь):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Ви отримуєте назад один короткий рядок, і пара usage показує вхід у десятках токенів, а не в десятках тисяч. Це та сама ідея, що й зміна в Claude Code, у десятку рядків.
Яка звичка підходить для вашого випадку?
Оберіть свій випадок
Яка ваша ситуація?
Виберіть варіант, щоб побачити відповідь
Одна сесія, тема змінилася
Почніть нову сесію. Вставте п'ять рядків нотаток (мета, що зроблено, що далі) замість старого транскрипту. Варіанти обрізання — у обрізання історії чату: ковзне вікно чи підсумок.
Побічне завдання: стан, підсумок, заголовок
Дайте йому нотатки, а не історію, і надішліть його маленькій моделі, як у коді вище.
Величезний вивід інструмента: логи, дампи тестів
Тримайте його поза історією. Покажіть останні 20 рядків або один тест, що падає, а не весь дамп: кожен рядок, який ви залишаєте, надсилається знову на кожному наступному кроці. Використання токенів у Claude Code: тримайте вивід інструментів поза контекстом показує як.
Той самий довгий промпт на кожному виклику
Запитайте у свого провайдера про кешування промптів, яке може повторно використовувати повторюваний початок промпту замість того, щоб читати його заново щоразу.
Якщо ви користуєтеся Claude Code, оновіть його й перегляньте changelog щодо примітки про рядок стану.
Для самого циклу DeepSeek-V4-Flash (deepseek-) дає вам контекст 380K, до 32 768 вихідних токенів на відповідь і одну ціну в будь-яку годину. Кінець нашого прикладу на 103 000 токенів вміщується в це вікно більш ніж тричі. Для нотаток і підсумків — GLM-5.3-Flash. Інші моделі — на сторінці моделей.


