AI एजेंट हर चरण पर अपना पूरा इतिहास क्यों फिर से पढ़ता है
Claude Code स्टेटस-लाइन सुधार दिखाता है कि लंबे एजेंट सत्र महंगे क्यों होते हैं: हर कॉल बातचीत को फिर से भेजता है। लागत का अनुमान लगाएँ और इसे कम करें।
इस पृष्ठ पर
आपका एजेंट दस मिनट तक चला, और बिल काम की तुलना में बड़ा है। लगभग हमेशा कारण एक ही होता है: मॉडल कॉल के बीच कुछ याद नहीं रखता, इसलिए हर चरण अब तक की पूरी बातचीत को फिर से इनपुट के रूप में भेजता है। 50-चरणीय सत्र अपने पहले संदेशों के लिए 50 बार भुगतान करता है, यही कारण है कि लागत किए गए काम से तेज़ी से बढ़ती है।
Anthropic द्वारा 4–5 नवंबर 2026 को Claude Code के लिए घोषित एक सुधार इसे एक छोटी जगह पर दिखाता है। नीचे: क्या बदला, 50-चरणीय लूप का गणित, और आप इसके बारे में क्या कर सकते हैं।
एक स्टेटस लाइन जो सब कुछ फिर से पढ़ती थी#
Claude Code बैकग्राउंड सबएजेंट शुरू कर सकता है: सहायक एजेंट जो आपके काम करते रहने के दौरान किसी साइड जॉब पर काम करते हैं। प्रत्येक एक-पंक्ति स्टेटस दिखाता है, जैसे 'टेस्ट चल रहे हैं, 8 में से 3 पूरे'।
X पर ClaudeDevs अकाउंट ने बदलाव की घोषणा की (पोस्ट 5 नवंबर 2026 की तारीख है; द्वितीयक रिपोर्टें 4 या 5 नवंबर कहती हैं)। स्टेटस हर 30 सेकंड में रीफ्रेश होता था, और प्रत्येक रीफ्रेश सबएजेंट की पूरी बातचीत फिर से पढ़ता था। अब Haiku 5.5 छोटे नोट्स से स्टेटस लिखता है, और Anthropic इसे प्रति अपडेट लगभग 99% सस्ता बताता है। यह प्रति-अपडेट आंकड़ा है, प्रति-सत्र नहीं: सबएजेंट का असली काम अभी भी अपना इतिहास पढ़ता है।
सोचिए पुराने तरीके का क्या मतलब था। मान लीजिए बीस मिनट तक एक सबएजेंट की बातचीत 60,000 टोकन की है। स्टेटस स्वयं शायद 30 टोकन है। लेकिन उन 30 टोकन को लिखने के लिए मॉडल को सभी 60,000 फिर से पढ़ने पड़ते थे, मिनट में दो बार, जब तक सबएजेंट चलता रहा।
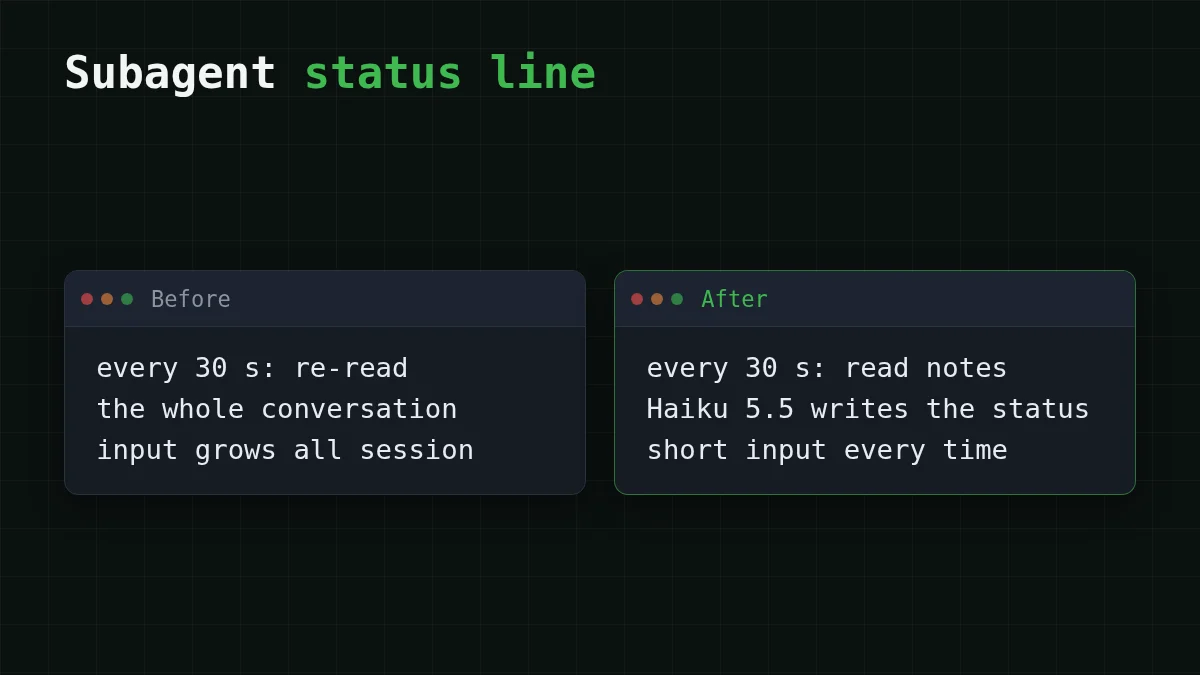
'टेस्ट चल रहे हैं' कहने के लिए किसी को पूरी ट्रांसक्रिप्ट की ज़रूरत नहीं है। कुछ पंक्तियों के नोट्स (मैं क्या कर रहा हूँ, क्या पूरा हुआ) पर्याप्त हैं। यही पूरा सुधार है: किसी साइड टास्क को ट्रांसक्रिप्ट नहीं, नोट्स दें।
हर चरण इतिहास को फिर से क्यों भेजता है#
किसी ऐसे व्यक्ति को पत्र लिखने की सोचिए जो जवाब देते ही आपको भूल जाता है। जारी रखने के लिए, आप पूरा पत्राचार फिर से भेजते हैं साथ में नई पंक्ति। एजेंट चरण बिल्कुल वही कॉल है: सिस्टम प्रॉम्प्ट, आपका कार्य, हर पिछला उत्तर और हर टूल परिणाम फिर से अंदर जाता है। (इस कहानी का चैट संस्करण लंबी AI चैट अधिक महंगी क्यों होती है में है।)
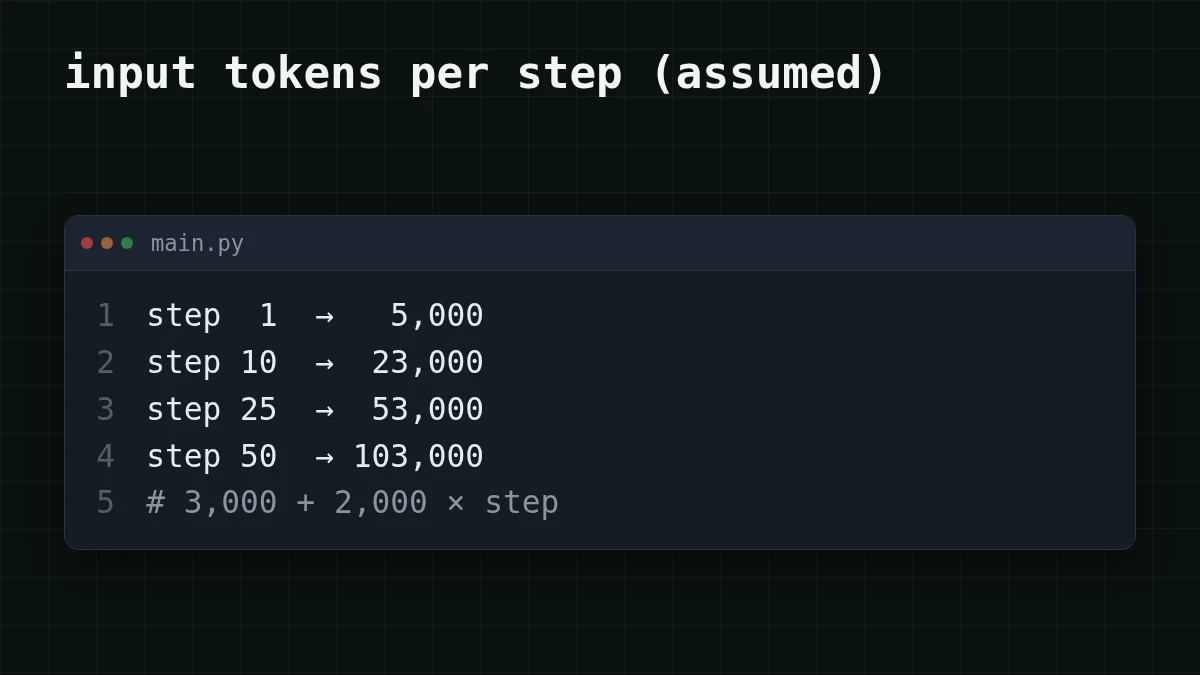
आइए इसमें संख्याएँ डालें। मान लीजिए सिस्टम प्रॉम्प्ट और कार्य 3,000 टोकन लेते हैं, और प्रत्येक चरण लगभग 2,000 जोड़ता है (मॉडल का उत्तर और वह जो टूल आउटपुट पढ़ता है)। तब चरण n 3,000 + 2,000 × n टोकन भेजता है: चरण 1 पर 5,000, चरण 10 पर 23,000, चरण 50 पर 103,000।
संख्या का अनुमान लगाएँ
इस एजेंट का चरण 50 कितने इनपुट टोकन भेजता है?
आपका अनुमान
02,00,000
उत्तर दिखाएँ
उत्तर: 1,03,000
3,000 + 2,000 × 50 = 103,000। मॉडल स्टार्ट प्रॉम्प्ट और सभी 49 पिछले चरणों को फिर से पढ़ता है, फिर ऊपर आपका नया चरण।
अब सभी 50 चरणों को जोड़ें। बढ़ने वाला भाग 2,000 × 1,275 = 2,550,000 है, जहाँ 1,275 = 1 + 2 + … + 50 है। हर बार भेजा जाने वाला शुरुआती प्रॉम्प्ट 50 × 3,000 = 150,000 है। कुल मिलाकर: 150,000 + 2,550,000 = 2,700,000 इनपुट टोकन। पूरी बातचीत में केवल 103,000 होते हैं। आपने 103,000-टोकन ट्रांसक्रिप्ट पाने के लिए 2.7 मिलियन टोकन मॉडल से गुज़ारे, और बिल पहली संख्या का पालन करता है।
इसकी लागत: एक कार्य, एक दिन#
DeepSeek-V4-Flash पर वही 50-चरणीय एजेंट की कीमत लगाएँ। औसत चरण 54,000 टोकन भेजता है, इसलिए कुल 54,000 × 50 = 2,700,000 इनपुट टोकन, और यह प्रति चरण लगभग 400 लिखता है (400 × 50 = 20,000)। पूरे कार्य की लागत $0.0425 है। यहाँ OpenRouter के बगल में, हमारे पास मौजूद हर मॉडल पर वही कार्यभार है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 50 अनुरोध | OpenRouter, 50 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
प्रति अनुरोध 54,000 इनपुट और 400 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
तालिका में, इनपुट और आउटपुट को एक साथ गिनते हुए, हर मॉडल कुल मिलाकर OpenRouter से सस्ता है।
अब स्टेटस लाइन। 120 अपडेट एक सबएजेंट के एक घंटे के हैं, और प्रत्येक लगभग 30 टोकन लिखता है (30 × 120 = 3,600 आउटपुट)। पुराना तरीका: 60,000 × 120 = 7,200,000 इनपुट टोकन, ऊपर के 50-चरणीय कार्यों में से ढाई से अधिक, केवल एक स्टेटस टेक्स्ट पर खर्च। 500-टोकन नोट के साथ यह 500 × 120 = 60,000 है। GLM-5.3-Flash पर यह $0.144 बनाम $0.0013 है।
अपना खुद का एजेंट आज़माएँ: प्रति चरण टोकन, चरण और प्रति दिन कार्य।
लागत कैलकुलेटर
ऐसे दस कार्यों का एक दिन
प्रति अनुरोध इनपुट टोकन: 54,000 · प्रति अनुरोध आउटपुट टोकन: 400 · प्रति दिन अनुरोध: 500
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
बेस URL, कुंजी और पहला अनुरोध CheapTokens दस्तावेज़ में हैं; हर मॉडल के वर्तमान मूल्य मूल्य निर्धारण पृष्ठ पर हैं।
इसे कम करने के चार तरीके#
इनमें से किसी को विशेष टूल की आवश्यकता नहीं है। यह पूछने की आदत है: क्या इस कॉल को वास्तव में इतिहास की आवश्यकता है?
नोट्स पैटर्न#
एजेंट के काम करते समय कुछ पंक्तियों के नोट्स रखें, और जब आपको स्टेटस या सारांश चाहिए तो केवल उन्हें एक छोटे मॉडल को दें। यहाँ GLM-5.3-Flash पर (zai-, 390K संदर्भ, प्रति उत्तर अधिकतम 8,192 आउटपुट टोकन):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
आपको एक छोटी पंक्ति वापस मिलती है, और उपयोग जोड़ी इनपुट को दसियों टोकन में दिखाती है, दसियों हज़ार में नहीं। यह Claude Code परिवर्तन के समान विचार है, एक दर्जन पंक्तियों में।
कौन सी आदत आपके मामले में फिट बैठती है?
अपना मामला चुनें
आपकी स्थिति क्या है?
उत्तर देखने के लिए एक विकल्प चुनें
एक सत्र, विषय बदल गया
नया सत्र शुरू करें। पुरानी ट्रांसक्रिप्ट के बजाय पाँच पंक्तियों के नोट्स (लक्ष्य, क्या हो गया, आगे क्या है) पेस्ट करें। ट्रिमिंग विकल्प चैट इतिहास ट्रिम करें: स्लाइडिंग विंडो या सारांश में हैं।
एक साइड जॉब: स्टेटस, सारांश, शीर्षक
इसे इतिहास नहीं, नोट्स दें, और इसे एक छोटे मॉडल को भेजें, जैसा ऊपर कोड में है।
विशाल टूल आउटपुट: लॉग, टेस्ट डंप
इसे इतिहास से बाहर रखें। पूरा डंप नहीं, अंतिम 20 पंक्तियाँ या एक विफल टेस्ट दिखाएँ: आप जो भी पंक्ति रखते हैं वह हर बाद के चरण पर फिर से भेजी जाती है। Claude Code टोकन उपयोग: टूल आउटपुट को संदर्भ से बाहर रखें दिखाता है कि कैसे।
हर कॉल पर वही लंबा प्रॉम्प्ट
अपने प्रदाता से प्रॉम्प्ट कैशिंग के बारे में पूछें, जो हर बार नया पढ़ने के बजाय प्रॉम्प्ट की दोहराई गई शुरुआत का पुन: उपयोग कर सकता है।
यदि आप Claude Code का उपयोग करते हैं, तो इसे अपडेट करें और स्टेटस-लाइन नोट के लिए चेंजलॉग देखें।
लूप के लिए, DeepSeek-V4-Flash (deepseek-) आपको 380K संदर्भ, प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन और किसी भी समय एक ही मूल्य देता है। हमारे उदाहरण का 103,000-टोकन अंत उस विंडो में तीन गुना से अधिक फिट बैठता है। नोट्स और सारांश के लिए, GLM-5.3-Flash। अन्य मॉडल मॉडल पृष्ठ पर हैं।


