AI dla początkującychPrzewodnik
Dlaczego agent AI odczytuje całą swoją historię przy każdym kroku
Poprawka wiersza stanu w Claude Code pokazuje, dlaczego długie sesje agentów stają się drogie: każde wywołanie ponownie wysyła rozmowę. Oszacuj koszt i obetnij go.
Na tej stronie
Twój agent działał przez dziesięć minut, a rachunek jest większy, niż wygląda na to zadanie. Prawie zawsze powód jest ten sam: model nie pamięta niczego między wywołaniami, więc każdy krok ponownie wysyła całą dotychczasową rozmowę jako dane wejściowe. Sesja złożona z 50 kroków płaci za swoje pierwsze wiadomości 50 razy — dlatego koszt rośnie szybciej niż wykonana praca.
Poprawka, którą Anthropic ogłosił dla Claude Code 4–5 listopada 2026, pokazuje to w jednym małym miejscu. Poniżej: co się zmieniło, arytmetyka pętli 50 kroków i co możesz z tym zrobić.
Wiersz stanu, który odczytywał wszystko od nowa#
Claude Code potrafi uruchamiać podagentów w tle: agentów pomocniczych, którzy pracują nad zadaniem pobocznym, gdy ty robisz swoje. Każdy z nich pokazuje jednoliniowy status, coś w rodzaju „uruchamiam testy, 3 z 8 gotowe”.
Konto ClaudeDevs na X ogłosiło zmianę (post jest datowany na 5 listopada 2026; wtórne doniesienia mówią o 4 lub 5 listopada). Status odświeżał się co 30 sekund, a każde odświeżenie odczytywało całą rozmowę podagenta od nowa. Teraz Haiku 5.5 pisze status na podstawie krótkich notatek, co według Anthropic jest o około 99% tańsze na aktualizację. To liczba na aktualizację, nie na sesję: rzeczywista praca podagenta nadal odczytuje jego historię.
Wyobraź sobie, co oznaczał stary sposób. Załóżmy, że podagent ma 60 000 tokenów rozmowy po dwudziestu minutach. Sam status to może 30 tokenów. Ale żeby napisać te 30 tokenów, model musiał odczytać ponownie wszystkie 60 000, dwa razy na minutę, przez cały czas działania podagenta.
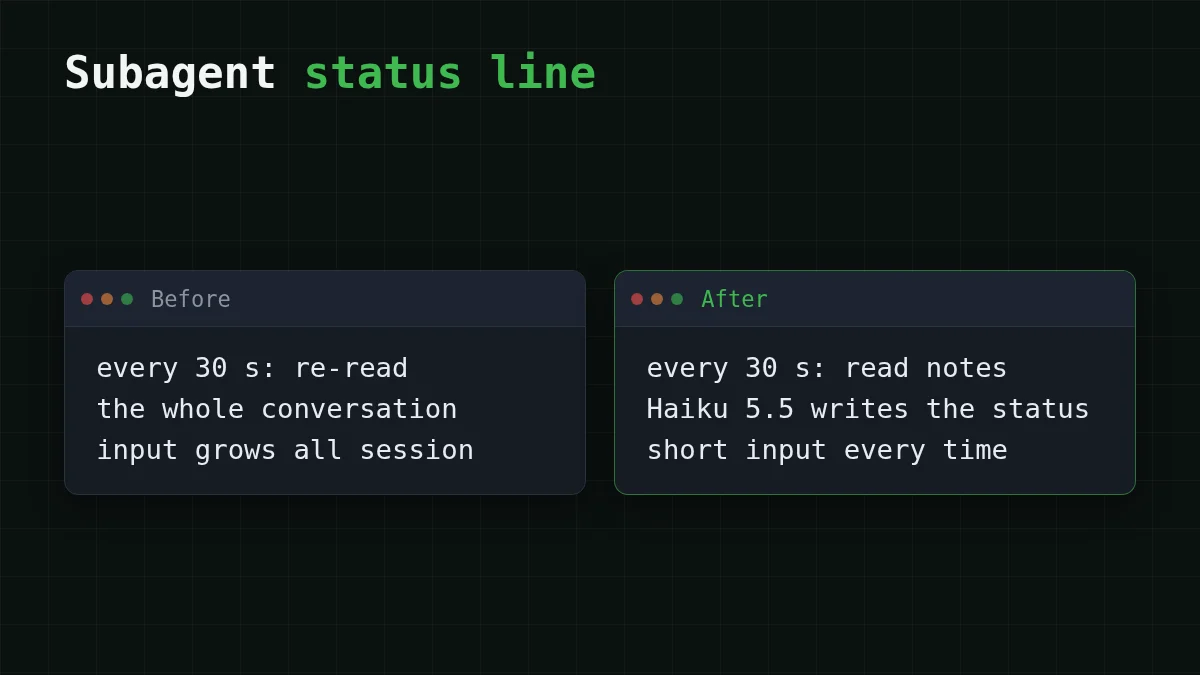
Nikomu nie trzeba pełnego zapisu, żeby powiedzieć „uruchamiam testy”. Wystarczy kilka linijek notatek (co robię, co jest skończone). To cała poprawka: daj zadaniu pobocznemu notatki, a nie zapis rozmowy.
Dlaczego każdy krok ponownie wysyła historię#
Pomyśl o liście do kogoś, kto zapomina cię w chwili, gdy odpowiada. Żeby kontynuować, wysyłasz całą korespondencję jeszcze raz plus nową linijkę. Krok agenta to dokładnie takie wywołanie: prompt systemowy, twoje zadanie, każda wcześniejsza odpowiedź i każdy wynik narzędzia trafiają tam ponownie. (Wersja tej historii w kontekście czatu jest w dlaczego długi czat AI kosztuje więcej.)
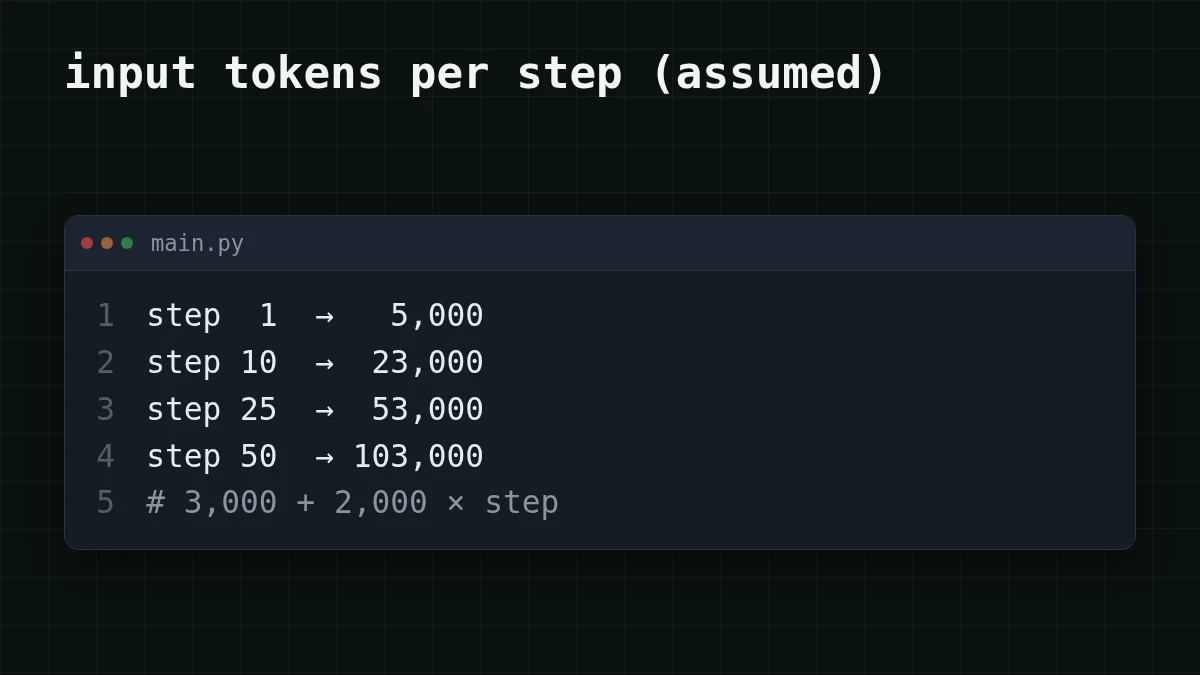
Podłóżmy liczby. Załóżmy, że prompt systemowy i zadanie zajmują 3000 tokenów, a każdy krok dodaje około 2000 (odpowiedź modelu plus odczytany wynik narzędzia). Krok n wysyła wtedy 3000 + 2000 × n tokenów: 5000 w kroku 1, 23 000 w kroku 10, 103 000 w kroku 50.
Zgadnij liczbę
Ile tokenów wejściowych wysyła krok 50 tego agenta?
Twoje przypuszczenie
0200 000
Pokaż odpowiedź
Odpowiedź: 103 000
3000 + 2000 × 50 = 103 000. Model odczytuje ponownie prompt startowy i wszystkie 49 wcześniejszych kroków, a na wierzch twój nowy krok.
Teraz zsumuj wszystkie 50 kroków. Rosnąca część to 2,000 × 1,275 = 2,550,000, gdzie 1275 to 1 + 2 + … + 50. Prompt startowy, wysyłany za każdym razem, to 50 × 3,000 = 150,000. Razem: 150,000 + 2,550,000 = 2,700,000 tokenów wejściowych. Gotowa rozmowa zawiera tylko 103 000. Przepchnąłeś przez model 2,7 miliona tokenów, żeby dostać zapis o rozmiarze 103 000 tokenów, a rachunek idzie za pierwszą liczbą.
Ile to kosztuje: jedno zadanie, jeden dzień#
Wyceńmy tego samego 50-krokowego agenta na DeepSeek-V4-Flash. Przeciętny krok wysyła 54 000 tokenów, więc w sumie 54,000 × 50 = 2,700,000 tokenów wejściowych, a zapisuje około 400 na krok (400 × 50 = 20,000). Całe zadanie kosztuje $0.0425. Oto to samo obciążenie na każdym modelu, jaki mamy, obok OpenRouter:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 50 żądań | OpenRouter, 50 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54 000 tokenów wejściowych i 400 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
W tabeli każdy model jest tańszy niż OpenRouter w sumie, licząc wejście i wyjście razem.
Teraz wiersz stanu. 120 aktualizacji to godzina jednego podagenta, a każda zapisuje około 30 tokenów (30 × 120 = 3,600 wyjścia). Stary sposób: 60,000 × 120 = 7,200,000 tokenów wejściowych, więcej niż dwa i pół z powyższych 50-krokowych zadań, wydanych na nic innego jak tekst statusu. Z notatką o 500 tokenach to 500 × 120 = 60,000. Na GLM-5.3-Flash to $0.144 wobec $0.0013.
Wypróbuj własnego agenta: tokeny na krok, kroki i zadania na dzień.
Kalkulator kosztów
Dzień dziesięciu takich zadań
Tokeny wejściowe na żądanie: 54 000 · Tokeny wyjściowe na żądanie: 400 · Żądania dziennie: 500
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Bazowy URL, klucz i pierwsze żądanie są w dokumentacji CheapTokens; aktualne ceny każdego modelu są na stronie z cenami.
Cztery sposoby, żeby to obciąć#
Żaden z nich nie wymaga specjalnego narzędzia. To nawyk pytania: czy to wywołanie naprawdę potrzebuje historii?
Wzorzec notatek#
Prowadź kilka linijek notatek, gdy agent pracuje, i przekazuj tylko je małemu modelowi, gdy potrzebujesz statusu lub podsumowania. Oto to na GLM-5.3-Flash (zai-, kontekst 390K, do 8192 tokenów wyjściowych na odpowiedź):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Dostajesz z powrotem jedną krótką linijkę, a para zużycia pokazuje wejście w dziesiątkach tokenów, nie dziesiątkach tysięcy. To ten sam pomysł co zmiana w Claude Code, w kilkunastu linijkach.
Który nawyk pasuje do twojego przypadku?
Wybierz swój przypadek
Jaka jest twoja sytuacja?
Wybierz opcję, aby zobaczyć odpowiedź
Jedna sesja, temat się zmienił
Zacznij nową sesję. Wklej pięć linijek notatek (cel, co zrobione, co dalej) zamiast starego zapisu. Opcje przycinania są w przycinanie historii czatu: okno przesuwne czy podsumowanie.
Zadanie poboczne: status, podsumowanie, tytuł
Daj mu notatki, nie historię, i wyślij je do małego modelu, jak w powyższym kodzie.
Ogromny wynik narzędzia: logi, zrzuty testów
Trzymaj go poza historią. Pokaż ostatnie 20 linii albo jeden nieudany test, nie cały zrzut: każda linia, którą zachowasz, jest ponownie wysyłana w każdym późniejszym kroku. Zużycie tokenów w Claude Code: trzymaj wyniki narzędzi poza kontekstem pokazuje jak.
Ten sam długi prompt przy każdym wywołaniu
Zapytaj swojego dostawcę o buforowanie promptów, które może ponownie wykorzystać powtarzany początek promptu zamiast odczytywać go od nowa za każdym razem.
Jeśli używasz Claude Code, zaktualizuj go i przejrzyj changelog w poszukiwaniu notatki o wierszu stanu.
Dla samej pętli DeepSeek-V4-Flash (deepseek-) daje ci kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź i jedną cenę o każdej porze. Koniec naszego przykładu na 103 000 tokenów mieści się w tym oknie ponad trzy razy. Do notatek i podsumowań — GLM-5.3-Flash. Inne modele są na stronie modeli.


