AI для новичковИнструкция
Почему ИИ-агент перечитывает всю историю на каждом шаге
Правка в Claude Code показывает, почему длинные сессии агента дорожают: каждый вызов заново шлёт всю переписку. Как оценить расход и снизить его.
Содержание
Ваш агент проработал десять минут, и счёт оказался больше, чем кажется по задаче. Почти всегда причина одна: модель ничего не помнит между вызовами, поэтому каждый шаг заново отправляет всю переписку как вход. Сессия из 50 шагов оплачивает первые сообщения 50 раз, и расход растёт быстрее, чем объём сделанной работы.
Правка, о которой Anthropic объявила для Claude Code 4–5 ноября 2026 года, показывает это на маленьком примере. Дальше: что изменилось, арифметика цикла из 50 шагов и что с этим делать.
Статус, который перечитывал всё#
Claude Code умеет запускать фоновых субагентов — помощников, которые берут побочную задачу, пока вы заняты своей. У каждого есть строка статуса вроде «запускаю тесты, готово 3 из 8».
Аккаунт ClaudeDevs в X объявил об изменении (пост датирован 5 ноября 2026 года; во вторичных источниках встречается и 4 ноября). Раньше статус обновлялся каждые 30 секунд, и при каждом обновлении перечитывался весь разговор субагента. Теперь статус по коротким заметкам пишет Haiku 5.5, и Anthropic оценивает это примерно на 99% дешевле за одно обновление. Это цифра на одно обновление, а не на всю сессию: настоящая работа субагента по-прежнему читает свою историю.
Представьте, что значил старый способ. Допустим, к двадцатой минуте у субагента 60 000 токенов переписки. Сам статус — токенов 30. Но чтобы написать эти 30, модели приходилось заново прочитать все 60 000. Дважды в минуту, пока субагент работает.
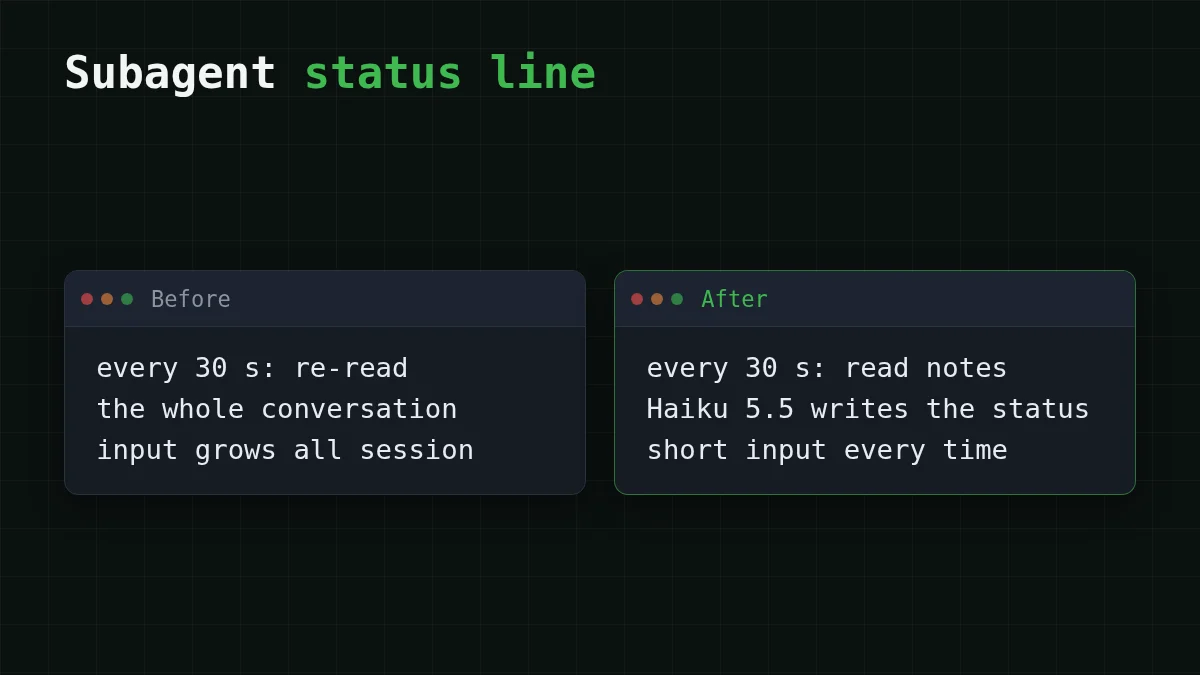
Чтобы сказать «запускаю тесты», полный протокол не нужен. Хватит нескольких строк заметок: что делаю, что уже готово. В этом и вся правка: побочной задаче отдают заметки, а не стенограмму.
Почему каждый шаг шлёт историю заново#
Представьте письмо человеку, который забывает вас, как только ответит. Чтобы продолжить, вы отправляете всю переписку целиком и новую строчку в конце. Шаг агента — ровно такой вызов: системный промпт, ваша задача, каждый прошлый ответ и каждый результат инструмента уходят снова. (Чатовую версию этой истории разбирает статья почему длинный чат с ИИ стоит дороже.)
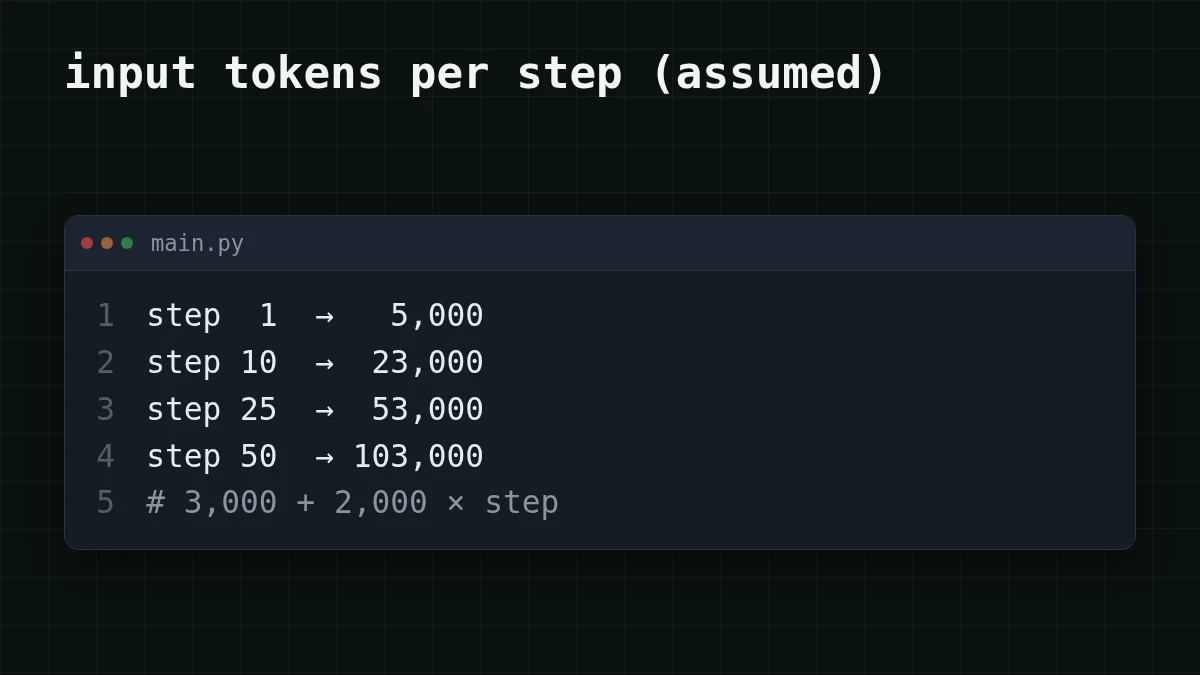
Посчитаем. Допустим, системный промпт и задача занимают 3 000 токенов, а каждый шаг добавляет около 2 000 (ответ модели плюс вывод инструмента, который она читает). Тогда шаг n отправляет 3 000 + 2 000 × n токенов: 5 000 на первом шаге, 23 000 на десятом, 103 000 на пятидесятом.
Угадайте число
Сколько токенов входа отправляет 50-й шаг этого агента?
Ваш вариант
0200 000
Показать ответ
Ответ: 103 000
3 000 + 2 000 × 50 = 103 000. Модель заново читает стартовый промпт и все 49 прошлых шагов, а сверху — ваш новый.
Теперь сложим все 50 шагов. Растущая часть: 2 000 × 1 275 = 2 550 000, где 1 275 — это 1 + 2 + … + 50. Стартовый промпт, который уходит каждый раз: 50 × 3 000 = 150 000. Вместе: 150 000 + 2 550 000 = 2 700 000 токенов входа. А готовая переписка в конце занимает всего 103 000. Вы прогнали через модель 2,7 миллиона токенов, чтобы получить стенограмму на 103 000, и счёт идёт по первому числу.
Сколько это стоит: задача и день#
Оценим тот же агент на 50 шагов на DeepSeek-V4-Flash. В среднем шаг отправляет 54 000 токенов, то есть 54 000 × 50 = 2 700 000 токенов входа за задачу, и пишет около 400 на шаг (400 × 50 = 20 000). Вся задача обойдётся в $0.0425. Та же нагрузка на всех наших моделях, рядом с OpenRouter:
| Модель | Вход $/1M | Выход $/1M | За запрос | 50 запросов | OpenRouter, 50 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54 000 входных и 400 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
В таблице каждая модель в сумме, с учётом входа и выхода, дешевле OpenRouter.
Теперь строка статуса. 120 обновлений — это час работы одного субагента, и каждое пишет около 30 токенов (30 × 120 = 3 600 выхода). Старый способ: 60 000 × 120 = 7 200 000 токенов входа — больше двух с половиной задач на 50 шагов из примера выше, и всё ради одной строчки статуса. С заметкой на 500 токенов выходит 500 × 120 = 60 000. На GLM-5.3-Flash это $0.144 против $0.0013.
Подставьте своего агента: токены на шаг, шаги и задачи в день.
Калькулятор стоимости
День из десяти таких задач
Входные токены на запрос: 54 000 · Выходные токены на запрос: 400 · Запросов в день: 500
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL, ключ и первый запрос — в документации CheapTokens; актуальные цены всех моделей — на странице цен.
Четыре способа сократить расход#
Специальных инструментов не нужно. Нужна привычка спрашивать себя: а этому вызову правда нужна история?
Заметки вместо стенограммы#
Ведите несколько строк заметок, пока агент работает, и отдавайте маленькой модели только их, когда нужен статус или краткое резюме. Вот это на GLM-5.3-Flash (zai-, контекст 390K, до 8 192 токенов в ответе):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Вернётся одна короткая строка, а пара чисел usage покажет вход в десятки токенов, а не в десятки тысяч. Это та же идея, что в правке Claude Code, только в дюжину строк.
Какая привычка подходит вам?
Выберите свой случай
Какая у вас ситуация?
Выберите вариант, чтобы увидеть ответ
Одна сессия, тема сменилась
Начните новую сессию. Вставьте пять строк заметок (цель, что сделано, что дальше) вместо старой стенограммы. Варианты сокращения истории — в статье как обрезать историю чата: скользящее окно или резюме.
Побочная задача: статус, резюме, заголовок
Отдайте ей заметки, а не историю, и пошлите маленькой модели — как в коде выше.
Огромный вывод инструментов: логи, дампы тестов
Не пускайте его в историю. Покажите последние 20 строк или один упавший тест, а не весь дамп: каждая оставленная строка уходит заново на каждом следующем шаге. Как это сделать — в статье расход токенов в Claude Code: вывод инструментов вне контекста.
Один и тот же длинный промпт в каждом вызове
Спросите у провайдера про кэширование промпта: оно может переиспользовать повторяющееся начало, а не читать его каждый раз заново.
Если вы работаете в Claude Code, обновите его и поищите заметку про строку статуса в списке изменений.
Для самого цикла подойдёт DeepSeek-V4-Flash (deepseek-): контекст 380K, до 32 768 токенов в ответе и одна цена в любое время суток. Конец нашего примера на 103 000 токенов помещается в это окно больше трёх раз. Для заметок и резюме — GLM-5.3-Flash. Остальные модели — на странице моделей.


