KI für EinsteigerAnleitung
Warum ein KI-Agent bei jedem Schritt seine gesamte Historie neu liest
Eine Claude-Code-Statuszeilen-Korrektur zeigt, warum lange Agent-Sitzungen teuer werden: Jeder Aufruf sendet die Konversation erneut. Schätze die Kosten und senke sie.
Auf dieser Seite
Dein Agent lief zehn Minuten, und die Rechnung ist größer, als die Aufgabe aussieht. Fast immer ist der Grund derselbe: Das Modell erinnert sich zwischen Aufrufen an nichts, also schickt jeder Schritt die gesamte bisherige Konversation erneut als Eingabe. Eine Sitzung mit 50 Schritten zahlt für ihre ersten Nachrichten 50-mal, weshalb die Kosten schneller wachsen als die erledigte Arbeit.
Eine Korrektur, die Anthropic am 4.–5. November 2026 für Claude Code angekündigt hat, zeigt das an einer kleinen Stelle. Unten: was sich geändert hat, die Arithmetik einer 50-Schritt-Schleife und was du dagegen tun kannst.
Eine Statuszeile, die alles neu las#
Claude Code kann Hintergrund-Subagenten starten: Hilfsagenten, die an einer Nebenaufgabe arbeiten, während du weitermachst. Jeder zeigt eine einzeilige Statusmeldung, etwa „Tests laufen, 3 von 8 erledigt“.
Das Konto ClaudeDevs auf X kündigte die Änderung an (der Beitrag ist vom 5. November 2026 datiert; Sekundärberichte nennen den 4. oder 5. November). Der Status wurde früher alle 30 Sekunden aktualisiert, und jede Aktualisierung las die gesamte Konversation des Subagenten neu. Jetzt schreibt Haiku 5.5 den Status aus kurzen Notizen, und Anthropic beziffert das auf etwa 99 % günstiger pro Aktualisierung. Das ist ein Wert pro Aktualisierung, nicht pro Sitzung: Die eigentliche Arbeit des Subagenten liest weiterhin seine Historie.
Stell dir vor, was die alte Methode bedeutete. Sagen wir, ein Subagent hat nach zwanzig Minuten 60.000 Tokens Konversation. Der Status selbst sind vielleicht 30 Tokens. Aber um diese 30 Tokens zu schreiben, musste das Modell alle 60.000 erneut lesen, zweimal pro Minute, solange der Subagent lief.
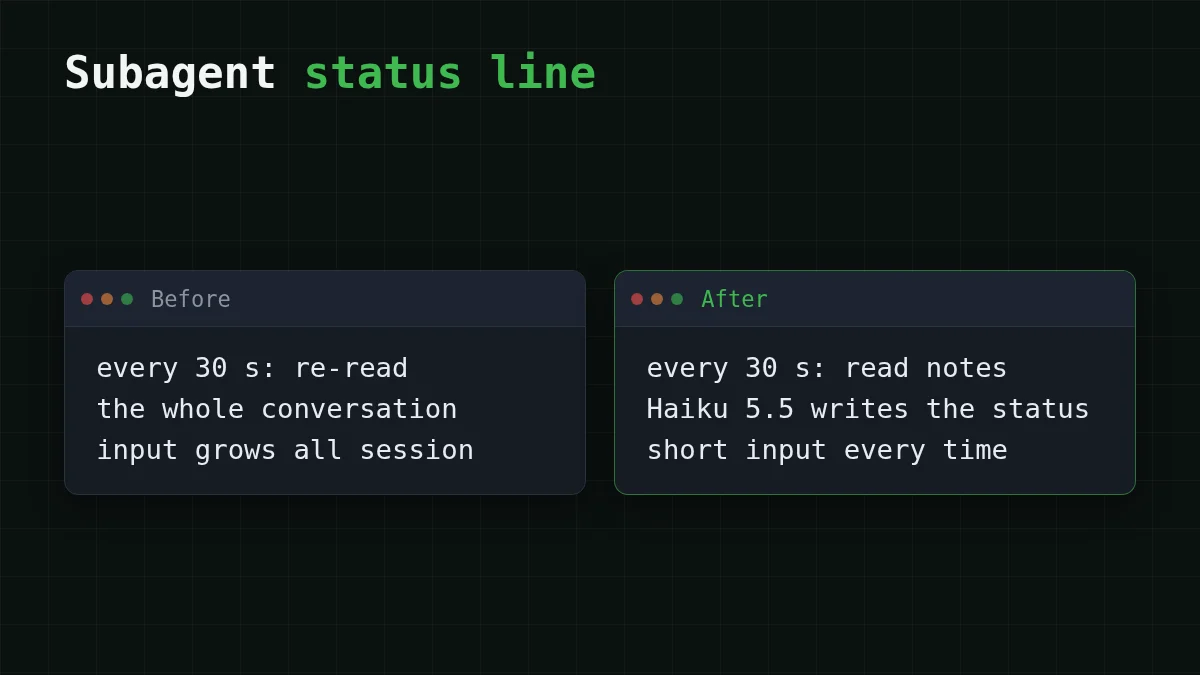
Niemand braucht das vollständige Transkript, um „Tests laufen“ zu sagen. Ein paar Zeilen Notizen (was ich tue, was fertig ist) reichen. Das ist die ganze Korrektur: Gib einer Nebenaufgabe die Notizen, nicht das Transkript.
Warum jeder Schritt die Historie erneut sendet#
Denk an einen Brief an jemanden, der dich vergisst, sobald er antwortet. Um fortzufahren, schickst du die ganze Korrespondenz plus die neue Zeile erneut. Ein Agent-Schritt ist genau dieser Aufruf: der System-Prompt, deine Aufgabe, jede frühere Antwort und jedes Tool-Ergebnis gehen wieder mit hinein. (Die Chat-Version dieser Geschichte steht in warum ein langer KI-Chat mehr kostet.)
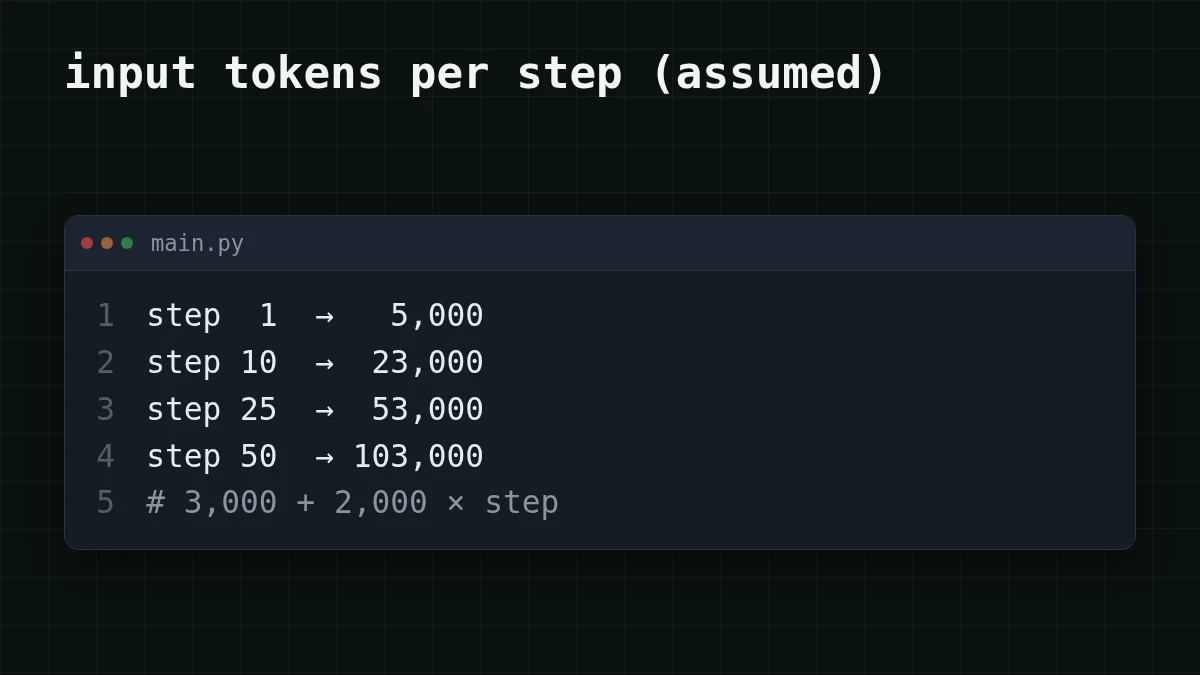
Setzen wir Zahlen darauf. Sagen wir, der System-Prompt und die Aufgabe umfassen 3.000 Tokens, und jeder Schritt fügt etwa 2.000 hinzu (die Antwort des Modells plus die Tool-Ausgabe, die es liest). Schritt n sendet dann 3.000 + 2.000 × n Tokens: 5.000 bei Schritt 1, 23.000 bei Schritt 10, 103.000 bei Schritt 50.
Zahl erraten
Wie viele Eingabe-Tokens sendet Schritt 50 dieses Agenten?
Deine Schätzung
0200.000
Antwort anzeigen
Antwort: 103.000
3.000 + 2.000 × 50 = 103.000. Das Modell liest den Start-Prompt und alle 49 früheren Schritte erneut und dann deinen neuen Schritt obendrauf.
Jetzt summiere alle 50 Schritte. Der wachsende Teil ist 2,000 × 1,275 = 2,550,000, wobei 1.275 = 1 + 2 + … + 50 ist. Der Start-Prompt, jedes Mal gesendet, ist 50 × 3,000 = 150,000. Zusammen: 150,000 + 2,550,000 = 2,700,000 Eingabe-Tokens. Die fertige Konversation umfasst nur 103.000. Du hast 2,7 Millionen Tokens durch das Modell geschickt, um ein Transkript mit 103.000 Tokens zu erhalten, und die Rechnung folgt der ersten Zahl.
Was es kostet: eine Aufgabe, ein Tag#
Bepreise denselben 50-Schritt-Agenten auf DeepSeek-V4-Flash. Der durchschnittliche Schritt sendet 54.000 Tokens, also insgesamt 54,000 × 50 = 2,700,000 Eingabe-Tokens, und er schreibt etwa 400 pro Schritt (400 × 50 = 20,000). Die ganze Aufgabe kostet $0.0425. Hier ist dieselbe Arbeitslast auf jedem Modell, das wir haben, neben OpenRouter:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 50 Anfragen | OpenRouter, 50 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 Input- und 400 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
In der Tabelle ist jedes Modell insgesamt günstiger als OpenRouter, wobei Eingabe und Ausgabe zusammengezählt sind.
Jetzt die Statuszeile. 120 Aktualisierungen sind eine Stunde eines Subagenten, und jede schreibt etwa 30 Tokens (30 × 120 = 3,600 Ausgabe). Die alte Methode: 60,000 × 120 = 7,200,000 Eingabe-Tokens, mehr als zweieinhalb der obigen 50-Schritt-Aufgaben, ausgegeben für nichts als einen Statustext. Mit einer 500-Token-Notiz sind es 500 × 120 = 60,000. Auf GLM-5.3-Flash sind das $0.144 gegenüber $0.0013.
Probiere deinen eigenen Agenten aus: Tokens pro Schritt, Schritte und Aufgaben pro Tag.
Kostenrechner
Ein Tag mit zehn solchen Aufgaben
Eingabe-Tokens pro Anfrage: 54.000 · Ausgabe-Tokens pro Anfrage: 400 · Anfragen pro Tag: 500
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base-URL, Key und eine erste Anfrage stehen in der CheapTokens-Doku; aktuelle Preise für jedes Modell findest du auf der Preisseite.
Vier Wege, es zu senken#
Nichts davon braucht ein spezielles Tool. Es ist die Gewohnheit zu fragen: Braucht dieser Aufruf wirklich die Historie?
Das Notizen-Muster#
Halte ein paar Zeilen Notizen fest, während der Agent arbeitet, und gib nur diese an ein kleines Modell, wenn du einen Status oder eine Zusammenfassung brauchst. Hier auf GLM-5.3-Flash (zai-, 390K Kontext, bis zu 8.192 Ausgabe-Tokens pro Antwort):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Du bekommst eine kurze Zeile zurück, und das Usage-Paar zeigt Eingabe in Zehnern von Tokens, nicht in Zehntausenden. Das ist dieselbe Idee wie die Claude-Code-Änderung, in einem Dutzend Zeilen.
Welche Gewohnheit passt zu deinem Fall?
Wähle deinen Fall
Wie ist deine Situation?
Wähle eine Option, um die Antwort zu sehen
Eine Sitzung, das Thema hat gewechselt
Starte eine frische Sitzung. Füge fünf Zeilen Notizen ein (Ziel, was erledigt ist, was als Nächstes kommt) statt des alten Transkripts. Die Kürzungsoptionen stehen in Chat-Historie kürzen: gleitendes Fenster oder Zusammenfassung.
Eine Nebenaufgabe: Status, Zusammenfassung, Titel
Gib ihr die Notizen, nicht die Historie, und schicke sie an ein kleines Modell, wie im Code oben.
Riesige Tool-Ausgabe: Logs, Test-Dumps
Halte sie aus der Historie heraus. Zeige die letzten 20 Zeilen oder den einen fehlschlagenden Test, nicht den ganzen Dump: Jede Zeile, die du behältst, wird bei jedem späteren Schritt erneut gesendet. Claude Code Token-Nutzung: Tool-Ausgabe aus dem Kontext heraushalten zeigt, wie.
Derselbe lange Prompt bei jedem Aufruf
Frag deinen Anbieter nach Prompt-Caching, das einen wiederholten Anfang des Prompts wiederverwenden kann, statt ihn jedes Mal neu zu lesen.
Wenn du Claude Code nutzt, aktualisiere es und sieh im Changelog nach dem Hinweis zur Statuszeile.
Für die Schleife selbst gibt dir DeepSeek-V4-Flash (deepseek-) einen 380K-Kontext, bis zu 32.768 Ausgabe-Tokens pro Antwort und einen Preis zu jeder Stunde. Das 103.000-Token-Ende unseres Beispiels passt mehr als dreimal in dieses Fenster. Für Notizen und Zusammenfassungen: GLM-5.3-Flash. Weitere Modelle stehen auf der Modellseite.


