Bakit muling binabasa ng isang AI agent ang buong kasaysayan nito sa bawat hakbang
Ang isang pag-aayos sa status-line ng Claude Code ay nagpapakita kung bakit nagiging mahal ang mahabang sesyon ng agent: bawat tawag ay muling nagpapadala ng pag-uusap. Tantiyahin ang gastos at bawasan ito.
Sa pahinang ito
Ang iyong agent ay tumakbo ng sampung minuto, at ang bill ay mas malaki kaysa sa hitsura ng gawain. Halos palagi ang dahilan ay pareho: walang natatandaan ang modelo sa pagitan ng mga tawag, kaya bawat hakbang ay ipinapadala muli ang buong pag-uusap hanggang ngayon bilang input. Ang isang 50-hakbang na sesyon ay nagbabayad para sa mga unang mensahe nito ng 50 beses, kaya mas mabilis lumaki ang gastos kaysa sa gawaing nagawa.
Ang isang pag-aayos na inanunsyo ng Anthropic para sa Claude Code noong 4–5 Nobyembre 2026 ay nagpapakita nito sa isang maliit na lugar. Sa ibaba: ano ang nagbago, ang aritmetika ng isang 50-hakbang na loop, at ano ang maaari mong gawin tungkol dito.
Isang status line na muling nagbasa ng lahat#
Maaaring magsimula ang Claude Code ng mga background subagent: mga helper agent na nagtatrabaho sa isang side job habang nagpapatuloy ka. Ang bawat isa ay nagpapakita ng isang linyang status, tulad ng 'running tests, 3 of 8 done'.
Ang ClaudeDevs account sa X ay nag-anunsyo ng pagbabago (ang post ay may petsang 5 Nobyembre 2026; sinasabi ng mga sekondaryang ulat na 4 o 5 Nobyembre). Ang status ay dating nagre-refresh tuwing 30 segundo, at ang bawat refresh ay muling nagbabasa ng buong pag-uusap ng subagent. Ngayon, ang Haiku 5.5 ay nagsusulat ng status mula sa maiikling tala, at inilalagay ng Anthropic iyon sa halos 99% na mas mura bawat update. Iyon ay isang per-update na figure, hindi per-session: ang tunay na gawain ng subagent ay nagbabasa pa rin ng kasaysayan nito.
Isipin kung ano ang ibig sabihin ng lumang paraan. Sabihin nating ang isang subagent ay may 60,000 token ng pag-uusap sa ika-dalawampung minuto. Ang status mismo ay marahil 30 token. Ngunit upang isulat ang 30 token na iyon, kailangang basahin muli ng modelo ang lahat ng 60,000, dalawang beses sa isang minuto, hangga't tumatakbo ang subagent.
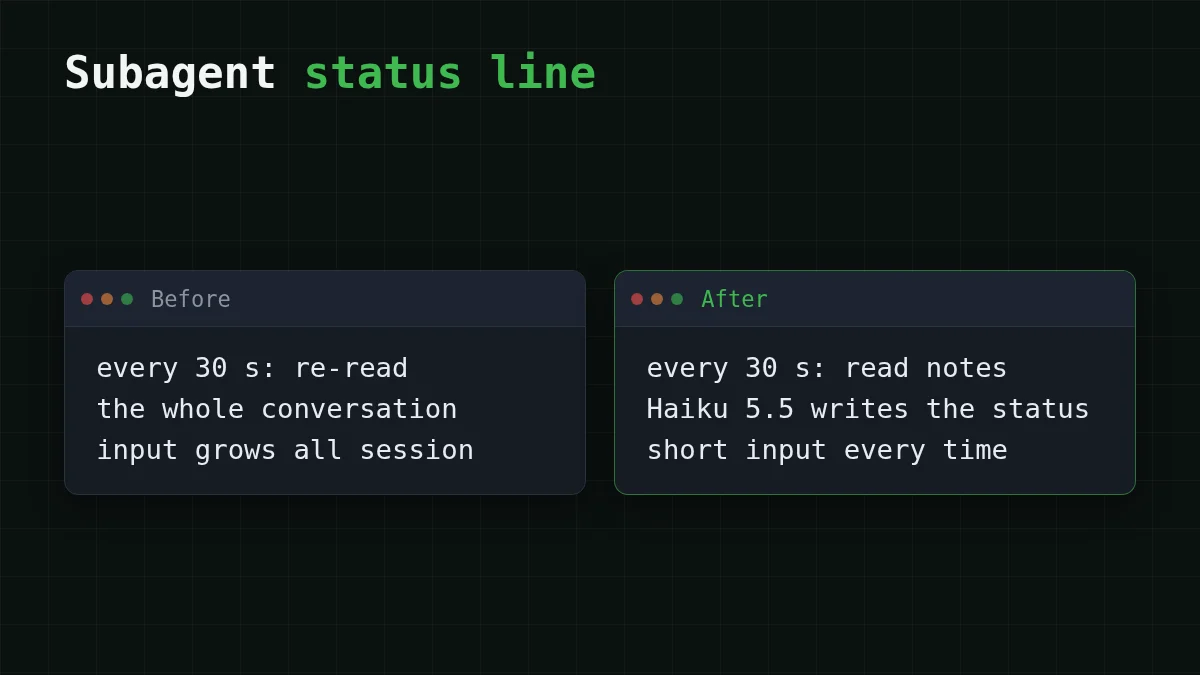
Walang nangangailangan ng buong transcript upang sabihin ang 'running tests'. Sapat na ang ilang linya ng tala (ano ang ginagawa ko, ano ang tapos na). Iyon ang buong pag-aayos: bigyan ang isang side task ng mga tala, hindi ang transcript.
Bakit bawat hakbang ay muling nagpapadala ng kasaysayan#
Isipin ang isang liham sa isang taong nakakalimot sa iyo sa sandaling sumagot sila. Upang magpatuloy, ipinapadala mo muli ang buong sulat-kamay kasama ang bagong linya. Ang isang hakbang ng agent ay eksaktong ganoong tawag: ang system prompt, ang iyong gawain, bawat naunang sagot at bawat resulta ng tool ay pumapasok muli. (Ang bersyon ng chat ng kuwentong ito ay nasa bakit mas mahal ang isang mahabang AI chat.)
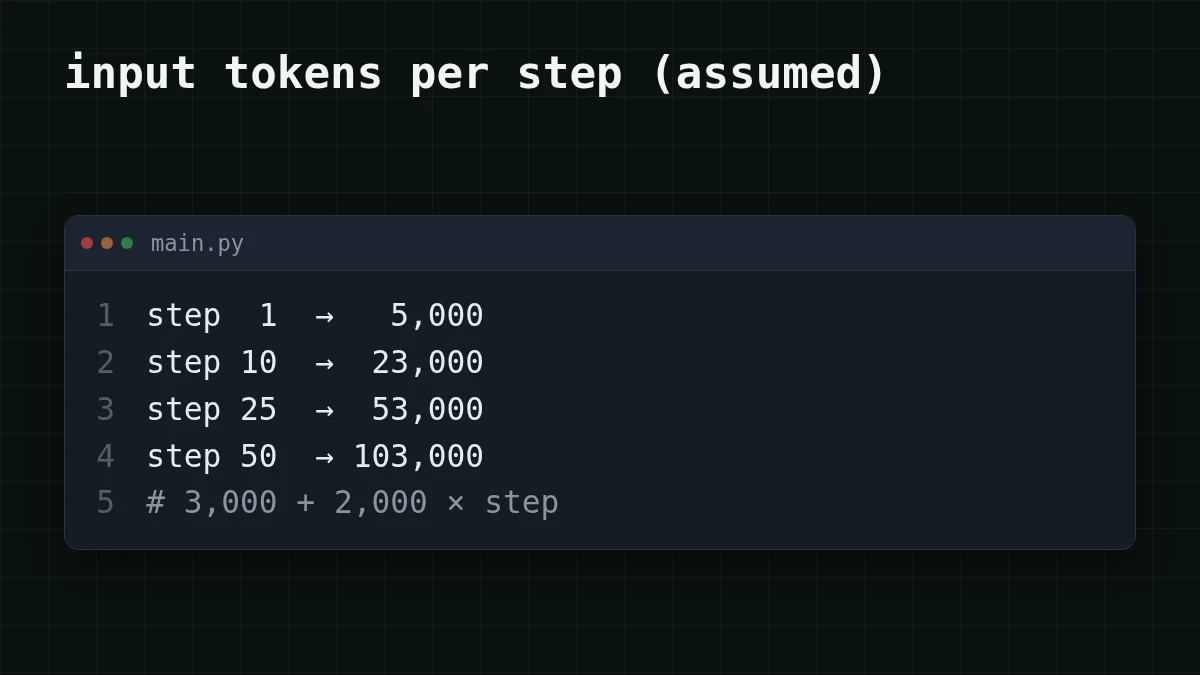
Lagyan natin ng numero. Sabihin nating ang system prompt at ang gawain ay kumukuha ng 3,000 token, at ang bawat hakbang ay nagdadagdag ng mga 2,000 (ang sagot ng modelo kasama ang output ng tool na binabasa nito). Ang hakbang n ay nagpapadala ng 3,000 + 2,000 × n token: 5,000 sa hakbang 1, 23,000 sa hakbang 10, 103,000 sa hakbang 50.
Hulaan ang numero
Ilang input token ang ipinapadala ng hakbang 50 ng agent na ito?
Ang iyong hula
0200,000
Ipakita ang sagot
Sagot: 103,000
3,000 + 2,000 × 50 = 103,000. Muling binabasa ng modelo ang start prompt at lahat ng 49 naunang hakbang, pagkatapos ang iyong bagong hakbang sa ibabaw.
Ngayon pagsamahin ang lahat ng 50 hakbang. Ang lumalaking bahagi ay 2,000 × 1,275 = 2,550,000, kung saan ang 1,275 ay 1 + 2 + … + 50. Ang panimulang prompt, na ipinapadala tuwing oras, ay 50 × 3,000 = 150,000. Magkasama: 150,000 + 2,550,000 = 2,700,000 input token. Ang natapos na pag-uusap ay mayroon lamang 103,000. Nagpadala ka ng 2.7 milyong token sa modelo upang makakuha ng 103,000-token na transcript, at ang bill ay sumusunod sa unang numero.
Magkano ang gastos: isang gawain, isang araw#
Presyuhan ang parehong 50-hakbang na agent sa DeepSeek-V4-Flash. Ang average na hakbang ay nagpapadala ng 54,000 token, kaya 54,000 × 50 = 2,700,000 input token sa kabuuan, at ito ay nagsusulat ng mga 400 bawat hakbang (400 × 50 = 20,000). Ang buong gawain ay nagkakahalaga ng $0.0425. Narito ang parehong workload sa bawat modelo na mayroon kami, sa tabi ng OpenRouter:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 50 mga kahilingan | OpenRouter, 50 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54,000 input at 400 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Sa talahanayan, ang bawat modelo ay mas mura kaysa sa OpenRouter sa kabuuan, kasama ang input at output na binibilang nang magkasama.
Ngayon ang status line. Ang 120 update ay isang oras ng isang subagent, at ang bawat isa ay nagsusulat ng mga 30 token (30 × 120 = 3,600 output). Ang lumang paraan: 60,000 × 120 = 7,200,000 input token, higit sa dalawa at kalahati ng 50-hakbang na gawain sa itaas, na ginugol sa wala kundi isang status text. Sa isang 500-token na tala ito ay 500 × 120 = 60,000. Sa GLM-5.3-Flash iyon ay $0.144 laban sa $0.0013.
Subukan ang iyong sariling agent: token bawat hakbang, hakbang at gawain bawat araw.
Calculator ng gastos
Isang araw ng sampung ganoong gawain
Mga input token bawat kahilingan: 54,000 · Mga output token bawat kahilingan: 400 · Mga kahilingan bawat araw: 500
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Ang Base URL, key at isang unang request ay nasa CheapTokens docs; ang kasalukuyang presyo para sa bawat modelo ay nasa pricing page.
Apat na paraan upang bawasan ito#
Wala sa mga ito ang nangangailangan ng espesyal na tool. Ito ay isang ugali ng pagtatanong: kailangan ba talaga ng tawag na ito ang kasaysayan?
Ang pattern ng mga tala#
Magtabi ng ilang linya ng tala habang nagtatrabaho ang agent, at ibigay lamang ang mga iyon sa isang maliit na modelo kapag kailangan mo ng status o summary. Narito ito sa GLM-5.3-Flash (zai-, 390K context, hanggang 8,192 output token bawat sagot):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Makakakuha ka ng isang maikling linya, at ang usage pair ay nagpapakita ng input sa sampu-sampung token, hindi sampu-sampung libo. Iyon ang parehong ideya ng pagbabago sa Claude Code, sa isang dosenang linya.
Aling ugali ang umaangkop sa iyong kaso?
Piliin ang iyong kaso
Ano ang iyong sitwasyon?
Pumili ng opsyon upang makita ang sagot
Isang sesyon, nagbago ang paksa
Magsimula ng bagong sesyon. I-paste ang limang linya ng tala (layunin, ano ang tapos na, ano ang susunod) sa halip na ang lumang transcript. Ang mga opsyon sa pag-trim ay nasa trim chat history: sliding window o summary.
Isang side job: status, summary, title
Ibigay ang mga tala, hindi ang kasaysayan, at ipadala ito sa isang maliit na modelo, tulad ng sa code sa itaas.
Malaking tool output: mga log, test dump
Panatilihin itong labas ng kasaysayan. Ipakita ang huling 20 linya o ang isang nabigong test, hindi ang buong dump: bawat linyang pinapanatili mo ay muling ipinapadala sa bawat susunod na hakbang. Ipinapakita ng Claude Code token usage: keep tool output out of context kung paano.
Ang parehong mahabang prompt sa bawat tawag
Magtanong sa iyong provider tungkol sa prompt caching, na maaaring muling gamitin ang paulit-ulit na simula ng prompt sa halip na basahin itong bago tuwing oras.
Kung gumagamit ka ng Claude Code, i-update ito at tingnan ang changelog para sa tala sa status-line.
Para sa loop mismo, ang DeepSeek-V4-Flash (deepseek-) ay nagbibigay sa iyo ng 380K context, hanggang 32,768 output token bawat sagot at isang presyo sa anumang oras. Ang 103,000-token na dulo ng aming halimbawa ay kasya sa window na iyon ng higit sa tatlong beses. Para sa mga tala at summary, GLM-5.3-Flash. Ang iba pang mga modelo ay nasa models page.


