نئے سیکھنے والوں کے لیے AIگائیڈ
AI ایجنٹ ہر قدم پر اپنی پوری تاریخ کیوں دوبارہ پڑھتا ہے
Claude Code کی اسٹیٹس لائن کی درستی دکھاتی ہے کہ لمبے ایجنٹ سیشن مہنگے کیوں ہوتے ہیں: ہر کال گفتگو دوبارہ بھیجتی ہے۔ لاگت کا اندازہ لگائیں اور اسے کم کریں۔
اس صفحہ پر
آپ کا ایجنٹ دس منٹ تک چلا، اور بل کام کے حجم سے بڑا ہے۔ تقریباً ہمیشہ وجہ ایک ہی ہوتی ہے: ماڈل کالز کے درمیان کچھ یاد نہیں رکھتا، اس لیے ہر قدم اب تک کی پوری گفتگو دوبارہ بطور ان پٹ بھیجتا ہے۔ 50 قدموں کا سیشن اپنے پہلے پیغامات کی قیمت 50 بار ادا کرتا ہے، اسی لیے لاگت کیے گئے کام سے زیادہ تیزی سے بڑھتی ہے۔
Anthropic نے 4–5 نومبر 2026 کو Claude Code کے لیے جو حل اعلان کیا، وہ یہ ایک چھوٹی سی جگہ پر دکھاتا ہے۔ نیچے: کیا بدلا، 50 قدموں کے لوپ کا حساب، اور آپ اس بارے میں کیا کر سکتے ہیں۔
ایک اسٹیٹس لائن جو سب کچھ دوبارہ پڑھتی تھی#
Claude Code پس منظر میں ذیلی ایجنٹس شروع کر سکتا ہے: مددگار ایجنٹس جو آپ کے کام جاری رکھتے ہوئے ضمنی کام پر کام کرتے ہیں۔ ہر ایک ایک سطر کا اسٹیٹس دکھاتا ہے، جیسے 'ٹیسٹ چل رہے ہیں، 8 میں سے 3 مکمل'۔
X پر ClaudeDevs اکاؤنٹ نے تبدیلی کا اعلان کیا (پوسٹ کی تاریخ 5 نومبر 2026 ہے؛ ثانوی رپورٹس 4 یا 5 نومبر کہتی ہیں)۔ اسٹیٹس پہلے ہر 30 سیکنڈ میں تازہ ہوتا تھا، اور ہر تازہ کاری ذیلی ایجنٹ کی پوری گفتگو دوبارہ پڑھتی تھی۔ اب Haiku 5.5 مختصر نوٹس سے اسٹیٹس لکھتا ہے، اور Anthropic اسے فی اپ ڈیٹ تقریباً 99% سستا بتاتا ہے۔ یہ فی اپ ڈیٹ عدد ہے، فی سیشن نہیں: ذیلی ایجنٹ کا اصل کام اب بھی اپنی تاریخ پڑھتا ہے۔
سوچیں پرانے طریقے کا مطلب کیا تھا۔ فرض کریں بیسویں منٹ تک ذیلی ایجنٹ کے پاس 60,000 ٹوکن کی گفتگو ہے۔ اسٹیٹس خود شاید 30 ٹوکن ہے۔ لیکن وہ 30 ٹوکن لکھنے کے لیے ماڈل کو پورے 60,000 دوبارہ پڑھنے پڑتے تھے، منٹ میں دو بار، جب تک ذیلی ایجنٹ چلتا رہے۔
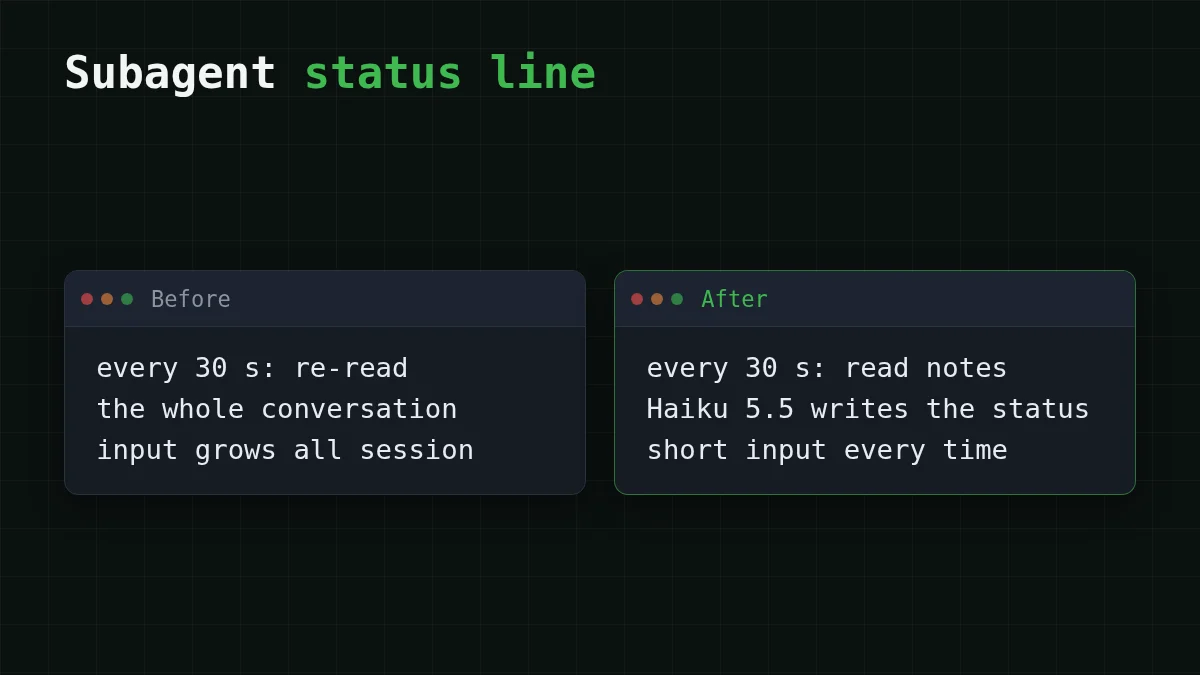
'ٹیسٹ چل رہے ہیں' کہنے کے لیے کسی کو پوری نقل درکار نہیں۔ چند سطری نوٹس (میں کیا کر رہا ہوں، کیا مکمل ہوا) کافی ہیں۔ یہی پورا حل ہے: ضمنی کام کو نقل نہیں، نوٹس دیں۔
ہر قدم تاریخ کیوں دوبارہ بھیجتا ہے#
ایسے شخص کو خط لکھنے کا سوچیں جو جواب دیتے ہی آپ کو بھول جاتا ہے۔ جاری رکھنے کے لیے، آپ پوری خط و کتابت دوبارہ بھیجتے ہیں اور نئی سطر شامل کرتے ہیں۔ ایجنٹ کا قدم بالکل وہی کال ہے: سسٹم پرامپٹ، آپ کا کام، ہر پچھلا جواب اور ہر ٹول کا نتیجہ دوبارہ اندر جاتا ہے۔ (اس کہانی کا چیٹ ورژن لمبی AI چیٹ زیادہ مہنگی کیوں ہوتی ہے میں ہے۔)
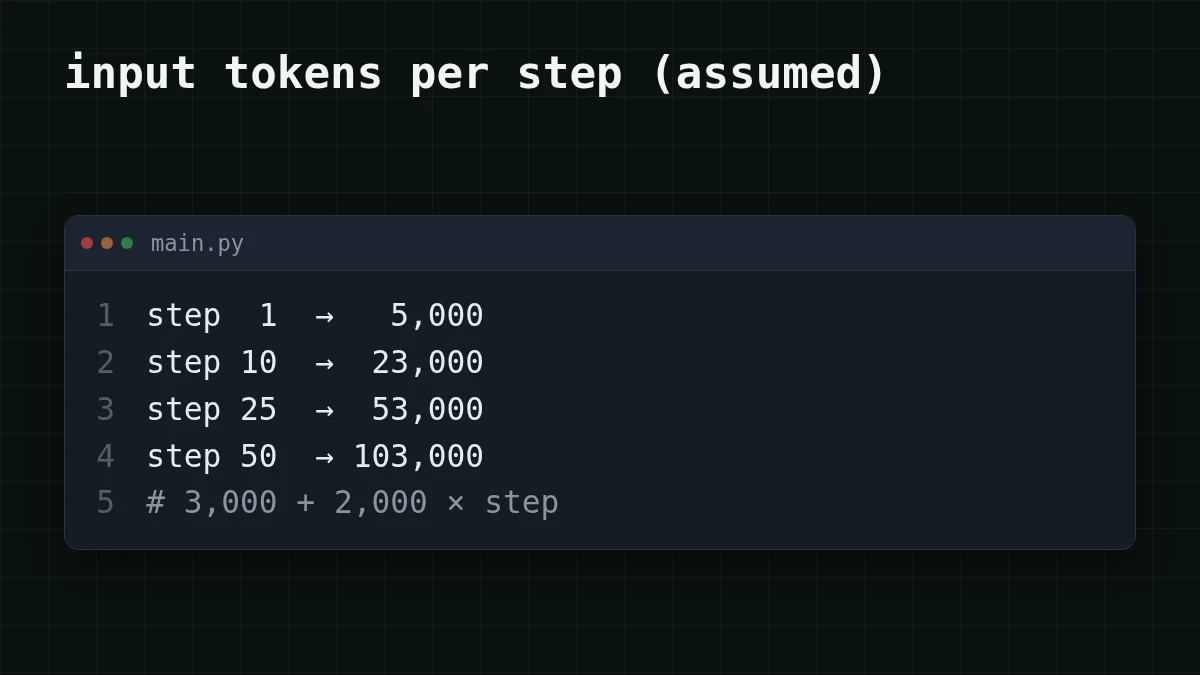
آئیے اس پر اعداد ڈالیں۔ فرض کریں سسٹم پرامپٹ اور کام 3,000 ٹوکن لیتے ہیں، اور ہر قدم تقریباً 2,000 جوڑتا ہے (ماڈل کا جواب اور وہ ٹول آؤٹ پٹ جو وہ پڑھتا ہے)۔ پھر قدم n بھیجتا ہے 3,000 + 2,000 × n ٹوکن: قدم 1 پر 5,000، قدم 10 پر 23,000، قدم 50 پر 103,000۔
نمبر کا اندازہ لگائیں
اس ایجنٹ کا قدم 50 کتنے ان پٹ ٹوکن بھیجتا ہے؟
آپ کا اندازہ
0200,000
جواب دکھائیں
جواب: 103,000
3,000 + 2,000 × 50 = 103,000۔ ماڈل آغاز کا پرامپٹ اور تمام 49 پچھلے قدم دوبارہ پڑھتا ہے، پھر اس کے اوپر آپ کا نیا قدم۔
اب تمام 50 قدم جمع کریں۔ بڑھتا ہوا حصہ 2,000 × 1,275 = 2,550,000 ہے، جہاں 1,275 = 1 + 2 + … + 50۔ آغاز کا پرامپٹ، جو ہر بار بھیجا جاتا ہے، 50 × 3,000 = 150,000 ہے۔ مل کر: 150,000 + 2,550,000 = 2,700,000 ان پٹ ٹوکن۔ مکمل گفتگو صرف 103,000 رکھتی ہے۔ آپ نے 103,000 ٹوکن کی نقل حاصل کرنے کے لیے 2.7 ملین ٹوکن ماڈل سے گزارے، اور بل پہلے عدد کے مطابق آتا ہے۔
اس کی قیمت: ایک کام، ایک دن#
اسی 50 قدموں کے ایجنٹ کی قیمت DeepSeek-V4-Flash پر لگائیں۔ اوسط قدم 54,000 ٹوکن بھیجتا ہے، تو کل 54,000 × 50 = 2,700,000 ان پٹ ٹوکن، اور یہ فی قدم تقریباً 400 لکھتا ہے (400 × 50 = 20,000)۔ پورے کام کی قیمت $0.0425 ہے۔ یہی کام ہمارے ہر ماڈل پر، OpenRouter کے ساتھ:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 50 درخواستیں | OpenRouter، 50 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
فی درخواست 54,000 ان پٹ اور 400 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
ٹیبل میں، ہر ماڈل کل میں OpenRouter سے سستا ہے، ان پٹ اور آؤٹ پٹ ملا کر۔
اب اسٹیٹس لائن۔ 120 اپ ڈیٹس ایک ذیلی ایجنٹ کا ایک گھنٹہ ہیں، اور ہر ایک تقریباً 30 ٹوکن لکھتا ہے (30 × 120 = 3,600 آؤٹ پٹ)۔ پرانا طریقہ: 60,000 × 120 = 7,200,000 ان پٹ ٹوکن، اوپر کے 50 قدموں کے کاموں میں سے سوا دو سے زیادہ، صرف اسٹیٹس متن پر خرچ۔ 500 ٹوکن کے نوٹ کے ساتھ یہ 500 × 120 = 60,000 ہے۔ GLM-5.3-Flash پر یہ $0.144 بمقابلہ $0.0013 ہے۔
اپنا ایجنٹ آزمائیں: فی قدم ٹوکن، قدم اور فی دن کام۔
لاگت کیلکولیٹر
ایسے دس کاموں کا ایک دن
فی درخواست ان پٹ ٹوکنز: 54,000 · فی درخواست آؤٹ پٹ ٹوکنز: 400 · فی دن درخواستیں: 500
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
Base URL، key اور پہلی درخواست CheapTokens docs میں ہے؛ ہر ماڈل کی موجودہ قیمتیں pricing page پر ہیں۔
اسے کم کرنے کے چار طریقے#
ان میں سے کسی کے لیے خاص ٹول درکار نہیں۔ یہ پوچھنے کی عادت ہے: کیا اس کال کو واقعی تاریخ درکار ہے؟
نوٹس کا نمونہ#
ایجنٹ کے کام کرتے وقت چند سطری نوٹس رکھیں، اور جب اسٹیٹس یا خلاصہ درکار ہو تو صرف وہی چھوٹے ماڈل کو دیں۔ یہ GLM-5.3-Flash پر ہے (zai-، 390K context، فی جواب زیادہ سے زیادہ 8,192 آؤٹ پٹ ٹوکن):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
آپ کو ایک مختصر سطر واپس ملتی ہے، اور usage جوڑا دکھاتا ہے کہ ان پٹ دسیوں ٹوکن میں ہے، دسیوں ہزار میں نہیں۔ یہ Claude Code کی تبدیلی والا ہی خیال ہے، ایک درجن سطروں میں۔
کون سی عادت آپ کے معاملے پر لاگو ہوتی ہے؟
اپنا کیس منتخب کریں
آپ کی صورتحال کیا ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
ایک سیشن، موضوع بدل گیا
نیا سیشن شروع کریں۔ پرانی نقل کی بجائے پانچ سطری نوٹس (مقصد، کیا ہو گیا، آگے کیا ہے) چسپاں کریں۔ تراشنے کے اختیارات trim chat history: sliding window or summary میں ہیں۔
ضمنی کام: اسٹیٹس، خلاصہ، عنوان
اسے تاریخ نہیں، نوٹس دیں، اور اسے چھوٹے ماڈل پر بھیجیں، جیسے اوپر کے کوڈ میں۔
بہت بڑا ٹول آؤٹ پٹ: لاگز، ٹیسٹ ڈمپس
اسے تاریخ سے باہر رکھیں۔ آخری 20 سطریں یا ایک ناکام ٹیسٹ دکھائیں، پورا ڈمپ نہیں: ہر سطر جو آپ رکھتے ہیں ہر بعد کے قدم پر دوبارہ بھیجی جاتی ہے۔ Claude Code token usage: keep tool output out of context دکھاتا ہے کیسے۔
ہر کال پر وہی لمبا پرامپٹ
اپنے فراہم کنندہ سے prompt caching کے بارے میں پوچھیں، جو پرامپٹ کے دہرائے گئے آغاز کو ہر بار نیا پڑھنے کی بجائے دوبارہ استعمال کر سکتا ہے۔
اگر آپ Claude Code استعمال کرتے ہیں، اسے اپ ڈیٹ کریں اور اسٹیٹس لائن نوٹ کے لیے changelog دیکھیں۔
خود لوپ کے لیے، DeepSeek-V4-Flash (deepseek-) آپ کو 380K context، فی جواب زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکن اور کسی بھی وقت ایک ہی قیمت دیتا ہے۔ ہماری مثال کا 103,000 ٹوکن والا سرا اس ونڈو میں تین گنا سے زیادہ سما جاتا ہے۔ نوٹس اور خلاصوں کے لیے، GLM-5.3-Flash۔ دیگر ماڈلز models page پر ہیں۔


