Por qué un agente de IA relee todo su historial en cada paso
Una corrección de la línea de estado de Claude Code muestra por qué las sesiones largas de agentes se vuelven caras: cada llamada reenvía la conversación. Calcula el coste y recórtalo.
En esta página
Tu agente estuvo ejecutándose diez minutos y la factura es mayor de lo que parece la tarea. Casi siempre la razón es la misma: el modelo no recuerda nada entre llamadas, así que cada paso vuelve a enviar toda la conversación hasta ese momento como entrada. Una sesión de 50 pasos paga sus primeros mensajes 50 veces, y por eso el coste crece más rápido que el trabajo realizado.
Una corrección que Anthropic anunció para Claude Code el 4–5 de noviembre de 2026 lo muestra en un punto pequeño. A continuación: qué cambió, la aritmética de un bucle de 50 pasos y qué puedes hacer al respecto.
Una línea de estado que releía todo#
Claude Code puede iniciar subagentes en segundo plano: agentes auxiliares que trabajan en una tarea secundaria mientras tú continúas. Cada uno muestra una línea de estado, algo como 'ejecutando pruebas, 3 de 8 hechas'.
La cuenta ClaudeDevs en X anunció el cambio (la publicación está fechada el 5 de noviembre de 2026; informes secundarios dicen 4 o 5 de noviembre). El estado se actualizaba cada 30 segundos, y cada actualización releía toda la conversación del subagente. Ahora Haiku 5.5 escribe el estado a partir de notas breves, y Anthropic lo estima en torno a un 99% más barato por actualización. Es una cifra por actualización, no por sesión: el trabajo real del subagente sigue leyendo su historial.
Imagina lo que significaba el método antiguo. Supón que un subagente tiene 60.000 tokens de conversación en el minuto veinte. El estado en sí son quizá 30 tokens. Pero para escribir esos 30 tokens el modelo tenía que releer los 60.000 completos, dos veces por minuto, durante todo el tiempo que el subagente estuviera ejecutándose.
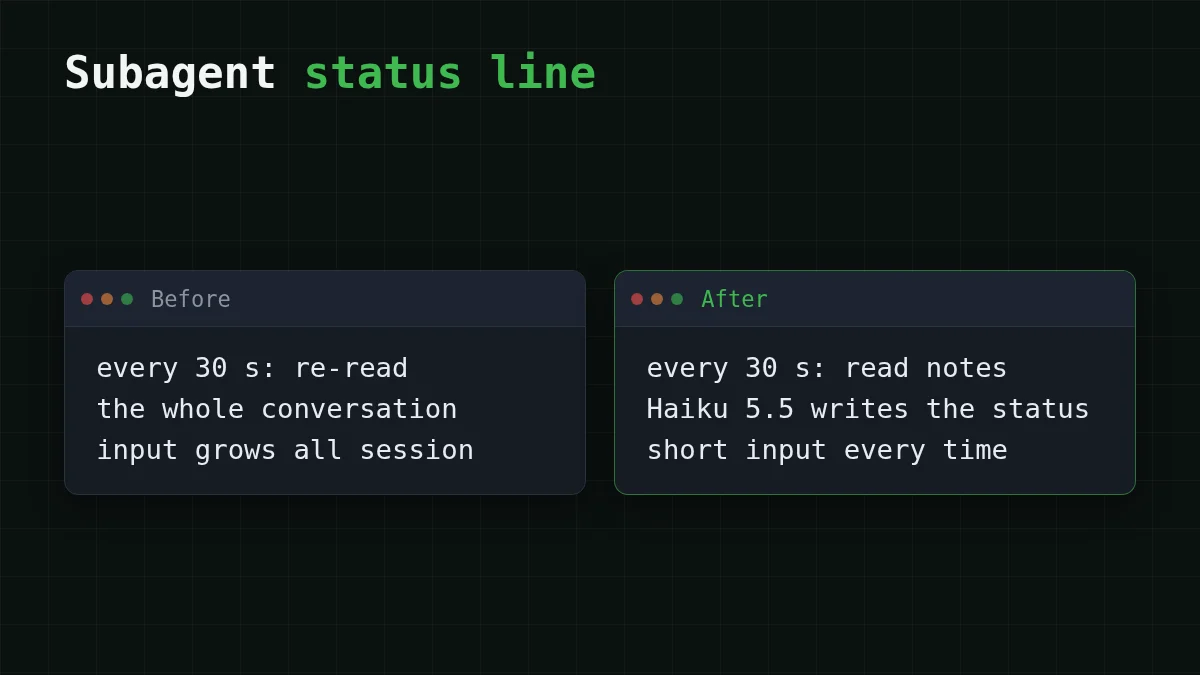
Nadie necesita la transcripción completa para decir 'ejecutando pruebas'. Unas pocas líneas de notas (qué estoy haciendo, qué está terminado) bastan. Esa es toda la corrección: dar a una tarea secundaria las notas, no la transcripción.
Por qué cada paso reenvía el historial#
Piensa en una carta a alguien que te olvida en el momento en que responde. Para continuar, envías toda la correspondencia de nuevo más la nueva línea. Un paso de agente es exactamente esa llamada: el prompt del sistema, tu tarea, cada respuesta anterior y cada resultado de herramienta vuelven a entrar. (La versión de chat de esta historia está en por qué un chat largo de IA cuesta más.)
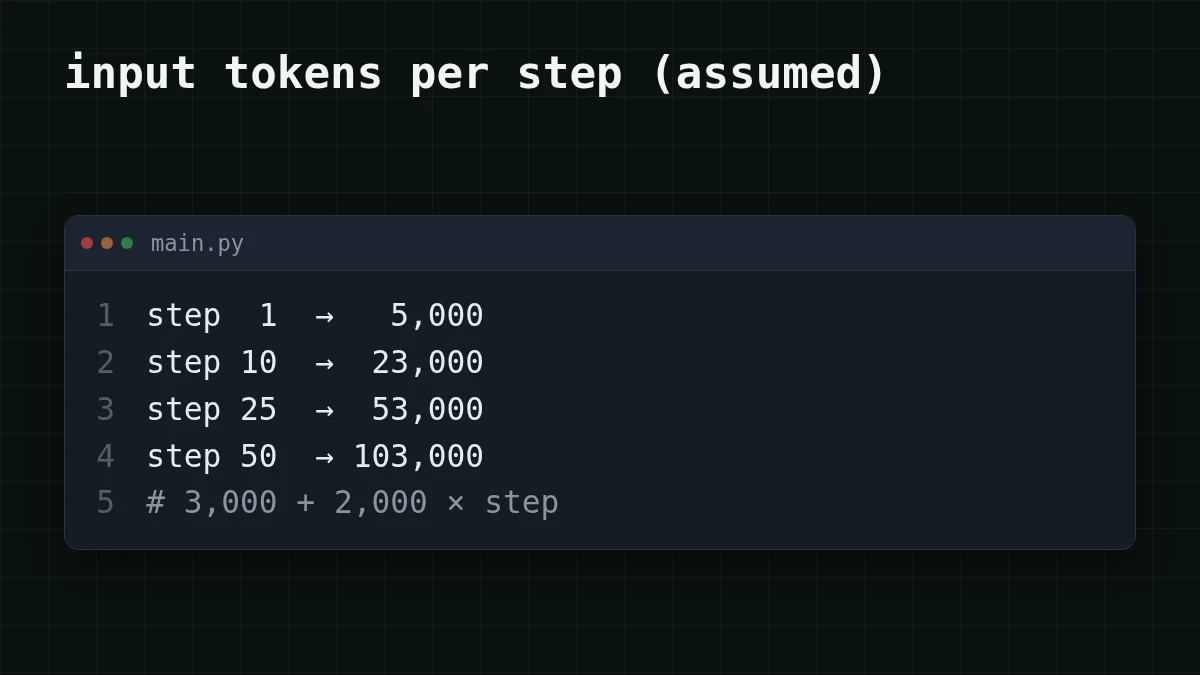
Pongámosle números. Supón que el prompt del sistema y la tarea ocupan 3.000 tokens, y cada paso añade unos 2.000 (la respuesta del modelo más la salida de herramienta que lee). El paso n envía entonces 3.000 + 2.000 × n tokens: 5.000 en el paso 1, 23.000 en el paso 10, 103.000 en el paso 50.
Adivina el número
¿Cuántos tokens de entrada envía el paso 50 de este agente?
Tu respuesta
0200.000
Mostrar respuesta
Respuesta: 103.000
3.000 + 2.000 × 50 = 103.000. El modelo relee el prompt inicial y los 49 pasos anteriores, y luego tu nuevo paso encima.
Ahora suma los 50 pasos. La parte creciente es 2,000 × 1,275 = 2,550,000, donde 1.275 es 1 + 2 + … + 50. El prompt inicial, enviado cada vez, es 50 × 3,000 = 150,000. En conjunto: 150,000 + 2,550,000 = 2,700,000 tokens de entrada. La conversación terminada contiene solo 103.000. Empujaste 2,7 millones de tokens por el modelo para obtener una transcripción de 103.000 tokens, y la factura sigue al primer número.
Cuánto cuesta: una tarea, un día#
Ponle precio al mismo agente de 50 pasos en DeepSeek-V4-Flash. El paso medio envía 54.000 tokens, así que 54,000 × 50 = 2,700,000 tokens de entrada en total, y escribe unos 400 por paso (400 × 50 = 20,000). La tarea completa cuesta $0.0425. Aquí está la misma carga de trabajo en cada modelo que tenemos, junto a OpenRouter:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 50 solicitudes | OpenRouter, 50 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0011 | $0.0548 | $0.0921 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00085 | $0.0425 | $0.192 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0028 | $0.138 | $1.66 |
54.000 tokens de entrada y 400 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En la tabla, todos los modelos son más baratos que OpenRouter en total, contando entrada y salida juntas.
Ahora la línea de estado. 120 actualizaciones es una hora de un subagente, y cada una escribe unos 30 tokens (30 × 120 = 3,600 de salida). El método antiguo: 60,000 × 120 = 7,200,000 tokens de entrada, más de dos y medio de las tareas de 50 pasos anteriores, gastados en nada más que un texto de estado. Con una nota de 500 tokens son 500 × 120 = 60,000. En GLM-5.3-Flash eso es $0.144 frente a $0.0013.
Prueba tu propio agente: tokens por paso, pasos y tareas por día.
Calculadora de costos
Un día de diez tareas así
Tokens de entrada por solicitud: 54.000 · Tokens de salida por solicitud: 400 · Solicitudes por día: 500
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.548 | $16.44 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.425 | $12.75 |
| MiniMax-M2.7$0.05$0.15 | $1.38 | $41.40 |
La URL base, la clave y una primera petición están en la documentación de CheapTokens; los precios actuales de cada modelo están en la página de precios.
Cuatro formas de recortarlo#
Ninguna de estas necesita una herramienta especial. Es un hábito de preguntar: ¿esta llamada realmente necesita el historial?
El patrón de notas#
Mantén unas pocas líneas de notas mientras el agente trabaja, y entrega solo esas a un modelo pequeño cuando necesites un estado o un resumen. Aquí está en GLM-5.3-Flash (zai-, contexto de 390K, hasta 8.192 tokens de salida por respuesta):
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

notes = [
    'Task: fix failing tests in billing/',
    'Done: found 3 failing tests, fixed 2',
    'Now: running the third test',
]

reply = client.chat.completions.create(
    model='zai-org/GLM-5.3-Flash',
    max_tokens=100,
    messages=[
        {'role': 'system', 'content': 'Write a one-line status from the notes.'},
        {'role': 'user', 'content': '; '.join(notes)},
    ],
)
print(reply.choices[0].message.content)
print(reply.usage.prompt_tokens, reply.usage.completion_tokens)
Recibes una línea corta, y el par de uso muestra entrada en decenas de tokens, no en decenas de miles. Es la misma idea que el cambio de Claude Code, en una docena de líneas.
¿Qué hábito encaja en tu caso?
Elige tu caso
¿Cuál es tu situación?
Elige una opción para ver la respuesta
Una sesión, el tema cambió
Empieza una sesión nueva. Pega cinco líneas de notas (objetivo, qué está hecho, qué viene después) en lugar de la transcripción antigua. Las opciones de recorte están en recortar el historial de chat: ventana deslizante o resumen.
Una tarea secundaria: estado, resumen, título
Dale las notas, no el historial, y envíalo a un modelo pequeño, como en el código anterior.
Salida de herramienta enorme: logs, volcados de pruebas
Mantenla fuera del historial. Muestra las últimas 20 líneas o la única prueba que falla, no el volcado completo: cada línea que conservas se reenvía en cada paso posterior. Uso de tokens en Claude Code: mantén la salida de herramienta fuera del contexto muestra cómo.
El mismo prompt largo en cada llamada
Pregunta a tu proveedor por el almacenamiento en caché de prompts, que puede reutilizar un inicio repetido del prompt en lugar de leerlo de nuevo cada vez.
Si usas Claude Code, actualízalo y revisa el changelog para la nota de la línea de estado.
Para el bucle en sí, DeepSeek-V4-Flash (deepseek-) te da un contexto de 380K, hasta 32.768 tokens de salida por respuesta y un precio a cualquier hora. El extremo de 103.000 tokens de nuestro ejemplo cabe en esa ventana más de tres veces. Para notas y resúmenes, GLM-5.3-Flash. Otros modelos están en la página de modelos.


