Noticias de IAActualización
Precio de la API de Claude Fable 5.2: $8 / $40, modo rápido al doble
Claude Fable 5.2 cuesta $8 de entrada y $40 de salida por 1M de tokens; el modo rápido lo duplica. Consulta el id de la API y lo que cuesta un día de agente.
En esta página
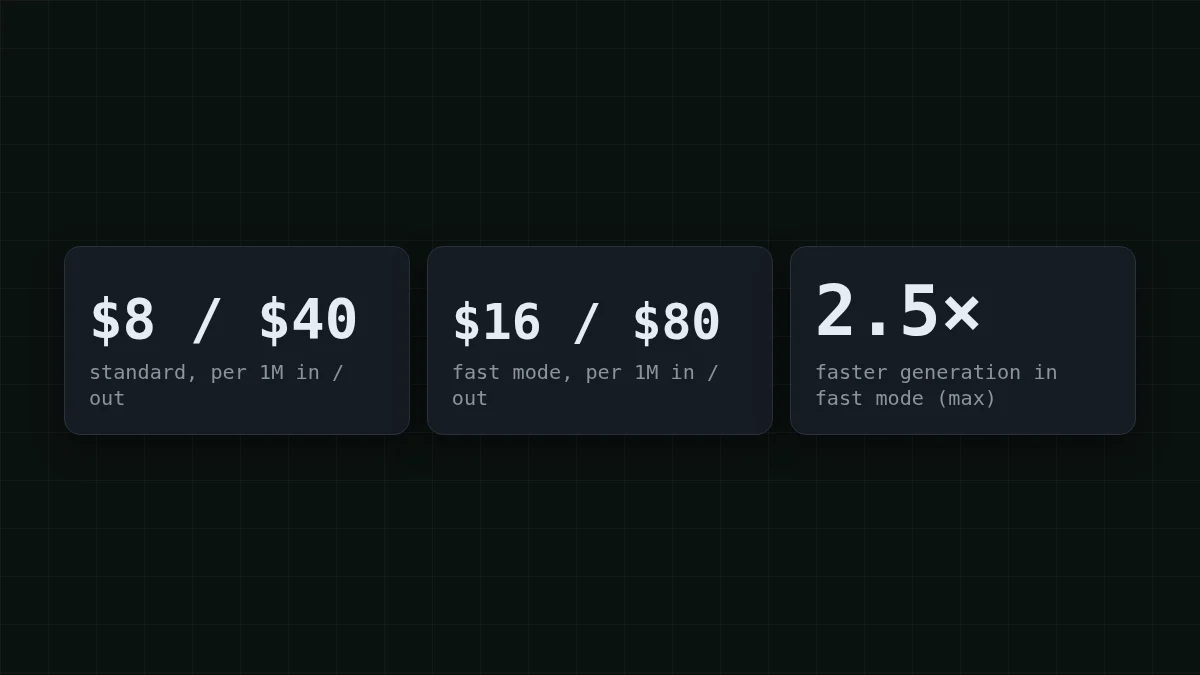
Claude Fable 5.2 está en la API como claude-fable-5-2. El precio estándar es de $8 por 1M de tokens de entrada y $40 por 1M de tokens de salida. El modo rápido genera hasta 2,5 veces más rápido y cuesta exactamente el doble: $16 / $80. Eso viene de la página de lanzamiento de Anthropic del 9 de noviembre de 2026 (consultada el 10 de noviembre), y el resto de esta entrada trata sobre lo que esos números hacen a una factura.
Tu agente estuvo funcionando diez minutos y la factura es mayor que la tarea. Esa es la historia habitual con un modelo de primer nivel en un bucle, así que pongamos números reales.
Qué anunció Anthropic#
La página de lanzamiento, Claude Fable and Mythos 5.2, dice:
- Fable 5.2 ya está disponible en Claude Platform y en AWS, Google Cloud y Microsoft Azure.
- La salida es hasta un 30% más rápida que Claude Fable 5.1 (afirmación de la propia Anthropic).
- El modo rápido está disponible en Claude Code, Claude Platform, Claude Models en Google Cloud y Microsoft Foundry.
- Mythos 5.2 es el mismo modelo subyacente con restricciones más débiles, limitado a organizaciones aprobadas a través de los programas de verificación Cyber o Life Sciences. Fable tiene salvaguardas más estrictas de ciberseguridad y biología y está abierto a todos los usuarios.
La página no indica la ventana de contexto ni la longitud máxima de salida, y aquí no las voy a adivinar. Consúltalas en la documentación de Anthropic antes de dimensionar un prompt.
Cuánto cuesta un paso de agente en Fable 5.2#
Supongamos que tu agente de programación hace una llamada típica en mitad de la tarea: 30.000 tokens de entrada (el historial que relee en cada paso, más la salida de herramientas) y 2.000 tokens de salida.
- Entrada: 30.000 / 1.000.000 × $8 = $0,24
- Salida: 2.000 / 1.000.000 × $40 = $0,08
- Un paso: $0,24 + $0,08 = $0,32
Eso parece poco. Ahora el bucle: un agente que da 200 pasos en un día cuesta $0,32 × 200 = $64 al precio estándar. En modo rápido son $0,64 × 200 = $128 por el mismo trabajo.
Fíjate adónde va el dinero: tres cuartas partes de cada paso son el lado de la entrada, el historial que se relee. Si nunca has visto por qué ocurre eso, why AI agents use so many tokens recorre un ejemplo de 20 pasos.
Adivina el número
Un paso de agente con 30.000 tokens de entrada y 2.000 de salida en Fable 5.2 al precio estándar: ¿cuántos céntimos?
Tu respuesta
0100
Mostrar respuesta
Respuesta: 32
32 céntimos: $0,24 por la entrada más $0,08 por la salida. El modo rápido lo duplicaría a 64.
¿Vale el doble el modo rápido?#
El modo rápido cambia la velocidad, no la respuesta: mismo modelo, generación hasta 2,5 veces más rápida, el doble de precio por token. Si vale la pena depende de quién esté esperando.
Elige tu caso
¿Dónde ejecutas Fable 5.2?
Elige una opción para ver la respuesta
Estoy delante de Claude Code
Lees cada respuesta y decides el siguiente movimiento, así que esperar es la parte cara. El modo rápido está pensado exactamente para esto. Actívalo en las tandas en las que estás dirigiendo activamente y desactívalo cuando te alejes.
El agente se ejecuta sin supervisión
Nadie está mirando el reloj, así que pagarías el doble por una velocidad que nadie usa. Quédate con el precio estándar y plantéate qué pasos necesitan realmente un modelo de primer nivel.
Una advertencia sobre la aritmética: "hasta 2,5 veces más rápido" es el techo de Anthropic, no una promesa para cada solicitud. Cronometra una de tus propias tareas en ambos modos antes de decidir.
Dónde encaja un modelo más barato#
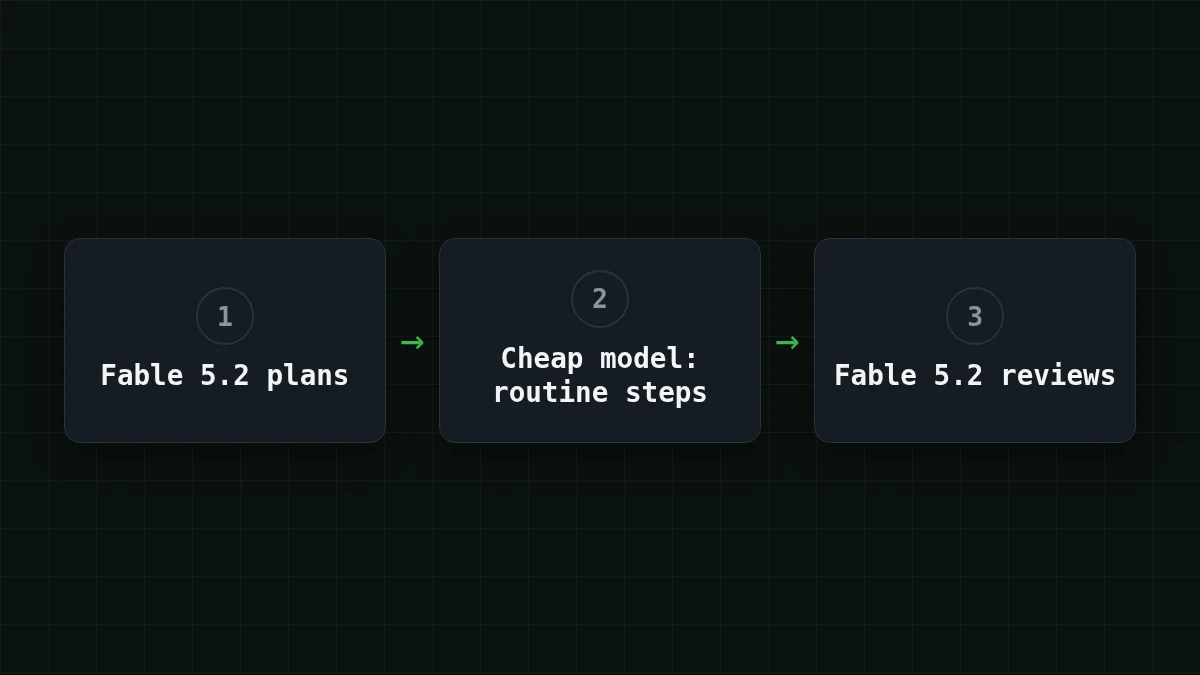
La mayoría de los bucles no son un único problema difícil. Son unas pocas decisiones difíciles envueltas en muchos pasos rutinarios: leer un archivo, ejecutar un comando, resumir la salida. Esos pasos rutinarios no necesitan el modelo más caro, y ahí es donde se acumula el coste de un día.
Una división habitual es dejar que Fable 5.2 planifique y revise, y enviar las llamadas rutinarias a un modelo barato. Para ese papel, CheapTokens tiene DeepSeek-V4-Flash: hasta 32.768 tokens por respuesta, 380K de contexto, un único precio a cualquier hora y una API compatible con OpenAI y Anthropic. Ejecuta algunos de tus propios pasos rutinarios en él y lee usage en la respuesta: eso muestra lo que te cuesta realmente un paso.
Aquí está el mismo paso de 30.000 de entrada y 2.000 de salida en él: $0.00065. Y el día de 200 pasos, en vivo desde los precios actuales:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 200 solicitudes | OpenRouter, 200 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30.000 tokens de entrada y 2000 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La solicitud es una llamada de chat normal. Usa el id completo del modelo de la documentación de CheapTokens (deepseek-); la API no acepta el id corto de las etiquetas de precio.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
La respuesta tiene un bloque usage con prompt_tokens y completion_, así que puedes poner precio a tus propios pasos en lugar de fiarte de mis 30.000 / 2.000. La configuración está en la documentación, los modelos están en la página de DeepSeek, y model routing: cheap first, escalate explica cómo decidir qué paso va dónde. Para Claude Code en concreto, consulta how to make Claude Code cheaper.
Comprueba lo que has entendido#
Verificación rápida
¿Qué es el modo rápido en Fable 5.2?
Mostrar respuesta
Respuesta: El mismo modelo generando hasta 2,5 veces más rápido al doble de precio por token
Anthropic lista el modo rápido a $16 / $80 por 1M de tokens frente a $8 / $40 del estándar.
Respuestas breves#
¿Cuál es el id de la API? claude-fable-5-2.
¿Cuánto cuesta? $8 por 1M de tokens de entrada y $40 por 1M de salida; modo rápido $16 / $80 (Anthropic, 9 de noviembre de 2026).
¿Dónde puedo usarlo? En Claude Platform, AWS, Google Cloud y Microsoft Azure; el modo rápido en Claude Code, Claude Platform, Google Cloud y Microsoft Foundry.
¿Qué es Mythos 5.2? El mismo modelo subyacente con restricciones más débiles, para organizaciones aprobadas a través de los programas de verificación de Anthropic.


