Actus IAMise à jour
Prix de l'API Claude Fable 5.2 : 8 $ / 40 $, mode rapide à 2x
Claude Fable 5.2 coûte 8 $ en entrée et 40 $ en sortie par million de tokens ; le mode rapide double cela. Voir l'identifiant API et ce que coûte une journée d'agent.
Sur cette page
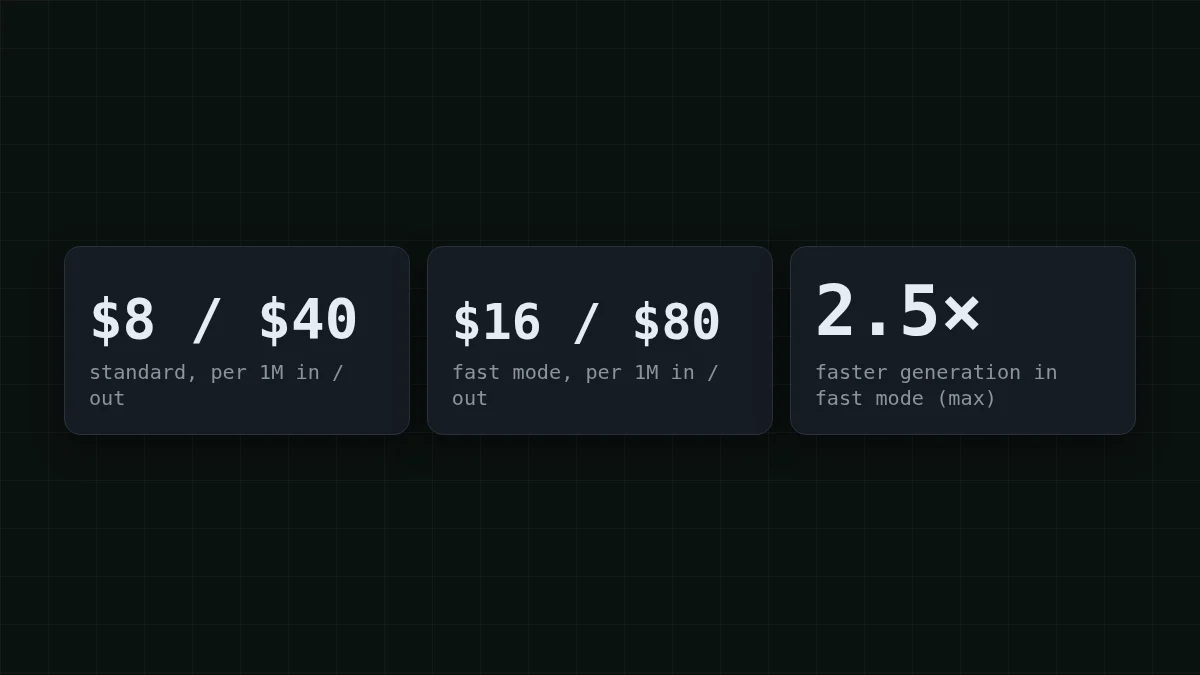
Claude Fable 5.2 est disponible sur l'API sous l'identifiant claude-fable-5-2. Le prix standard est de 8 $ par million de tokens d'entrée et de 40 $ par million de tokens de sortie. Le mode rapide génère jusqu'à 2,5 fois plus vite et coûte exactement le double : 16 $ / 80 $. Ces chiffres proviennent de la page de publication d'Anthropic du 9 novembre 2026 (vérifiée le 10 novembre), et le reste de cet article porte sur l'effet de ces chiffres sur une facture.
Votre agent a tourné pendant dix minutes, et la facture dépasse la tâche. C'est l'histoire habituelle avec un modèle haut de gamme dans une boucle, alors mettons de vrais chiffres dessus.
Ce qu'Anthropic a annoncé#
La page de publication, Claude Fable and Mythos 5.2, indique :
- Fable 5.2 est disponible dès maintenant sur la Claude Platform et sur AWS, Google Cloud et Microsoft Azure.
- La sortie est jusqu'à 30 % plus rapide que Claude Fable 5.1 (affirmation d'Anthropic).
- Le mode rapide est disponible dans Claude Code, la Claude Platform, Claude Models sur Google Cloud et Microsoft Foundry.
- Mythos 5.2 est le même modèle sous-jacent avec des restrictions plus faibles, réservé aux organisations approuvées via les programmes de vérification Cyber ou Life Sciences. Fable dispose de garde-fous renforcés en cybersécurité et en biologie et est ouvert à tous les utilisateurs.
La page ne donne ni la fenêtre de contexte ni la longueur maximale de sortie, et je ne les devine pas ici. Vérifiez-les dans la documentation Anthropic avant de dimensionner un prompt.
Ce que coûte une étape d'agent sur Fable 5.2#
Supposons que votre agent de codage effectue un appel typique en milieu de tâche : 30 000 tokens en entrée (l'historique qu'il relit à chaque étape, plus la sortie des outils) et 2 000 tokens en sortie.
- Entrée : 30 000 / 1 000 000 × 8 $ = 0,24 $
- Sortie : 2 000 / 1 000 000 × 40 $ = 0,08 $
- Une étape : 0,24 $ + 0,08 $ = 0,32 $
Cela semble peu. Maintenant la boucle : un agent qui effectue 200 étapes par jour coûte 0,32 $ × 200 = 64 $ au prix standard. En mode rapide, c'est 0,64 $ × 200 = 128 $ pour le même travail.
Remarquez où va l'argent : les trois quarts de chaque étape correspondent au côté entrée, l'historique relu. Si vous n'avez jamais vu pourquoi cela se produit, why AI agents use so many tokens détaille un exemple en 20 étapes.
Devinez le nombre
Une étape d'agent avec 30 000 tokens en entrée et 2 000 en sortie sur Fable 5.2 au prix standard : combien de centimes ?
Votre estimation
0100
Afficher la réponse
Réponse: 32
32 centimes : 0,24 $ pour l'entrée plus 0,08 $ pour la sortie. Le mode rapide doublerait cela à 64.
Le mode rapide vaut-il le double ?#
Le mode rapide change la vitesse, pas la réponse : même modèle, génération jusqu'à 2,5 fois plus rapide, prix par token doublé. Savoir si cela en vaut la peine dépend de qui attend.
Choisissez votre cas
Où exécutez-vous Fable 5.2 ?
Choisissez une option pour voir la réponse
Je suis assis devant Claude Code
Vous lisez chaque réponse et décidez du prochain mouvement, donc l'attente est la partie coûteuse. Le mode rapide vise exactement ce cas. Activez-le pendant les périodes où vous pilotez activement et désactivez-le quand vous vous éloignez.
L'agent tourne sans surveillance
Personne ne regarde l'horloge, donc vous paieriez le double pour une vitesse que personne n'utilise. Restez au prix standard et examinez quelles étapes ont réellement besoin d'un modèle haut de gamme.
Une mise en garde sur l'arithmétique : « jusqu'à 2,5 fois plus rapide » est le plafond d'Anthropic, pas une promesse pour chaque requête. Chronométrez l'une de vos propres tâches dans les deux modes avant de décider.
Où un modèle moins cher trouve sa place#
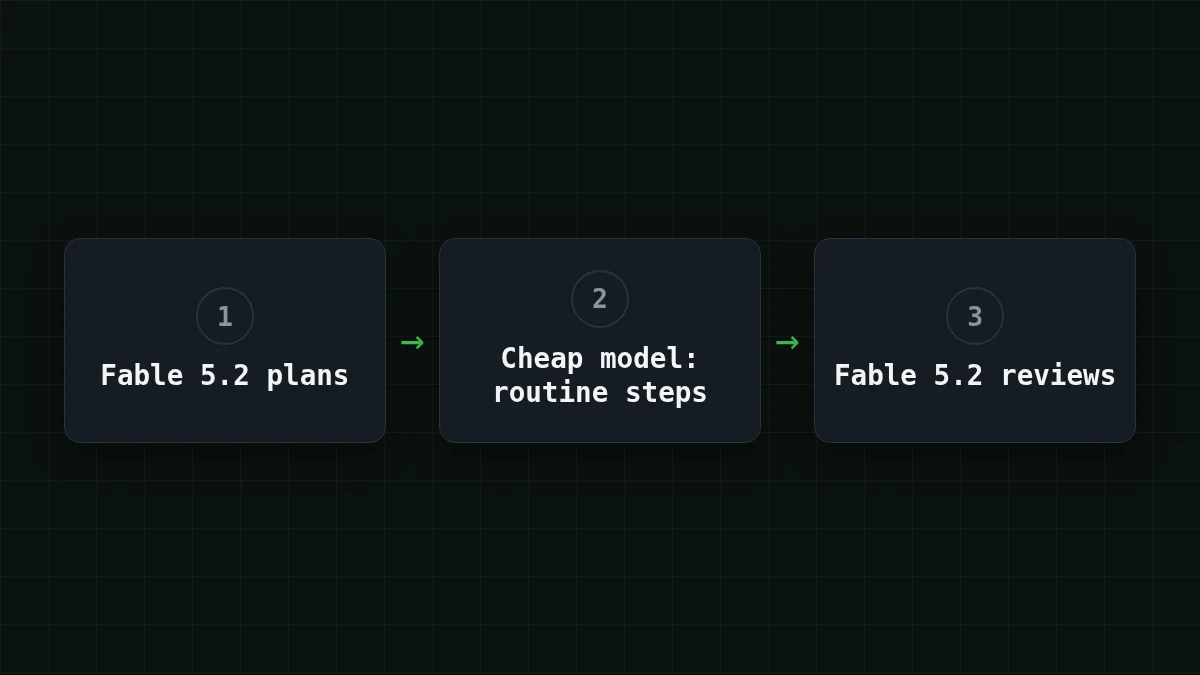
La plupart des boucles ne sont pas un seul problème difficile. Ce sont quelques décisions difficiles entourées de nombreuses étapes routinières : lire un fichier, exécuter une commande, résumer la sortie. Ces étapes routinières n'ont pas besoin du modèle le plus cher, et c'est là que le coût d'une journée s'accumule.
Une répartition courante consiste à laisser Fable 5.2 planifier et réviser, et à envoyer les appels routiniers à un modèle bon marché. Pour ce rôle, CheapTokens propose DeepSeek-V4-Flash : jusqu'à 32 768 tokens par réponse, 380K de contexte, un prix unique à toute heure, et une API compatible OpenAI et Anthropic. Exécutez quelques-unes de vos propres étapes routinières dessus et lisez usage dans la réponse : cela montre ce que vous coûte réellement une étape.
Voici la même étape de 30 000 en entrée et 2 000 en sortie sur ce modèle : $0.00065. Et la journée de 200 étapes, en direct à partir des prix actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 200 requêtes | OpenRouter, 200 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30 000 tokens d'entrée et 2 000 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
La requête est un appel de chat normal. Utilisez l'identifiant complet du modèle depuis la documentation CheapTokens (deepseek-) ; l'identifiant court des étiquettes de prix n'est pas accepté par l'API.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
La réponse contient un bloc usage avec prompt_tokens et completion_, vous pouvez donc chiffrer vos propres étapes au lieu de faire confiance à mes 30 000 / 2 000. La configuration est dans la documentation, les modèles sont sur la page DeepSeek, et model routing: cheap first, escalate explique comment décider quelle étape va où. Pour Claude Code en particulier, voir how to make Claude Code cheaper.
Vérifiez votre compréhension#
Vérification rapide
Qu'est-ce que le mode rapide sur Fable 5.2 ?
Afficher la réponse
Réponse: Le même modèle générant jusqu'à 2,5 fois plus vite au double du prix par token
Anthropic indique le mode rapide à 16 $ / 80 $ par million de tokens contre 8 $ / 40 $ en standard.
Réponses courtes#
Quel est l'identifiant API ? claude-fable-5-2.
Combien cela coûte-t-il ? 8 $ par million de tokens d'entrée et 40 $ par million de tokens de sortie ; mode rapide 16 $ / 80 $ (Anthropic, 9 novembre 2026).
Où puis-je l'utiliser ? La Claude Platform, AWS, Google Cloud et Microsoft Azure ; le mode rapide dans Claude Code, la Claude Platform, Google Cloud et Microsoft Foundry.
Qu'est-ce que Mythos 5.2 ? Le même modèle sous-jacent avec des restrictions plus faibles, pour les organisations approuvées via les programmes de vérification d'Anthropic.


