Berita AIPembaruan
Harga API Claude Fable 5.2: $8 / $40, mode cepat 2x
Claude Fable 5.2 berbiaya $8 masuk dan $40 keluar per 1 juta token; mode cepat menggandakannya. Lihat id API dan biaya sehari agen.
Di halaman ini
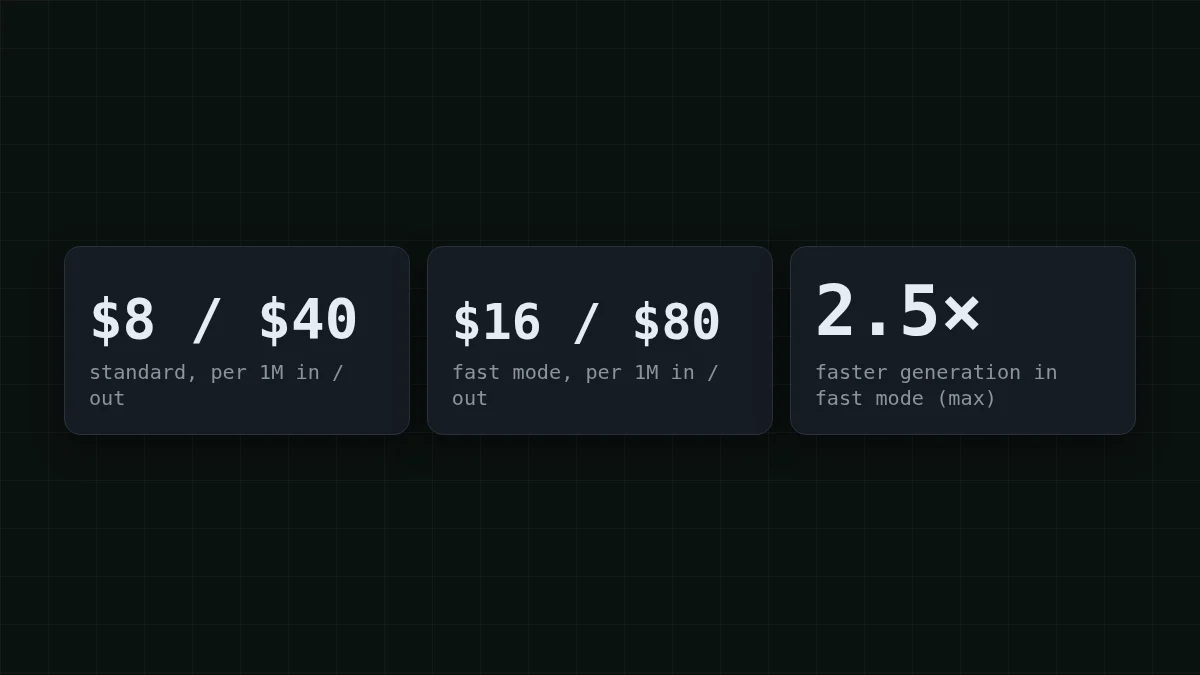
Claude Fable 5.2 tersedia di API sebagai claude-fable-5-2. Harga standar adalah $8 per 1 juta token input dan $40 per 1 juta token output. Mode cepat menghasilkan hingga 2,5x lebih cepat dan biayanya tepat dua kali lipat: $16 / $80. Itu dari halaman rilis Anthropic tanggal 9 November 2026 (dicek 10 November), dan sisa postingan ini membahas dampak angka-angka tersebut terhadap tagihan.
Agen Anda berjalan selama sepuluh menit, dan tagihannya lebih besar daripada tugasnya. Itu cerita biasa dengan model kelas atas dalam sebuah loop, jadi mari kita pasang angka nyata untuk itu.
Apa yang diumumkan Anthropic#
Halaman rilis, Claude Fable and Mythos 5.2, menyebutkan:
- Fable 5.2 tersedia sekarang di Claude Platform dan di AWS, Google Cloud, serta Microsoft Azure.
- Output hingga 30% lebih cepat daripada Claude Fable 5.1 (klaim Anthropic sendiri).
- Mode cepat tersedia di Claude Code, Claude Platform, Claude Models di Google Cloud, dan Microsoft Foundry.
- Mythos 5.2 adalah model dasar yang sama dengan pembatasan lebih longgar, terbatas untuk organisasi yang disetujui melalui Cyber atau Life Sciences Verification Programs. Fable memiliki pengaman siber dan biologi yang lebih kuat dan terbuka untuk semua pengguna.
Halaman tersebut tidak mencantumkan jendela konteks atau panjang output maksimum, dan saya tidak menebaknya di sini. Periksa di dokumentasi Anthropic sebelum Anda menentukan ukuran prompt.
Berapa biaya satu langkah agen pada Fable 5.2#
Katakanlah agen coding Anda melakukan panggilan khas di tengah tugas: 30.000 token masuk (riwayat yang dibaca ulang setiap langkah, ditambah output tool) dan 2.000 token keluar.
- Input: 30.000 / 1.000.000 × $8 = $0,24
- Output: 2.000 / 1.000.000 × $40 = $0,08
- Satu langkah: $0,24 + $0,08 = $0,32
Itu terlihat kecil. Sekarang loop-nya: agen yang mengambil 200 langkah dalam sehari membutuhkan biaya $0,32 × 200 = $64 dengan harga standar. Dalam mode cepat menjadi $0,64 × 200 = $128 untuk pekerjaan yang sama.
Perhatikan ke mana uangnya pergi: tiga perempat dari setiap langkah adalah sisi input, riwayat yang dibaca ulang. Jika Anda belum pernah melihat mengapa itu terjadi, mengapa agen AI menggunakan begitu banyak token membahas contoh 20 langkah.
Tebak angkanya
Satu langkah agen dengan 30.000 token masuk dan 2.000 keluar pada Fable 5.2 dengan harga standar: berapa sen?
Tebakan Anda
0100
Tampilkan jawaban
Jawaban: 32
32 sen: $0,24 untuk input ditambah $0,08 untuk output. Mode cepat akan menggandakannya menjadi 64.
Apakah mode cepat sepadan dengan dua kali lipat?#
Mode cepat mengubah kecepatan, bukan jawaban: model yang sama, generasi hingga 2,5x lebih cepat, dua kali harga per token. Apakah itu sepadan tergantung siapa yang menunggu.
Pilih kasus Anda
Di mana Anda menjalankan Fable 5.2?
Pilih opsi untuk melihat jawabannya
Saya duduk di depan Claude Code
Anda membaca setiap balasan dan memutuskan langkah berikutnya, jadi menunggu adalah bagian yang mahal. Mode cepat ditujukan tepat untuk ini. Aktifkan untuk rentang waktu ketika Anda aktif mengarahkan dan matikan saat Anda pergi.
Agen berjalan tanpa pengawasan
Tidak ada yang memantau jam, jadi Anda akan membayar dua kali lipat untuk kecepatan yang tidak digunakan siapa pun. Tetap pada harga standar, dan pertimbangkan langkah mana yang benar-benar membutuhkan model kelas atas.
Satu peringatan tentang aritmetika: "hingga 2,5x lebih cepat" adalah batas atas Anthropic, bukan janji untuk setiap permintaan. Ukur waktu salah satu tugas Anda sendiri di kedua mode sebelum memutuskan.
Di mana model yang lebih murah cocok#
Sebagian besar loop bukanlah satu masalah sulit. Itu adalah beberapa keputusan sulit yang dibungkus banyak langkah rutin: baca file, jalankan perintah, ringkas output. Langkah-langkah rutin itu tidak membutuhkan model termahal, dan di situlah biaya sehari menumpuk.
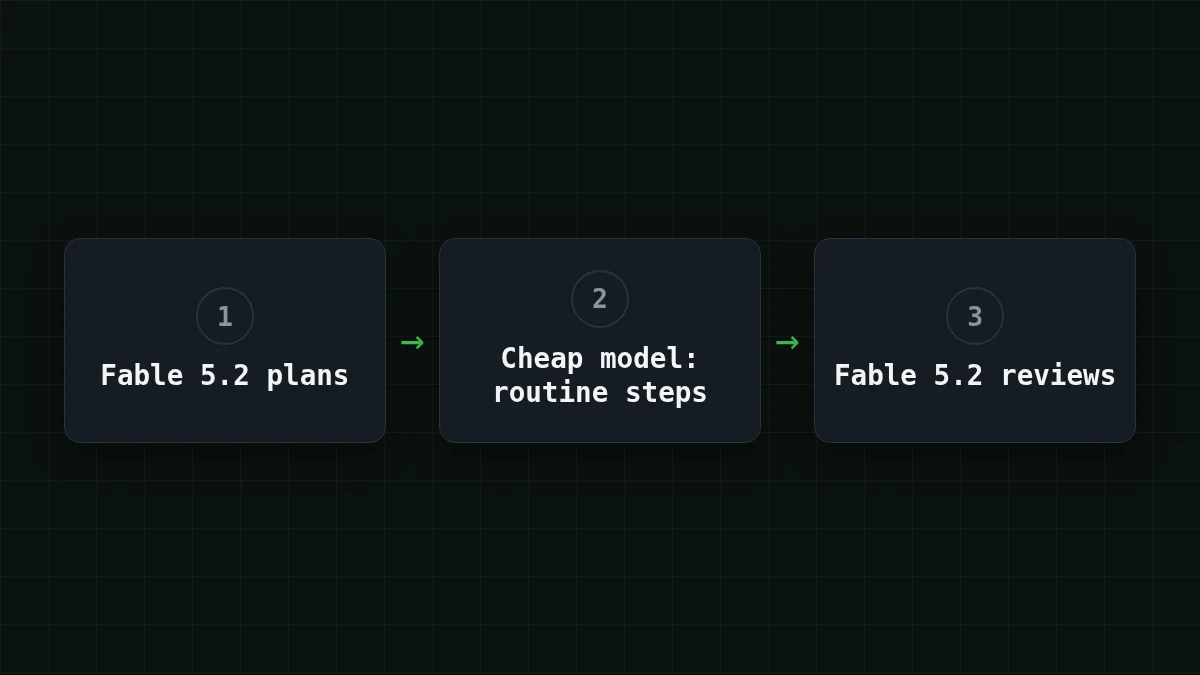
Pembagian yang umum adalah membiarkan Fable 5.2 merencanakan dan meninjau, lalu mengirim panggilan rutin ke model murah. Untuk peran itu, CheapTokens memiliki DeepSeek-V4-Flash: hingga 32.768 token per jawaban, konteks 380K, satu harga di jam berapa pun, dan API yang kompatibel dengan OpenAI dan Anthropic. Jalankan beberapa langkah rutin Anda sendiri di atasnya dan baca usage di balasan: itu menunjukkan berapa biaya satu langkah Anda sebenarnya.
Berikut langkah yang sama 30.000 masuk, 2.000 keluar di atasnya: $0.00065. Dan hari 200 langkah, langsung dari harga saat ini:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 200 permintaan | OpenRouter, 200 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00068 | $0.136 | $0.234 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00065 | $0.13 | $0.476 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0018 | $0.36 | $4.32 |
30.000 token input dan 2.000 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Permintaannya adalah panggilan chat biasa. Gunakan id model lengkap dari dokumentasi CheapTokens (deepseek-); id pendek dari label harga tidak diterima oleh API.
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this test output in 3 lines: ..."}],
    "max_tokens": 300
  }'
Balasan memiliki blok usage dengan prompt_tokens dan completion_, sehingga Anda dapat menghitung harga langkah Anda sendiri alih-alih mempercayai 30.000 / 2.000 saya. Setup ada di dokumentasi, modelnya ada di halaman DeepSeek, dan routing model: murah dulu, eskalasi membahas cara memutuskan langkah mana ke mana. Khusus untuk Claude Code, lihat cara membuat Claude Code lebih murah.
Periksa pemahaman Anda#
Cek cepat
Apa itu mode cepat pada Fable 5.2?
Tampilkan jawaban
Jawaban: Model yang sama menghasilkan hingga 2,5x lebih cepat dengan harga per token dua kali lipat
Anthropic mencantumkan mode cepat seharga $16 / $80 per 1 juta token dibandingkan $8 / $40 standar.
Jawaban singkat#
Apa id API-nya? claude-fable-5-2.
Berapa biayanya? $8 per 1 juta input dan $40 per 1 juta token output; mode cepat $16 / $80 (Anthropic, 9 November 2026).
Di mana saya bisa menggunakannya? Claude Platform, AWS, Google Cloud, dan Microsoft Azure; mode cepat di Claude Code, Claude Platform, Google Cloud, dan Microsoft Foundry.
Apa itu Mythos 5.2? Model dasar yang sama dengan pembatasan lebih longgar, untuk organisasi yang disetujui melalui program verifikasi Anthropic.


