Optimasi biayaPanduan
Routing model untuk memangkas biaya API: model murah dulu, eskalasi
Kirim permintaan mudah ke model murah dan eskalasi hanya yang sulit. Lihat biaya campuran 10.000 permintaan pada eskalasi 10%, 30%, dan 50%, plus router Python singkat.
Di halaman ini
Routing dapat memangkas tagihan ketika hasil pertama dari model murah jauh lebih murah daripada model kedua dan hanya sedikit permintaan yang dieskalasi: kirim setiap permintaan ke model murah terlebih dahulu dan kirim ulang hanya yang sulit ke model kedua. Apakah Anda benar-benar menghemat bergantung pada proporsi permintaan yang Anda eskalasi. Di bawah ini adalah perhitungan untuk 10.000 permintaan pada 10%, 30%, dan 50%, serta fungsi Python yang dapat Anda tempel ke proyek Anda.
Pola ini bukan hal baru. Postingan engineering Anthropic "Building effective agents" (19 Desember 2024) menyebutnya sebagai alur kerja routing: pertanyaan umum dan mudah dikirim ke model yang lebih kecil dan hemat biaya, sedangkan pertanyaan tidak biasa dan sulit dikirim ke model yang lebih mumpuni. Postingan tersebut tidak memberikan harga, jadi angka di sini adalah milik kami sendiri, berdasarkan harga CheapTokens langsung.
Permintaan mana yang mudah?#
Routing hanya berfungsi jika Anda dapat menyatakan, dalam sebuah aturan, apa arti "sulit". Bukan dalam perasaan, melainkan dalam aturan yang dapat diperiksa kode. Pilih kasus yang paling dekat dengan Anda:
Pilih kasus Anda
Pilih kasus Anda
Pilih opsi untuk melihat jawabannya
Chatbot dukungan
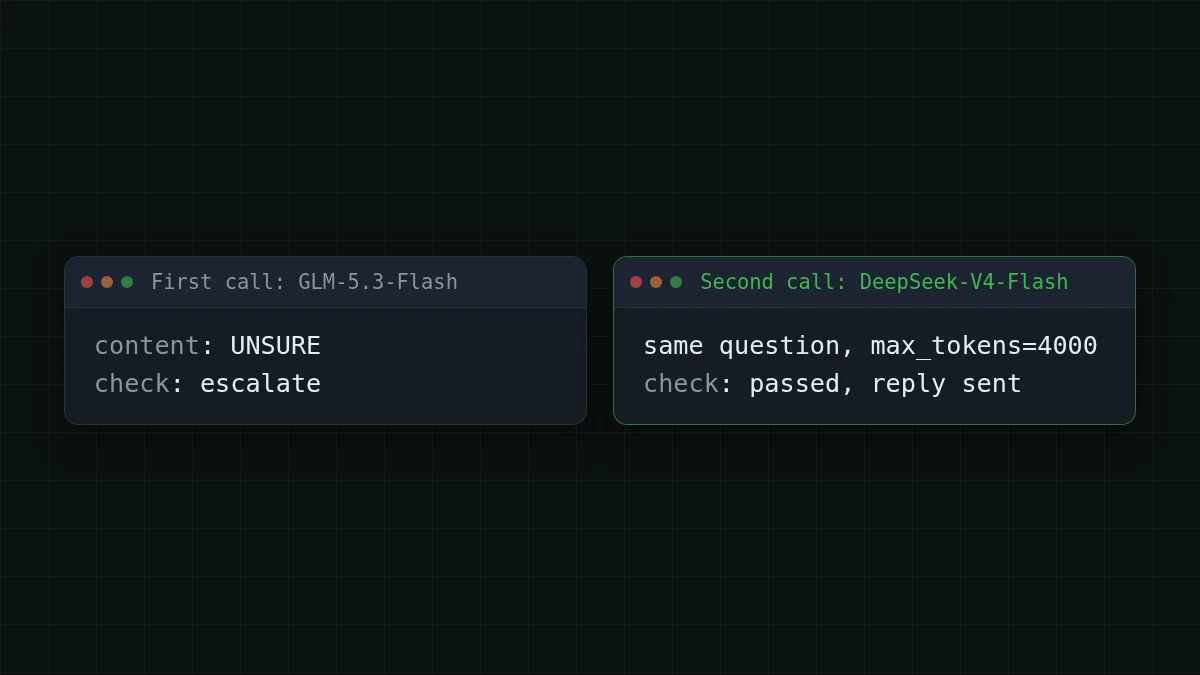
Sebagian besar tiket adalah FAQ singkat: di mana pesanan saya, bagaimana cara mereset kata sandi. Beberapa memerlukan jawaban panjang dan cermat. Mudah: model pertama menjawab dan tidak membalas UNSURE. Sulit: ia mengatakan UNSURE, atau jawaban terpotong (finish_reason adalah length).
Pipeline dokumen
Setiap dokumen melewati ekstraksi terlebih dahulu. Mudah: hasilnya terurai sebagai JSON valid dengan semua bidang yang diperlukan. Sulit: penguraian gagal atau ada bidang kosong. Hanya dokumen tersebut yang dijalankan ulang pada model kedua.
Agen coding
Edit sederhana dikirim ke model murah. Eskalasi sebuah langkah ketika langkah yang sama gagal dua kali berturut-turut, atau ketika jawaban terpotong (finish_reason adalah length).
Jangan melakukan eskalasi hanya karena "model terdengar tidak yakin" kecuali Anda memberi tahu cara mengatakannya. Instruksi satu baris ("balas persis UNSURE jika Anda tidak dapat menjawab") mengubah firasat menjadi sesuatu yang dapat dibaca oleh if.
Berapa biaya 10.000 permintaan: cascade vs router#
Katakanlah Anda menjalankan bot dukungan dengan 10.000 permintaan per bulan. Permintaan rata-rata adalah 800 token masuk dan 300 token keluar. Ini adalah asumsi; gantilah dengan milik Anda dari usage (artikel penghitungan token kami menunjukkan tempat membacanya).
Ada dua cara untuk merangkai routing, dan keduanya menagih secara berbeda:
- Cascade. Setiap permintaan dikirim ke model murah. Sebagian p gagal dalam pemeriksaan dan dikirim lagi ke model kedua. Permintaan tersebut dibayar dua kali: biaya = N × [murah + p × kedua].
- Router. Panggilan pengklasifikasi kecil memutuskan di awal. Yang mudah dikirim ke model murah, yang sulit langsung ke model kedua: biaya = N × [(1 − p) × murah + p × kedua], ditambah pengklasifikasi pada setiap permintaan.
Kami akan menggunakan cascade, karena tidak memerlukan pengklasifikasi dan lebih mudah untuk memulai. Pass pertama adalah GLM-5.3-Flash (zai-, konteks 390K, hingga 8.192 token keluaran). Pass kedua adalah DeepSeek-V4-Flash rilis 0731 (deepseek-, konteks 380K, hingga 32.768 token keluaran), sehingga jawaban yang tidak muat dalam 8.192 token memiliki ruang untuk diselesaikan. Keduanya lebih murah daripada OpenRouter secara total, dengan input dan output dihitung bersama; tabel langsung di bawah ini menunjukkan kolom OpenRouter di samping milik kami.
Pass pertama selalu mencakup semua 10.000 permintaan: 8.000.000 input dan 3.000.000 token output. Pass kedua hanya mencakup bagian yang dieskalasi. Kolom terakhir adalah alternatifnya: semua 10.000 permintaan langsung pada model kedua.
Gulir tabel ke kanan →
| Proporsi eskalasi | Token pass kedua (masuk / keluar) | Pass pertama, semua 10.000 | Pass kedua, hanya yang dieskalasi | Semua pada model kedua, semua 10.000 |
|---|---|---|---|---|
| 10% | 800.000 / 300.000 | $0.28 | $0.042 | $0.42 |
| 30% | 2.400.000 / 900.000 | $0.28 | $0.126 | $0.42 |
| 50% | 4.000.000 / 1.500.000 | $0.28 | $0.21 | $0.42 |
Jumlahkan kolom pass pertama dan pass kedua di setiap baris untuk mendapatkan biaya bulanan cascade, lalu bandingkan jumlah itu dengan kolom terakhir. Pass pertama adalah biaya tetap, dan hanya pass kedua yang tumbuh seiring p. Itulah inti dari cascade: semakin banyak yang Anda eskalasi, semakin dekat Anda membayar pekerjaan dua kali.
Berikut adalah beban yang sama untuk setiap model sekaligus, sehingga Anda dapat melihat di mana opsi model tunggal berada:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 10.000 permintaan | OpenRouter, 10.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
800 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Kapan cascade tidak layak? Ketika pass pertama ditambah bagian yang dieskalasi lebih mahal daripada mengirim semuanya ke model kedua. Dalam simbol: murah + p × kedua < kedua, yang berarti p < 1 − murah/kedua. Untuk pasangan ini, pass pertama menghabiskan proporsi yang cukup terlihat dari harga model kedua pada beban ini, sehingga keuntungan dari cascade menyusut, dan pada proporsi eskalasi tinggi keuntungan itu hilang. Pada 50%, cascade bisa kalah dibandingkan hanya mengirim semua 10.000 permintaan ke model kedua, jadi periksa jumlah kedua pass terhadap kolom terakhir sebelum Anda berkomitmen. Rasionya bergantung pada campuran input/output Anda, karena kedua model menetapkan harga kedua sisi secara berbeda, jadi bacalah dari baris Anda sendiri.
Varian router menambahkan satu hal: pengklasifikasi. Asumsikan ia membaca 300 token input dan menjawab dalam 5 token pada model murah, per permintaan. Untuk 10.000 permintaan itu berarti 3.000.000 input dan 50.000 token output, atau $0.062 per bulan tambahan. Bandingkan baris ini dengan proporsi p dari kolom pass pertama (10%, 30%, atau 50% darinya): itulah yang dibuang cascade dengan menjalankan pass pertama pada permintaan yang kemudian dieskalasi. Jika baris pengklasifikasi lebih besar, cascade adalah awal yang lebih murah; jika lebih kecil, router menghemat lebih banyak.
Cobalah angka Anda sendiri sebelum membangun apa pun:
Kalkulator biaya
Satu bulan bot dukungan, semuanya pada satu model
Token input per permintaan: 800 · Token output per permintaan: 300 · Permintaan per hari: 10.000
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
Ubah runs ke volume Anda dan baca total untuk setiap model. Kemudian gunakan tabel di atas untuk melihat berapa banyak yang akan ditambahkan oleh pass kedua.
Router dalam Python: dua panggilan dan satu pemeriksaan#
Kedua model berada di belakang satu base URL yang kompatibel dengan OpenAI dan satu saldo, sehingga routing tidak memerlukan akun atau kunci kedua. Kode di bawah ini adalah contoh: angka di dalamnya (max_tokens, aturan UNSURE) adalah milik Anda untuk disesuaikan. Panggilan kedua mendapatkan max_tokens yang lebih tinggi, sehingga jawaban yang terpotong pada 600 token dapat diselesaikan. Base URL, id model, dan sisanya ada di dokumentasi CheapTokens.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text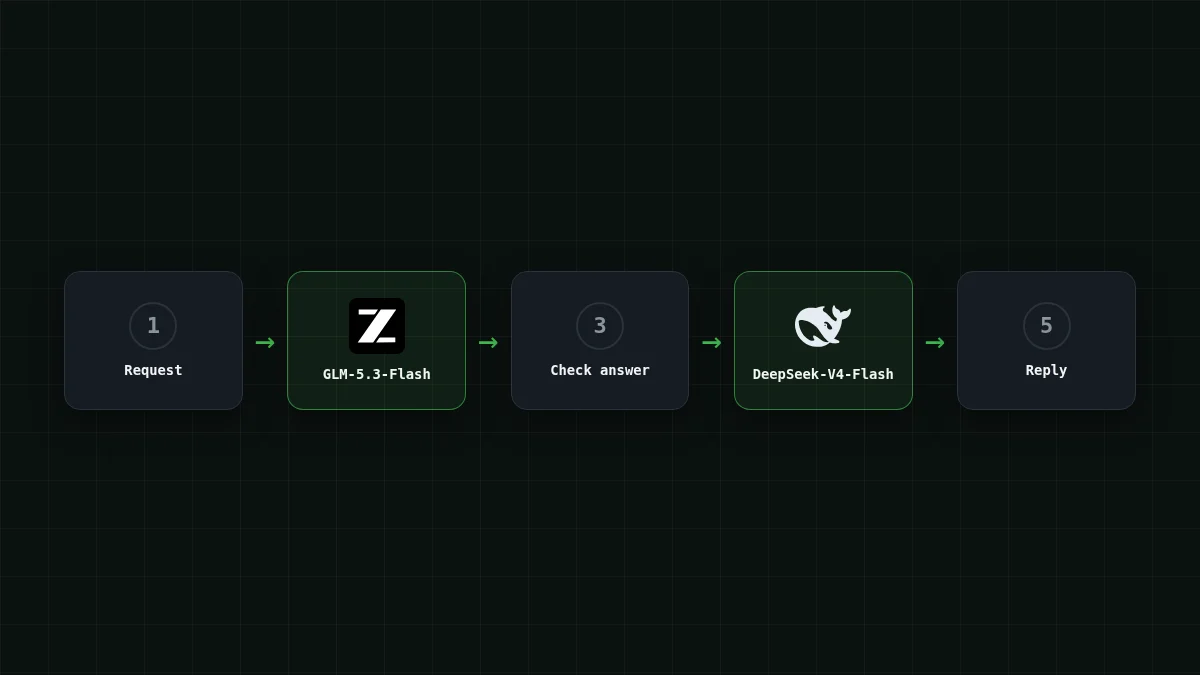
Tiga kebiasaan membuat ini jujur, bukan sekadar murah:
- Hitung eskalasinya. Catat seberapa sering
needs_escalationterpicu. Itulah p Anda, dan itu adalah angka yang menentukan apakah cascade menguntungkan. - Pilih model kedua berdasarkan set pengujian Anda sendiri. Ambil 50 permintaan sulit dari log Anda, jalankan melalui kedua model, dan pertahankan model kedua hanya jika ia memperbaiki yang terlewat oleh model pertama. Keunggulan terdokumentasinya adalah batas jawaban 32.768 token, dan set Anda sendiri menunjukkan apakah itu keunggulan yang Anda butuhkan.
- Kirim permintaan yang sama, bukan yang lebih panjang. Jika Anda menempelkan jawaban yang gagal ke panggilan kedua, Anda membayarnya sebagai input. Mulailah pass kedua dengan bersih kecuali jawaban pertama benar-benar konteks yang berguna.
Uji diri Anda#
Cek cepat
Dalam cascade, 30% permintaan gagal dalam pemeriksaan pada model pertama. Berapa biaya permintaan tersebut?
Tampilkan jawaban
Jawaban: Harga model pertama ditambah harga model kedua
Panggilan pertama sudah ditagih saat Anda membuang jawabannya. Permintaan yang dieskalasi membayar dua kali, itulah sebabnya proporsi p menentukan segalanya.
Ke mana selanjutnya#
Jika Anda tidak yakin model mana yang harus mengambil pass pertama, MiniMax-M2.7 vs DeepSeek-V4-Flash membandingkannya berdasarkan tugas. Untuk tampilan per tugas alih-alih per token, lihat harga per 1 juta token vs biaya per tugas, dan untuk loop dengan banyak langkah, cara memperkirakan biaya agen AI. Harga langsung untuk setiap model ada di halaman harga, dan halaman modelnya adalah DeepSeek dan GLM.


