لاگت کی بہتریگائیڈ
API لاگت کم کرنے کے لیے ماڈل روٹنگ: پہلے سستا ماڈل، پھر ایسکلیٹ
آسان درخواستیں سستے ماڈل کو بھیجیں اور صرف مشکل والی ایسکلیٹ کریں۔ 10,000 درخواستوں کی ملاوٹی لاگت 10%، 30% اور 50% ایسکلیشن پر دیکھیں، نیز ایک مختصر Python روٹر۔
اس صفحہ پر
روٹنگ بل کو کم کر سکتی ہے جب سستے ماڈل کا پہلا پاس دوسرے ماڈل سے کہیں سستا ہو اور بہت کم درخواستیں ایسکلیٹ ہوں: ہر درخواست پہلے سستے ماڈل کو بھیجیں اور صرف مشکل والی دوبارہ دوسرے ماڈل کو بھیجیں۔ آپ واقعی بچت کرتے ہیں یا نہیں، یہ اس حصے پر منحصر ہے جو آپ ایسکلیٹ کرتے ہیں۔ نیچے 10,000 درخواستوں کا حساب 10%، 30% اور 50% پر ہے، اور ایک Python فنکشن جو آپ اپنے پروجیکٹ میں پیسٹ کر سکتے ہیں۔
یہ پیٹرن نیا نہیں ہے۔ Anthropic کی انجینئرنگ پوسٹ "Building effective agents" (19 دسمبر 2024) اسے روٹنگ ورک فلو کہتی ہے: عام، آسان سوالات چھوٹے، کم لاگت والے ماڈل کو جاتے ہیں، اور غیر معمولی، مشکل والے زیادہ قابل ماڈل کو۔ پوسٹ میں کوئی قیمتیں نہیں دی گئیں، اس لیے یہاں کے نمبر ہمارے اپنے ہیں، لائیو CheapTokens قیمتوں پر۔
آپ کی کون سی درخواستیں آسان ہیں؟#
روٹنگ صرف اس وقت کام کرتی ہے جب آپ کسی اصول میں بتا سکیں کہ "مشکل" کا مطلب کیا ہے۔ کسی احساس میں نہیں، بلکہ ایک اصول میں جسے کوڈ چیک کر سکے۔ اپنے کیس کے قریب ترین کیس منتخب کریں:
اپنا کیس منتخب کریں
اپنا کیس منتخب کریں
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
سپورٹ چیٹ بوٹ
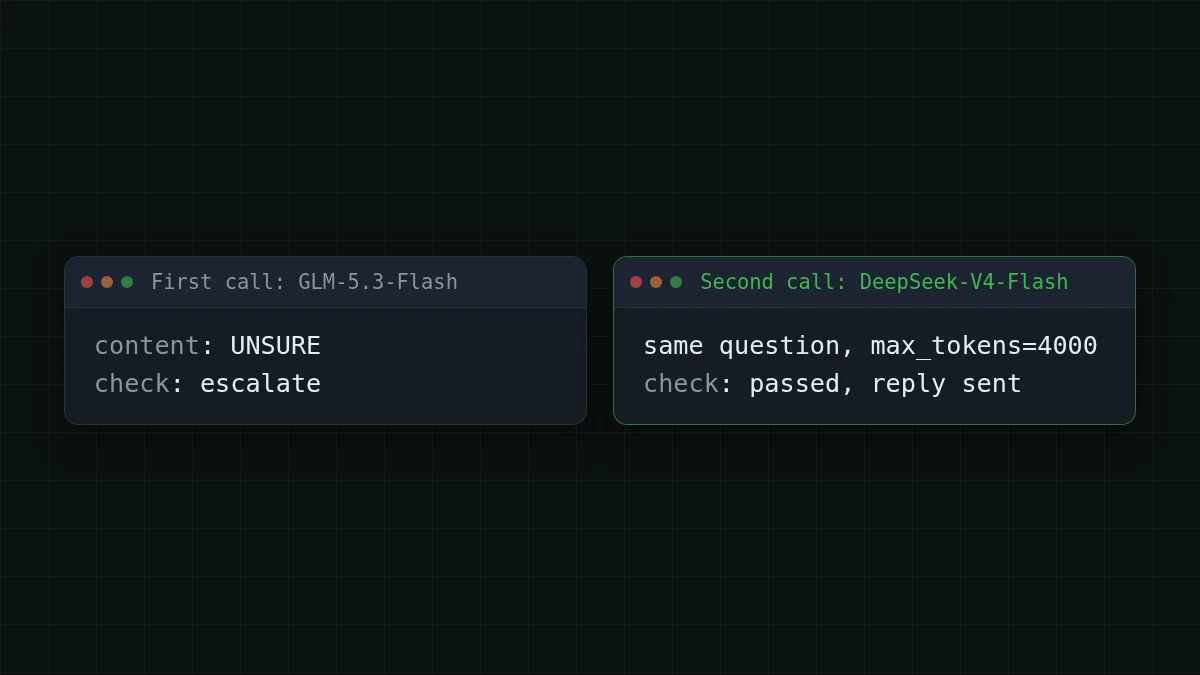
زیادہ تر ٹکٹس مختصر FAQs ہوتے ہیں: میرا آرڈر کہاں ہے، پاس ورڈ کیسے ری سیٹ کروں۔ کچھ کو طویل، محتاط جواب کی ضرورت ہوتی ہے۔ آسان: پہلا ماڈل جواب دیتا ہے اور UNSURE کا جواب نہیں دیتا۔ مشکل: یہ UNSURE کہتا ہے، یا جواب کٹ جاتا ہے (finish_reason length ہے)۔
دستاویز پائپ لائن
ہر دستاویز پہلے ایکسٹریکشن سے گزرتی ہے۔ آسان: نتیجہ تمام مطلوبہ فیلڈز کے ساتھ درست JSON کے طور پر پارس ہوتا ہے۔ مشکل: پارس ناکام ہو جاتا ہے یا کوئی فیلڈ خالی ہے۔ صرف وہی دستاویزات دوسرے ماڈل پر دوبارہ چلائی جاتی ہیں۔
کوڈنگ ایجنٹ
سادہ ایڈیٹس سستے ماڈل کو جاتے ہیں۔ کسی مرحلے کو ایسکلیٹ کریں جب وہی مرحلہ لگاتار دو بار ناکام ہو، یا جب جواب کٹ جائے (finish_reason length ہے)۔
"ماڈل غیر یقینی لگتا ہے" پر ایسکلیٹ نہ کریں جب تک آپ نے اسے بتا نہ دیا ہو کہ یہ کیسے کہنا ہے۔ ایک سطری ہدایت ("بالکل UNSURE جواب دیں اگر آپ جواب نہیں دے سکتے") ایک وائب کو ایسی چیز میں بدل دیتی ہے جو if پڑھ سکے۔
10,000 درخواستوں کی لاگت: کاسکیڈ بمقابلہ روٹر#
فرض کریں آپ مہینے میں 10,000 درخواستوں کے ساتھ سپورٹ بوٹ چلاتے ہیں۔ اوسط درخواست 800 ٹوکن ان اور 300 ٹوکن آؤٹ ہے۔ یہ مفروضے ہیں؛ اپنے usage سے تبدیل کریں (ہمارا ٹوکن گنتی مضمون دکھاتا ہے کہ انہیں کہاں سے پڑھیں)۔
روٹنگ کو وائر کرنے کے دو طریقے ہیں، اور وہ مختلف بل کرتے ہیں:
- کاسکیڈ۔ ہر درخواست سستے ماڈل کو جاتی ہے۔ ایک حصہ p چیک میں ناکام ہوتا ہے اور دوبارہ دوسرے ماڈل کو بھیجا جاتا ہے۔ ان درخواستوں کی دو بار ادائیگی ہوتی ہے: لاگت = N × [سستا + p × دوسرا]۔
- روٹر۔ ایک چھوٹا کلاسیفائر کال پہلے سے فیصلہ کرتا ہے۔ آسان والے سستے ماڈل کو، مشکل والے سیدھا دوسرے کو: لاگت = N × [(1 − p) × سستا + p × دوسرا]، نیز ہر درخواست پر کلاسیفائر۔
ہم کاسکیڈ استعمال کریں گے، کیونکہ اسے کسی کلاسیفائر کی ضرورت نہیں اور یہ شروع کرنے میں آسان ہے۔ پہلا پاس GLM-5.3-Flash ہے (zai-، 390K کانٹیکسٹ، زیادہ سے زیادہ 8,192 آؤٹ پٹ ٹوکن)۔ دوسرا پاس DeepSeek-V4-Flash ریلیز 0731 ہے (deepseek-، 380K کانٹیکسٹ، زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکن)، تاکہ جو جواب 8,192 ٹوکن میں نہ آیا ہو اسے مکمل ہونے کی گنجائش ملے۔ دونوں مجموعی طور پر OpenRouter سے سستے ہیں، ان پٹ اور آؤٹ پٹ کو ملا کر گنا جاتا ہے؛ نیچے لائیو ٹیبل ہمارے ساتھ OpenRouter کالم دکھاتا ہے۔
پہلا پاس ہمیشہ تمام 10,000 درخواستیں کور کرتا ہے: 8,000,000 ان پٹ اور 3,000,000 آؤٹ پٹ ٹوکن۔ دوسرا پاس صرف ایسکلیٹ شدہ حصہ کور کرتا ہے۔ آخری کالم متبادل ہے: تمام 10,000 درخواستیں سیدھا دوسرے ماڈل پر۔
ٹیبل کو دائیں طرف اسکرول کریں →
| ایسکلیٹ شدہ حصہ | دوسرے پاس کے ٹوکن (ان / آؤٹ) | پہلا پاس، تمام 10,000 | دوسرا پاس، صرف ایسکلیٹ شدہ | سب کچھ دوسرے ماڈل پر، تمام 10,000 |
|---|---|---|---|---|
| 10% | 800,000 / 300,000 | $0.28 | $0.042 | $0.42 |
| 30% | 2,400,000 / 900,000 | $0.28 | $0.126 | $0.42 |
| 50% | 4,000,000 / 1,500,000 | $0.28 | $0.21 | $0.42 |
ہر قطار میں پہلے پاس اور دوسرے پاس کے کالم جمع کریں تاکہ کاسکیڈ کا مہینہ ملے، پھر اس مجموعے کا آخری کالم سے موازنہ کریں۔ پہلا پاس ایک مقررہ لاگت ہے، اور صرف دوسرا پاس p کے ساتھ بڑھتا ہے۔ یہی کاسکیڈ کی پوری کہانی ہے: جتنا زیادہ آپ ایسکلیٹ کرتے ہیں، اتنا ہی آپ کام کی دو بار ادائیگی کے قریب پہنچتے ہیں۔
یہاں ایک ہی وقت میں ہر ماڈل کے لیے وہی لوڈ ہے، تاکہ آپ دیکھ سکیں کہ سنگل ماڈل آپشنز کہاں آتے ہیں:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 10,000 درخواستیں | OpenRouter، 10,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.28 | $0.517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.42 | $0.98 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.85 | $10.20 |
فی درخواست 800 ان پٹ اور 300 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
کاسکیڈ کب فائدہ مند نہیں؟ جب پہلا پاس جمع ایسکلیٹ شدہ حصہ سب کچھ دوسرے ماڈل کو بھیجنے سے زیادہ مہنگا ہو۔ علامتوں میں: سستا + p × دوسرا < دوسرا، جس کا مطلب ہے p < 1 − سستا/دوسرا۔ اس جوڑی کے لیے، پہلا پاس اس لوڈ پر دوسرے ماڈل کی قیمت کا نمایاں حصہ ہے، اس لیے کاسکیڈ سے فائدہ کم ہوتا ہے، اور زیادہ ایسکلیشن حصے پر غائب ہو جاتا ہے۔ 50% پر کاسکیڈ صرف تمام 10,000 درخواستیں دوسرے ماڈل کو بھیجنے سے ہار سکتا ہے، اس لیے عہد کرنے سے پہلے دونوں پاسوں کا مجموعہ آخری کالم سے چیک کریں۔ تناسب آپ کے ان پٹ/آؤٹ پٹ مکس پر منحصر ہے، کیونکہ دونوں ماڈل دونوں اطراف کی مختلف قیمت لگاتے ہیں، اس لیے اسے اپنی قطار سے پڑھیں۔
روٹر ویرینٹ ایک چیز شامل کرتا ہے: کلاسیفائر۔ فرض کریں یہ 300 ان پٹ ٹوکن پڑھتا ہے اور سستے ماڈل پر 5 ٹوکن میں جواب دیتا ہے، فی درخواست۔ 10,000 درخواستوں کے لیے یہ 3,000,000 ان پٹ اور 50,000 آؤٹ پٹ ٹوکن ہے، یا اوپر $0.062 ماہانہ۔ اس لائن کا پہلے پاس کے کالم کے حصہ p (اس کا 10%، 30% یا 50%) سے موازنہ کریں: یہی وہ چیز ہے جو کاسکیڈ ان درخواستوں پر پہلا پاس چلا کر ضائع کرتا ہے جو پھر ایسکلیٹ ہوتی ہیں۔ اگر کلاسیفائر لائن بڑی ہے، تو کاسکیڈ سستا آغاز ہے؛ اگر چھوٹی ہے، تو روٹر زیادہ بچاتا ہے۔
کچھ بنانے سے پہلے اپنے نمبر آزمائیں:
لاگت کیلکولیٹر
سپورٹ بوٹ کا ایک مہینہ، سب کچھ ایک ماڈل پر
فی درخواست ان پٹ ٹوکنز: 800 · فی درخواست آؤٹ پٹ ٹوکنز: 300 · فی دن درخواستیں: 10,000
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.28 | $8.40 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.42 | $12.60 |
| MiniMax-M2.7$0.05$0.15 | $0.85 | $25.50 |
runs کو اپنے حجم میں تبدیل کریں اور ہر ماڈل کا کل پڑھیں۔ پھر اوپر والا ٹیبل استعمال کریں تاکہ دیکھ سکیں کہ دوسرا پاس اس میں کتنا اضافہ کرے گا۔
Python میں ایک روٹر: دو کالیں اور ایک چیک#
دونوں ماڈل ایک OpenAI-مطابق بیس URL اور ایک بیلنس کے پیچھے ہیں، اس لیے روٹنگ کو دوسرے اکاؤنٹ یا کی کی ضرورت نہیں۔ نیچے کوڈ ایک مثال ہے: اس میں موجود نمبر (max_tokens، UNSURE اصول) آپ کے ٹیون کرنے کے لیے ہیں۔ دوسری کال کو زیادہ max_tokens ملتا ہے، تاکہ 600 ٹوکن پر کٹا ہوا جواب مکمل ہو سکے۔ بیس URL، ماڈل آئی ڈیز اور باقی CheapTokens ڈاکس میں ہیں۔
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

CHEAP = 'zai-org/GLM-5.3-Flash'
SECOND = 'deepseek-ai/DeepSeek-V4-Flash-0731'
SYSTEM = 'Answer briefly. If you cannot answer well, reply exactly UNSURE.'


def ask(model, question, max_tokens):
    r = client.chat.completions.create(
        model=model,
        max_tokens=max_tokens,
        messages=[
            {'role': 'system', 'content': SYSTEM},
            {'role': 'user', 'content': question},
        ],
    )
    choice = r.choices[0]
    return choice.message.content or '', choice.finish_reason


def needs_escalation(text, finish_reason):
    return finish_reason == 'length' or not text.strip() or 'UNSURE' in text


def answer(question):
    text, why = ask(CHEAP, question, 600)
    if needs_escalation(text, why):
        text, why = ask(SECOND, question, 4000)
        if 'UNSURE' in text:
            text = 'Sorry, I could not answer this one.'
    return text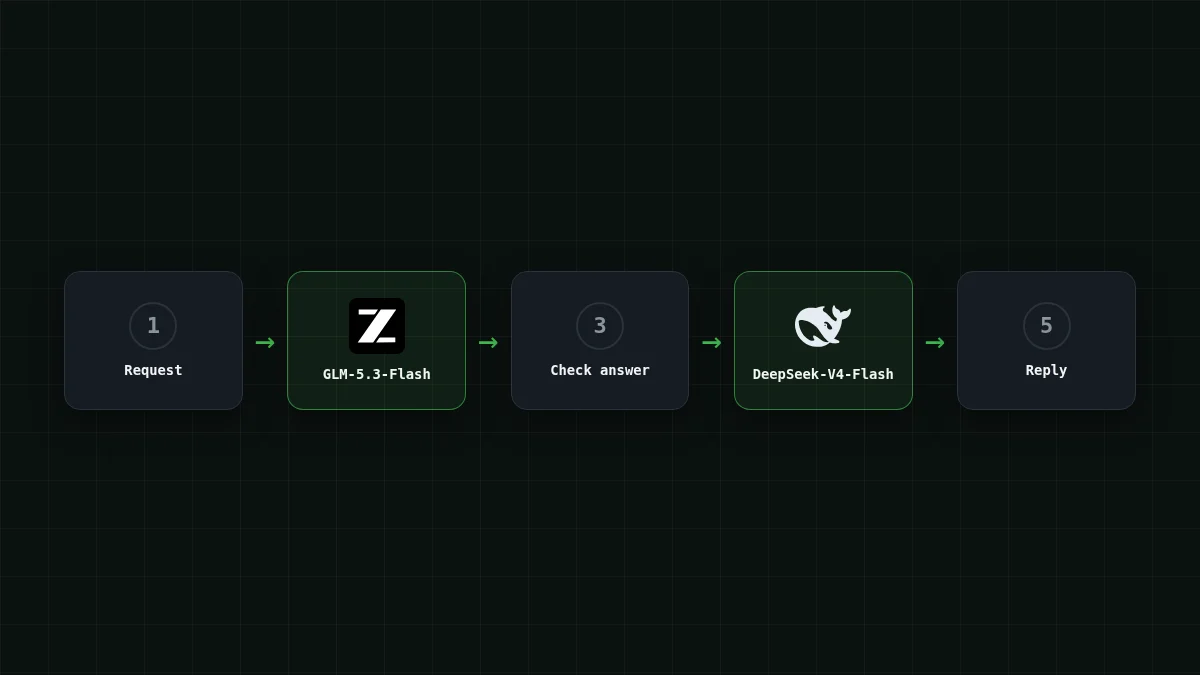
تین عادات اسے صرف سستا نہیں بلکہ ایماندار بناتی ہیں:
- ایسکلیشنز گنیں۔ لاگ کریں کہ
needs_escalationکتنی بار فائر ہوتا ہے۔ یہی آپ کا p ہے، اور یہی وہ نمبر ہے جو فیصلہ کرتا ہے کہ کاسکیڈ فائدہ دیتا ہے یا نہیں۔ - دوسرا ماڈل اپنے ٹیسٹ سیٹ پر منتخب کریں۔ اپنے لاگز سے 50 مشکل درخواستیں لیں، دونوں ماڈلز سے گزاریں اور دوسرا ماڈل صرف اس وقت رکھیں جب یہ وہ درخواستیں ٹھیک کرے جو پہلے نے چھوڑ دیں۔ اس کا دستاویزی برتری 32,768-ٹوکن جواب کی حد ہے، اور آپ کا اپنا سیٹ دکھاتا ہے کہ آیا یہی وہ برتری ہے جس کی آپ کو ضرورت ہے۔
- وہی درخواست بھیجیں، لمبی نہیں۔ اگر آپ ناکام جواب دوسری کال میں پیسٹ کرتے ہیں، تو آپ اس کی ان پٹ کے طور پر ادائیگی کرتے ہیں۔ دوسرا پاس صاف شروع کریں جب تک پہلا جواب واقعی مفید کانٹیکسٹ نہ ہو۔
خود کو جانچیں#
فوری جانچ
کاسکیڈ میں، 30% درخواستیں پہلے ماڈل پر چیک میں ناکام ہوتی ہیں۔ ان درخواستوں کی کیا لاگت ہے؟
جواب دکھائیں
جواب: پہلے ماڈل کی قیمت جمع دوسرے ماڈل کی قیمت
پہلی کال کا بل پہلے ہی ہو چکا ہے جب آپ اس کا جواب پھینکتے ہیں۔ ایسکلیٹ شدہ درخواستیں دو بار ادائیگی کرتی ہیں، اسی لیے حصہ p سب کچھ طے کرتا ہے۔
آگے کہاں جائیں#
اگر آپ کو یقین نہیں کہ پہلا پاس کون سا ماڈل لے، تو MiniMax-M2.7 بمقابلہ DeepSeek-V4-Flash ان کا کام کے لحاظ سے موازنہ کرتا ہے۔ فی ٹوکن کے بجائے فی کام کے نظارے کے لیے، قیمت فی 1M ٹوکن بمقابلہ لاگت فی کام دیکھیں، اور بہت سے مراحل والے لوپس کے لیے، AI ایجنٹ کی لاگت کا اندازہ کیسے لگائیں۔ ہر ماڈل کی لائیو قیمتیں قیمتوں کے صفحے پر ہیں، اور ماڈل صفحات DeepSeek اور GLM ہیں۔


