نئے سیکھنے والوں کے لیے AIگائیڈ
فی 1M ٹوکن قیمت بمقابلہ فی کام لاگت: AI ماڈلز کا موازنہ کیسے کریں
کم فی 1M ٹوکن قیمت والا ماڈل پھر بھی فی مکمل کام زیادہ مہنگا ہو سکتا ہے۔ ٹوکن ان، ٹوکن آؤٹ اور کوششوں سے فی کام لاگت نکالنا سیکھیں۔
اس صفحہ پر
ماڈلز کا موازنہ اس بات سے کریں کہ مکمل شدہ کام کی کیا قیمت پڑتی ہے، نہ کہ فی 1M ٹوکن قیمت سے۔ ایک کام کی لاگت = ٹوکن ان × ان پٹ قیمت + ٹوکن آؤٹ × آؤٹ پٹ قیمت، جسے جتنے بھی کوششیں لگیں اس سے ضرب دیں۔ لہٰذا فی ٹوکن آدھی قیمت والا ماڈل بھی آپ کو بڑا بل دے سکتا ہے۔
یہی عام حیرت ہے: ایجنٹ مکمل ہو گیا، قیمت کی فہرست سستی لگی، اور انوائس کام کی مستحق قیمت سے بڑی ہے۔ آئیے دیکھیں فرق کہاں چھپا ہے۔
فی ٹوکن قیمت فی کلو قیمت ہے#
آٹے کی فی کلو قیمت رات کے کھانے کی لاگت کے بارے میں کچھ نہیں بتاتی۔ آپ کو جاننا ہوگا کہ ترکیب میں کتنے کلو لگتے ہیں، اور کیا آپ پہلا بیچ جلا کر دوبارہ شروع کرتے ہیں۔
AI ماڈلز اسی طرح کام کرتے ہیں۔ فی 1M ٹوکن قیمت فی کلو قیمت ہے۔ کام رات کا کھانا ہے۔ ہر درخواست کے دو پہلوؤں پر بل لگتا ہے: آپ کے بھیجے گئے ٹوکن (ان پٹ) اور ماڈل کے لکھے گئے ٹوکن (آؤٹ پٹ)۔ دونوں نمبر ہر جواب کے usage فیلڈ میں واپس آتے ہیں، جیسے کہ https:/ پر CheapTokens API جیسی OpenAI-مطابق API سے (29 اکتوبر 2026 کو چیک کیا گیا)، تاکہ آپ کو کبھی اندازہ نہ لگانا پڑے۔
پورا فارمولا یہ ہے:
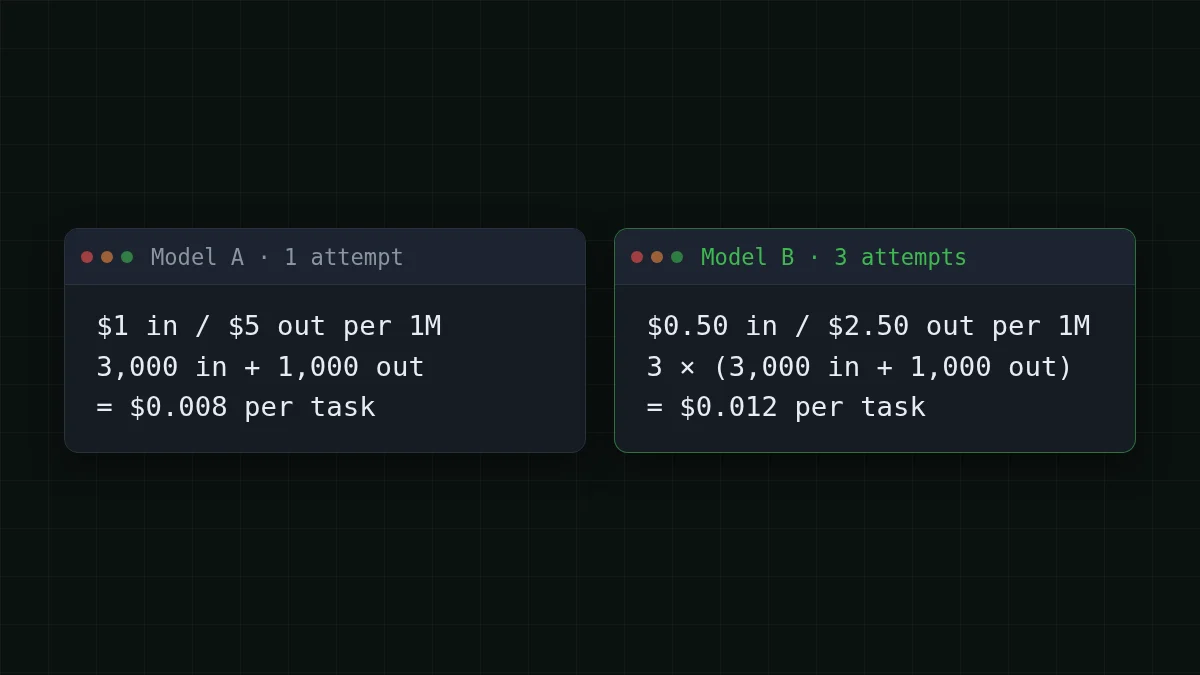
cost per task = attempts × (tokens in × input price + tokens out × output price)فرض کریں ایک کام 3,000 ٹوکن بھیجتا ہے اور 1,000 واپس لیتا ہے۔ ماڈل A کی ان پٹ قیمت $1 فی 1M ٹوکن اور آؤٹ پٹ $5 ہے۔ ماڈل B اس سے آدھا ہے: $0.50 اور $2.50۔ (یہ حساب کے لیے بنائی گئی گول قیمتیں ہیں، کسی کی قیمت کی فہرست نہیں۔)
ماڈل A، ایک کوشش:
- 3,000 × $1 ÷ 1,000,000 = ان پٹ کے لیے $0.003
- 1,000 × $5 ÷ 1,000,000 = آؤٹ پٹ کے لیے $0.005
- $0.003 + $0.005 = فی کام $0.008
ماڈل B سودے کی طرح لگتا ہے۔ لیکن فرض کریں اسے قابل استعمال نتیجہ حاصل کرنے میں تین کوششیں لگتی ہیں، اور ہر کوشش کی قیمت یکساں ہے:
- 3,000 × $0.50 ÷ 1,000,000 = ان پٹ کے لیے $0.0015
- 1,000 × $2.50 ÷ 1,000,000 = آؤٹ پٹ کے لیے $0.0025
- $0.0015 + $0.0025 = فی کوشش $0.004
- 3 × $0.004 = فی کام $0.012
فی ٹوکن آدھی قیمت، فی کام ڈیڑھ گنا قیمت۔ یہی چیز دوبارہ کوشش کے بغیر بھی ہوتی ہے اگر B صرف لمبے جواب لکھے: ایک کوشش میں 3,000 آؤٹ پٹ ٹوکن کے ساتھ، 3,000 × $2.50 ÷ 1,000,000 = $0.0075، اور $0.0015 + $0.0075 = $0.009۔ پھر بھی A کے $0.008 سے زیادہ۔
اور الٹا بھی درست ہے۔ اگر B پہلی بار ہی درست کر لے، تو فی کام $0.004 لاگت آتی ہے، A کا آدھا۔ فی ٹوکن قیمت صرف اسی وقت جیتتی ہے جب ٹوکن اور کوششوں کی تعداد تقریباً برابر ہو۔ اور یہی چیک کرنے والی چیز ہے۔
فلیش کارڈز
ہر API دستاویز میں ملنے والے الفاظ
پلٹنے کے لیے کارڈ پر ٹیپ کریں
فی کام ٹوکن اصل میں کہاں جاتے ہیں#
تین چیزیں ٹوکن کی تعداد کو متاثر کرتی ہیں، اور ان میں سے کوئی بھی قیمت کی فہرست میں نظر نہیں آتی۔
- جواب کی لمبائی۔ جو ماڈل تفصیل سے خود کو سمجھاتا ہے وہ ایک سطر میں جواب دینے والے سے زیادہ آؤٹ پٹ ٹوکن لکھتا ہے۔
- دوبارہ کوششیں۔ ناکام یا ناقابل استعمال جواب پر بھی ٹوکن لگے، اور اگلی کوشش پھر ادا کرتی ہے۔
- دوبارہ بھیجا گیا سیاق و سباق۔ API یاد نہیں رکھتا: ایجنٹ کا ہر مرحلہ ہدایات، فائلیں اور تاریخ دوبارہ بھیجتا ہے۔ اگر یہ نیا ہے، تو لمبی چیٹ زیادہ مہنگی کیوں ہے طریقہ کار دکھاتا ہے۔
تیسری چیز ایجنٹس کے لیے سب سے بڑی ہے۔ ایک کوڈنگ ایجنٹ لیں جو 20 مراحل میں کام کرتا ہے۔ فرض کریں ایک بھاری ایجنٹ مرحلہ: 20,000 ٹوکن ان اور 1,000 واپس۔ حقیقی مرحلہ وار نمبروں کے ساتھ ہلکے رن کے لیے، AI ایجنٹس اتنے زیادہ ٹوکن کیوں استعمال کرتے ہیں دیکھیں۔ جوابات مختصر ہیں۔ ان پٹ نہیں۔
نمبر کا اندازہ لگائیں
20 مرحلوں والا ایجنٹ کل کتنے ان پٹ ٹوکن بھیجتا ہے، اگر ہر مرحلہ 20,000 بھیجے؟
آپ کا اندازہ
01,000,000
جواب دکھائیں
جواب: 400,000
20 × 20,000 = 400,000۔ ہر مرحلہ سیاق و سباق دوبارہ بھیجتا ہے، لہٰذا ان پٹ جمع ہوتا جاتا ہے حالانکہ ہر جواب مختصر ہے۔
تو اس کام کے لیے ان پٹ پہلو بل کا فیصلہ کرتا ہے، اور آؤٹ پٹ پہلو تقریباً اہم نہیں۔ سستے ان پٹ قیمت والا ماڈل یہاں جیت سکتا ہے چاہے اس کی آؤٹ پٹ قیمت عام لگے۔ یہ وہ چیز ہے جو قیمت کی فہرست صرف اس وقت دکھاتی ہے جب آپ اسے اپنے کام کو ذہن میں رکھتے ہوئے پڑھیں۔
یہی وہ کام ہے، 20,000 ان اور 1,000 آؤٹ کے 20 مراحل، CheapTokens پر دستیاب ماڈلز پر۔ جدول لائیو ہے، لہٰذا نمبر موجودہ قیمتوں کے مطابق ہیں، اور OpenRouter کالم موازنے کے لیے ہے۔ ان پٹ اور آؤٹ پٹ کو ملا کر، تینوں مجموعی طور پر OpenRouter سے سستے ہیں۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 20 درخواستیں | OpenRouter، 20 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
فی درخواست 20,000 ان پٹ اور 1,000 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اس طرح کے ایجنٹ لوپس کے لیے، DeepSeek-V4-Flash قدرتی انتخاب ہے: 380K سیاق و سباق، فی جواب 32,768 آؤٹ پٹ ٹوکن تک، اور دن کے کسی بھی وقت ایک ہی قیمت، لہٰذا رات کا رن دن کے رن جتنا ہی مہنگا ہے۔ اس پر تمام 20 مراحل میں پورا کام $0.008 بنتا ہے۔ تفصیلات کے لیے ماڈل صفحہ اور ہر ماڈل کے لیے قیمتوں کا جدول دیکھیں۔
چیٹ بوٹ الٹی کہانی ہے#
اب ایک سپورٹ بوٹ لیں۔ فرض کریں اسے روزانہ 1,000 درخواستیں آتی ہیں، اور ہر ایک سیاق و سباق کے ساتھ 2,000 ٹوکن کا سوال اور 500 ٹوکن کا جواب ہے۔ کوئی لوپ نہیں، کوئی بڑھتی تاریخ نہیں، ایک کوشش۔
یہاں فی ٹوکن قیمت تقریباً فی کام لاگت ہے، کیونکہ اسے کوئی چیز ضرب نہیں دیتی۔ GLM-5.3-Flash پر، 390K سیاق و سباق اور فی جواب 8,192 آؤٹ پٹ ٹوکن تک کے ساتھ، ایک درخواست کی لاگت $0.00006 ہے اور 1,000 درخواستوں کا پورا دن $0.06 بنتا ہے۔
تو اصول سادہ ہے۔ مختصر، یک بار کا کام: فی ٹوکن قیمت مناسب رہنما ہے۔ لوپ، دوبارہ کوشش والا کام یا لمبے جواب والا کام: انتخاب سے پہلے پورے کام کی قیمت لگائیں۔
اپنا کام دس منٹ میں ناپیں#
آپ کے اپنے نمبر یہاں کی کسی مثال سے بہتر ہیں۔ نیچے دیا گیا اسکرپٹ ایک درخواست بھیجتا ہے اور بتاتا ہے کہ اس نے اصل میں کیا استعمال کیا اور اس کی کیا لاگت آئی۔ اس میں قیمتیں مثال کے طور پر ہیں: موجودہ قیمتیں قیمتوں کے جدول سے بدلیں۔
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
جب یہ کام کرے تو آپ کو ایک سطر میں تین نمبر ملیں گے: ٹوکن ان، ٹوکن آؤٹ اور اس کوشش کی لاگت۔ پھر:
- اپنے 20 حقیقی کام چلائیں، کھلونے والے نہیں۔
- ہر کوشش کی لاگت جمع کریں، بشمول وہ جو آپ نے پھینک دیں۔
- 20 سے تقسیم کریں۔ یہی آپ کی فی کام لاگت ہے۔
- دوسرے ماڈل کے ساتھ دہرائیں اور دونوں نتائج کا موازنہ کریں۔
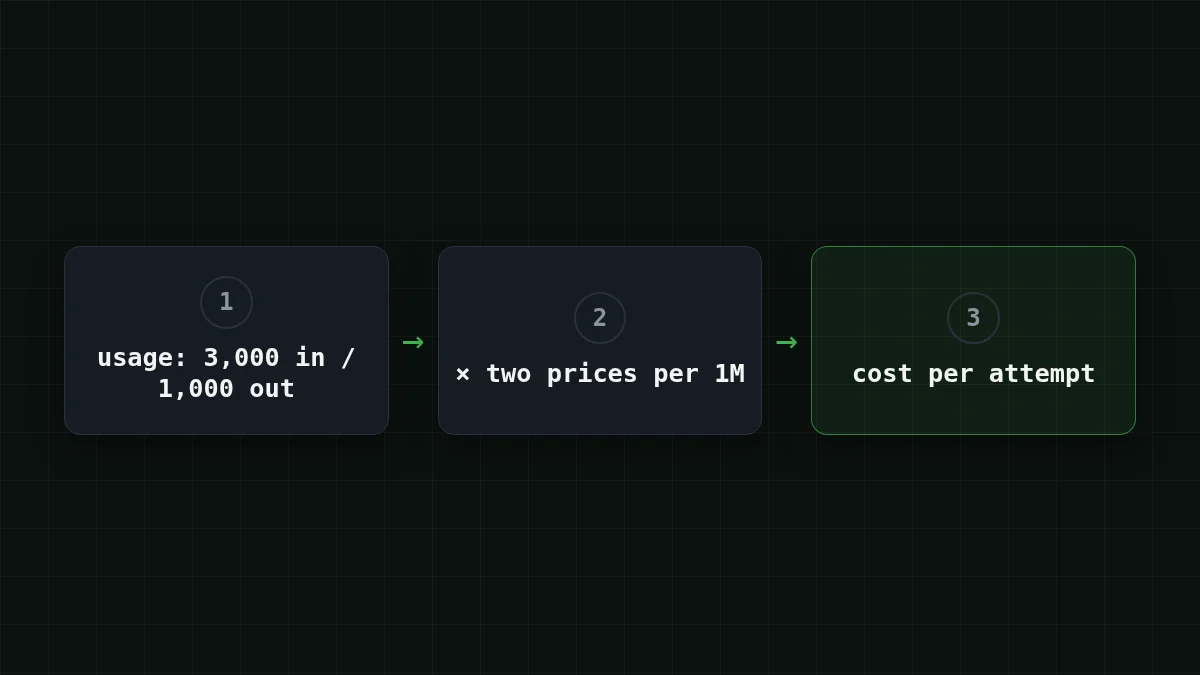
لمبے رن کے لیے، Python میں ایجنٹ ٹوکن لاگت ٹریک کرنا اسی خیال میں بجٹ اور اسٹاپ شامل کرتا ہے، اور ایک درخواست کتنے ٹوکن استعمال کرتی ہے شروع کرنے کے لیے عام سائز دکھاتا ہے۔
فوری جانچ#
فوری جانچ
ماڈل B کی فی ٹوکن قیمت ماڈل A سے آدھی ہے۔ B پھر بھی فی مکمل کام زیادہ مہنگا کب ہو سکتا ہے؟
جواب دکھائیں
جواب: جب اسے زیادہ کوششیں درکار ہوں یا بہت لمبے جواب لکھے
فی کام لاگت = کوششیں × ٹوکن × قیمت۔ قیمت آدھی کریں، کوششیں تین گنا کریں اور آپ 1.5 گنا ادا کرتے ہیں۔
اگے، ان پٹ بمقابلہ آؤٹ پٹ ٹوکن بتاتا ہے کہ دونوں پہلوؤں کی قیمت مختلف کیوں ہے، اور دستاویزات آپ کو کلید سے پہلی درخواست تک لے جاتی ہیں۔


