AI 입문가이드
1M 토큰당 가격 vs 작업당 비용: AI 모델을 비교하는 방법
1M 토큰당 가격이 더 낮은 모델도 완료된 작업당 비용은 더 높을 수 있습니다. 입력 토큰, 출력 토큰, 시도 횟수로 작업당 비용을 계산하는 방법을 배우세요.
완료된 작업의 비용으로 모델을 비교하세요. 1M 토큰당 가격으로 비교하지 마세요. 작업 비용은 입력 토큰 수 × 입력 가격 + 출력 토큰 수 × 출력 가격에 시도 횟수를 곱한 값입니다. 따라서 토큰당 가격이 절반인 모델이 더 큰 청구서를 안겨줄 수 있습니다.
흔한 놀라움은 이렇습니다. 에이전트는 끝났고, 가격표는 저렴해 보였는데, 청구서는 작업에 비해 너무 큽니다. 차이가 어디에 숨어 있는지 알아봅시다.
토큰당 가격은 킬로당 가격이다#
밀가루 킬로당 가격은 저녁 식사 비용에 대해 아무것도 알려주지 않습니다. 레시피에 밀가루가 몇 킬로 필요한지, 첫 배치를 태워버리고 다시 시작하는지 알아야 합니다.
AI 모델도 같은 방식입니다. 1M 토큰당 가격은 킬로당 가격입니다. 작업은 저녁 식사입니다. 모든 요청은 양쪽으로 청구됩니다. 보내는 토큰(입력)과 모델이 다시 쓰는 토큰(출력)입니다. 두 숫자 모두 https:/의 CheapTokens API 같은 OpenAI 호환 API의 모든 응답에서 usage 필드로 돌아오므로(2026년 10월 29일 확인), 추측할 필요가 없습니다.
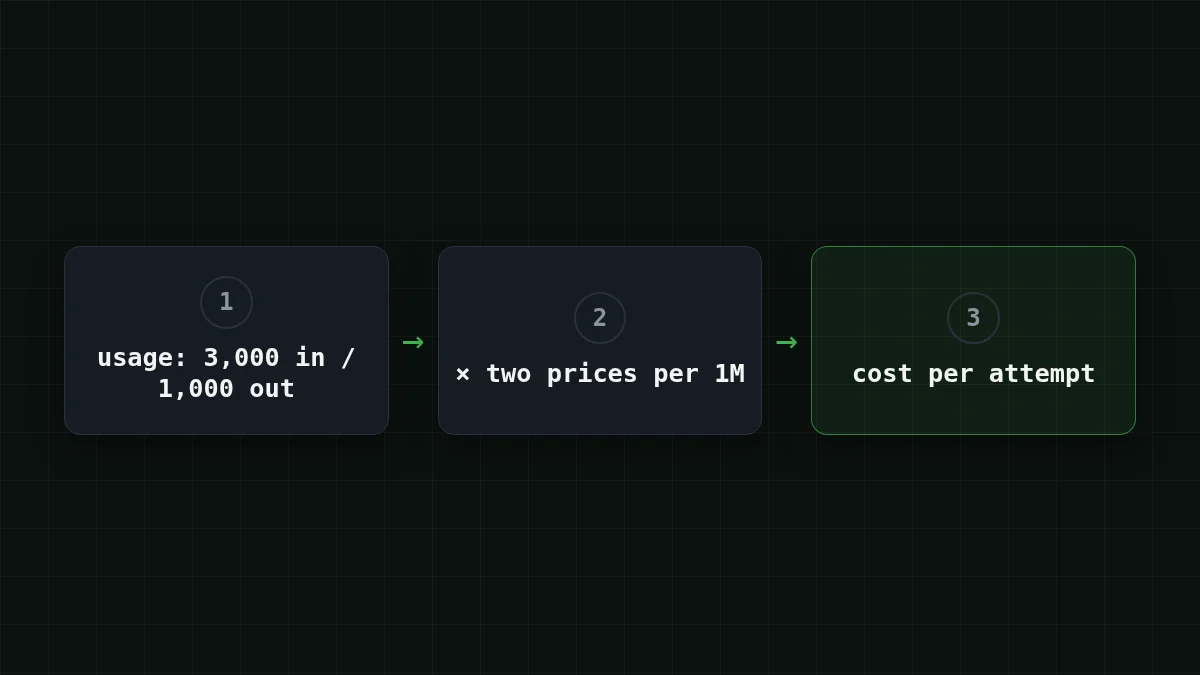
전체 공식은 다음과 같습니다.
cost per task = attempts × (tokens in × input price + tokens out × output price)작업이 3,000 토큰을 보내고 1,000 토큰을 돌려받는다고 가정합시다. 모델 A는 입력 1M 토큰당 $1, 출력 $5입니다. 모델 B는 그 절반인 $0.50과 $2.50입니다. (이것은 계산을 위한 임의의 반올림 가격이며, 누구의 가격표도 아닙니다.)
모델 A, 한 번 시도:
- 3,000 × $1 ÷ 1,000,000 = 입력 $0.003
- 1,000 × $5 ÷ 1,000,000 = 출력 $0.005
- $0.003 + $0.005 = 작업당 $0.008
모델 B가 싸 보입니다. 하지만 사용 가능한 결과를 얻는 데 세 번의 시도가 필요하고, 매 시도 비용이 같다고 가정합시다:
- 3,000 × $0.50 ÷ 1,000,000 = 입력 $0.0015
- 1,000 × $2.50 ÷ 1,000,000 = 출력 $0.0025
- $0.0015 + $0.0025 = 시도당 $0.004
- 3 × $0.004 = 작업당 $0.012
토큰당 가격은 절반인데 작업당 가격은 1.5배입니다. 재시도 없이 B가 단순히 더 긴 답변을 쓰는 경우에도 같은 일이 발생합니다. 한 번 시도에 3,000 출력 토큰이면 3,000 × $2.50 ÷ 1,000,000 = $0.0075이고, $0.0015 + $0.0075 = $0.009입니다. 여전히 A의 $0.008보다 많습니다.
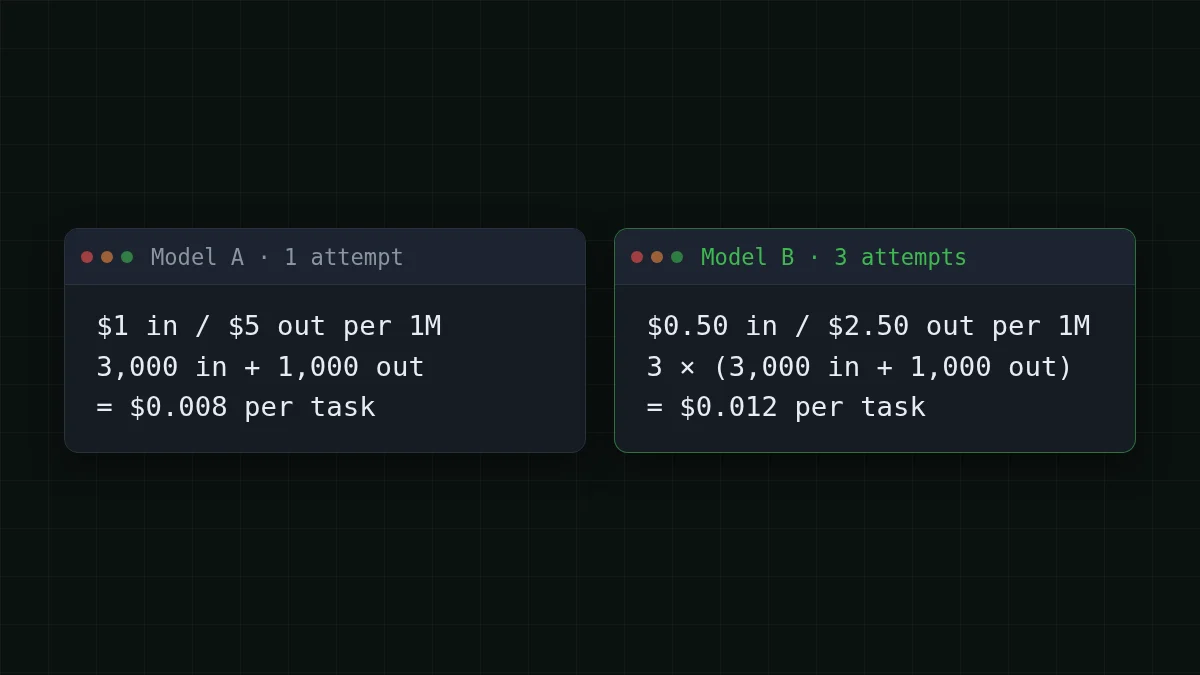
반대도 성립합니다. B가 첫 시도에 성공하면 작업당 $0.004로 A의 절반입니다. 토큰당 가격은 토큰 수와 시도 횟수가 비슷할 때만 승리합니다. 바로 이것을 확인해야 합니다.
플래시카드
모든 API 문서에서 만나게 될 용어
카드를 탭하여 뒤집기
작업당 토큰은 실제로 어디로 가는가#
토큰 수를 움직이는 세 가지가 있으며, 어느 것도 가격표에 나타나지 않습니다.
- 답변 길이. 길게 설명하는 모델은 한 줄로 답하는 모델보다 출력 토큰을 더 많이 씁니다.
- 재시도. 실패하거나 사용할 수 없는 답변도 토큰을 소모했고, 다음 시도는 다시 지불합니다.
- 재전송되는 컨텍스트. API는 기억하지 않습니다. 에이전트의 모든 단계는 지시, 파일, 기록을 다시 보냅니다. 이것이 처음이라면, 긴 채팅이 더 비싼 이유에서 메커니즘을 보여줍니다.
세 번째가 에이전트에게 가장 큰 문제입니다. 20단계로 작업하는 코딩 에이전트를 예로 들어봅시다. 무거운 에이전트 단계를 가정합니다. 입력 20,000 토큰, 출력 1,000 토큰입니다. 실제 단계별 숫자가 있는 더 가벼운 실행은 AI 에이전트가 왜 그렇게 많은 토큰을 쓰는가를 참고하세요. 답변은 짧습니다. 입력은 그렇지 않습니다.
숫자 맞히기
20단계 에이전트가 매 단계 20,000 토큰을 보낸다면 총 입력 토큰은 얼마인가?
내 추측
01,000,000
정답 보기
정답: 400,000
20 × 20,000 = 400,000. 매 단계가 컨텍스트를 다시 보내므로 각 답변이 짧아도 입력이 쌓입니다.
따라서 이 작업에서는 입력 쪽이 청구서를 결정하고 출력 쪽은 거의 중요하지 않습니다. 입력 가격이 저렴한 모델은 출력 가격이 평범해 보여도 여기서 이길 수 있습니다. 가격표는 자신의 작업을 염두에 두고 읽을 때만 이를 보여줍니다.
CheapTokens에서 사용 가능한 모델로 정확히 그 작업, 즉 20단계에 입력 20,000, 출력 1,000을 실행한 결과입니다. 표는 실시간이므로 숫자는 현재 가격을 따르며, OpenRouter 열은 비교를 위해 있습니다. 입력과 출력을 합산하면 세 모델 모두 총액에서 OpenRouter보다 저렴합니다.
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 20회 요청 | OpenRouter, 20회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
요청당 입력 20,000개 및 출력 1,000개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
이런 에이전트 루프에는 DeepSeek-V4-Flash가 자연스러운 선택입니다. 380K 컨텍스트, 답변당 최대 32,768 출력 토큰, 시간대와 관계없이 동일한 가격이므로 야간 실행도 주간과 같은 비용입니다. 이 모델에서 20단계 전체 작업은 $0.008입니다. 자세한 내용은 모델 페이지를, 모든 모델은 가격표를 참고하세요.
챗봇은 반대 이야기다#
이제 지원 봇을 예로 들어봅시다. 하루 1,000건의 요청을 받고, 각 요청은 컨텍스트를 포함한 2,000 토큰 질문과 500 토큰 답변입니다. 루프도 없고, 늘어나는 기록도 없고, 한 번의 시도입니다.
여기서는 토큰당 가격이 거의 작업당 비용입니다. 곱해지는 것이 없기 때문입니다. GLM-5.3-Flash에서 390K 컨텍스트와 답변당 최대 8,192 출력 토큰으로, 요청 한 건은 $0.00006이고 하루 1,000건 전체는 $0.06입니다.
따라서 경험칙은 간단합니다. 짧은 단발 작업: 토큰당 가격이 공정한 지침입니다. 루프, 재시도가 잦은 작업, 긴 답변 작업: 선택하기 전에 작업 전체의 가격을 계산하세요.
10분 만에 자신의 작업을 측정하라#
자신의 숫자가 여기 어떤 예시보다 낫습니다. 아래 스크립트는 요청 하나를 보내고 실제로 사용한 토큰과 그 비용을 출력합니다. 스크립트의 가격은 예시입니다. 가격표에서 현재 가격으로 바꾸세요.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
작동하면 한 줄에 세 숫자가 나옵니다. 입력 토큰, 출력 토큰, 해당 시도의 비용입니다. 그다음:
- 장난감 작업이 아닌 실제 작업 20개를 실행하세요.
- 버린 시도를 포함해 모든 시도의 비용을 합산하세요.
- 20으로 나누세요. 그것이 작업당 비용입니다.
- 다른 모델로 반복하고 두 결과를 비교하세요.
더 긴 실행에는 Python으로 에이전트 토큰 비용 추적하기가 같은 아이디어에 예산과 중단을 추가하고, 요청이 사용하는 토큰 수는 시작점으로 삼을 일반적인 크기를 보여줍니다.
빠른 확인#
빠른 확인
모델 B는 모델 A보다 토큰당 비용이 절반입니다. B가 완료된 작업당 더 비쌀 수 있는 경우는 언제인가?
정답 보기
정답: 더 많은 시도가 필요하거나 훨씬 긴 답변을 쓸 때
작업당 비용 = 시도 횟수 × 토큰 수 × 가격. 가격을 절반으로 줄이고 시도를 세 배로 늘리면 1.5배를 지불합니다.
다음으로, 입력 vs 출력 토큰은 두 쪽의 가격이 다른 이유를 설명하고, 문서는 키에서 첫 요청까지 안내합니다.


