AI 入门指南
每 1M token 价格 vs 每任务成本:如何比较 AI 模型
每 1M token 价格更低的模型,每个完成任务的成本仍然可能更高。学习如何根据输入 token、输出 token 和尝试次数计算每任务成本。
比较模型时,要看完成一个任务的实际成本,而不是每 1M token 的价格。一个任务的成本 = 输入 token 数 × 输入价格 + 输出 token 数 × 输出价格,再乘以尝试次数。所以,每 token 价格只有一半的模型,最终账单可能反而更高。
这就是常见的意外:agent 跑完了,价目表看着很便宜,账单却比这个任务应得的更高。我们来找出差异藏在哪里。
每 token 价格就像每公斤价格#
面粉每公斤的价格并不能告诉你一顿晚餐的成本。你需要知道菜谱要用几公斤,以及你是否会烧坏第一批然后重新开始。
AI 模型也是同样的道理。每 1M token 的价格就是每公斤的价格。任务就是那顿晚餐。每个请求都按两方面计费:你发送的 token(输入)和模型写回的 token(输出)。这两个数字都会出现在每个响应的 usage 字段中,例如 CheapTokens API(https:/,检查于 2026 年 10 月 29 日)这类 OpenAI 兼容 API 的响应,所以你永远不必猜测它们。
完整公式如下:
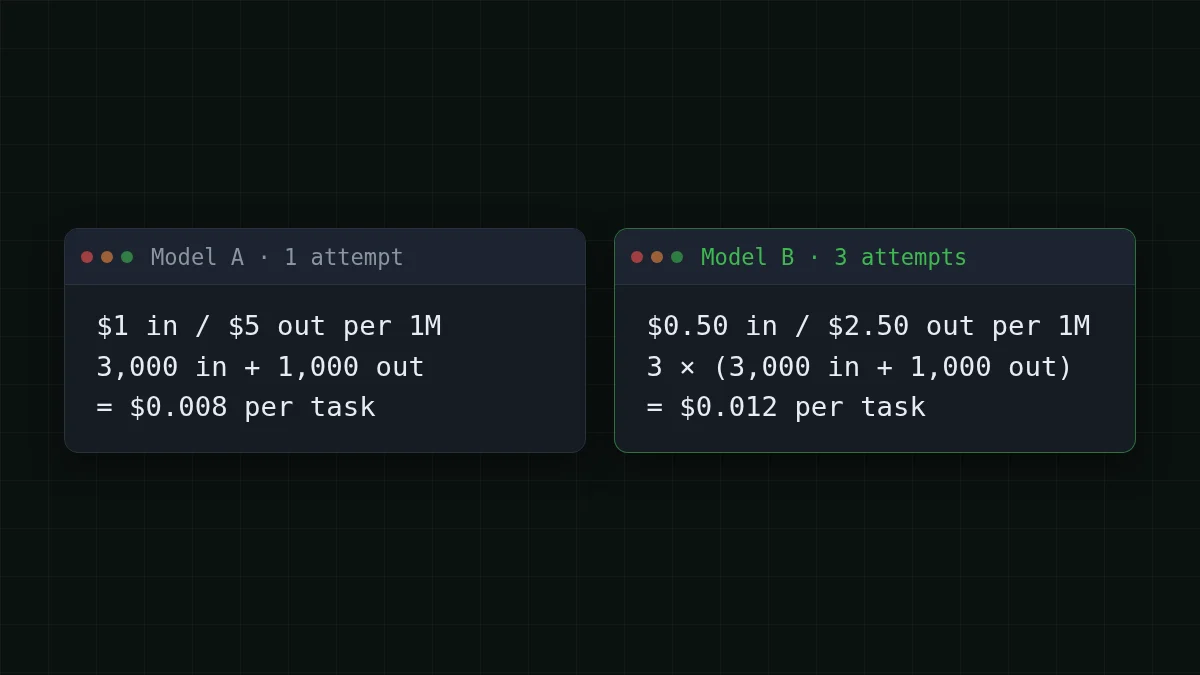
cost per task = attempts × (tokens in × input price + tokens out × output price)假设一个任务发送 3,000 个 token,收到 1,000 个。模型 A 的输入价格是每 1M token $1,输出价格是 $5。模型 B 是它的一半:$0.50 和 $2.50。(这些是为了计算而编的整数价格,不是任何人的价目表。)
模型 A,一次尝试:
- 3,000 × $1 ÷ 1,000,000 = 输入 $0.003
- 1,000 × $5 ÷ 1,000,000 = 输出 $0.005
- $0.003 + $0.005 = 每个任务 $0.008
模型 B 看起来更划算。但假设它需要三次尝试才能得到可用结果,而且每次尝试成本相同:
- 3,000 × $0.50 ÷ 1,000,000 = 输入 $0.0015
- 1,000 × $2.50 ÷ 1,000,000 = 输出 $0.0025
- $0.0015 + $0.0025 = 每次尝试 $0.004
- 3 × $0.004 = 每个任务 $0.012
每 token 价格减半,每任务价格却变成 1.5 倍。即使没有重试,只要 B 写出的答案更长,也会发生同样的情况:一次尝试输出 3,000 个 token,3,000 × $2.50 ÷ 1,000,000 = $0.0075,而 $0.0015 + $0.0075 = $0.009。仍然高于 A 的 $0.008。
反过来也成立。如果 B 第一次就做对了,它每个任务只花 $0.004,是 A 的一半。只有当 token 数量和尝试次数大致相同时,每 token 价格才占上风。而这正是需要检查的地方。
闪卡
每份 API 文档里都会遇到的词
点击卡片翻转
每任务的 token 到底花在哪里#
有三件事会改变 token 数量,而它们都不会出现在价目表上。
- 答案长度。 一个长篇解释自己的模型,会比一个一行回答的模型写出更多输出 token。
- 重试。 失败或不可用的答案仍然消耗了 token,下一次尝试还要再付一次。
- 重复发送的上下文。 API 不会记忆:agent 的每一步都会再次发送指令、文件和历史记录。如果这是新概念,为什么长聊天更贵 展示了其中的机制。
第三点对 agent 来说最重要。以一个分 20 步工作的编码 agent 为例。假设一个较重的 agent 步骤:输入 20,000 个 token,返回 1,000 个。关于更轻量的运行和真实的逐步数字,见 为什么 AI agent 使用这么多 token。答案很短,输入却不短。
猜数字
如果一个 20 步的 agent 每一步都发送 20,000 个 token,它总共发送多少输入 token?
你的猜测
01,000,000
显示答案
答案: 400,000
20 × 20,000 = 400,000。每一步都会重新发送上下文,所以即使每个答案都很短,输入也会不断累积。
所以对于这个任务,输入侧决定了账单,输出侧几乎无关紧要。一个输入价格便宜的模型在这里可以胜出,即使它的输出价格看起来一般。这一点,只有当你带着自己的任务去读价目表时才能看出来。
下面是这个确切任务——20 步,每步输入 20,000、输出 1,000——在 CheapTokens 可用模型上的情况。表格是实时的,所以数字会跟随当前价格,OpenRouter 列用于对比。把输入和输出加在一起,三者在总计上都比 OpenRouter 便宜。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 20 次请求 | OpenRouter,20 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
每次请求 20,000 个输入 token 和 1,000 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
对于这样的 agent 循环,DeepSeek-V4-Flash 是自然的选择:380K 上下文,每个答案最多 32,768 个输出 token,而且全天只有一个价格,所以夜间运行和白天运行成本相同。整个 20 步任务在它上面总共花费 $0.008。详情见模型页面,所有模型见价格表。
聊天机器人是相反的故事#
现在看一个支持机器人。假设它每天收到 1,000 个请求,每个请求是一个带上下文的 2,000 token 问题和一个 500 token 的答案。没有循环,没有不断增长的历史记录,只有一次尝试。
在这里,每 token 价格几乎就是每任务成本,因为没有任何东西会把它乘大。在 GLM-5.3-Flash 上,390K 上下文,每个答案最多 8,192 个输出 token,一个请求花费 $0.00006,一天 1,000 个请求总共花费 $0.06。
所以经验法则很简单。短小的单次任务:每 token 价格是合理的参考。循环、容易重试的任务或长答案任务:在选择之前先给整个任务定价。
十分钟内测量你自己的任务#
你自己的数字胜过这里的任何示例。下面的脚本发送一个请求,并打印它实际使用的 token 及其成本。其中的价格只是示例:请从价格表替换为当前价格。
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
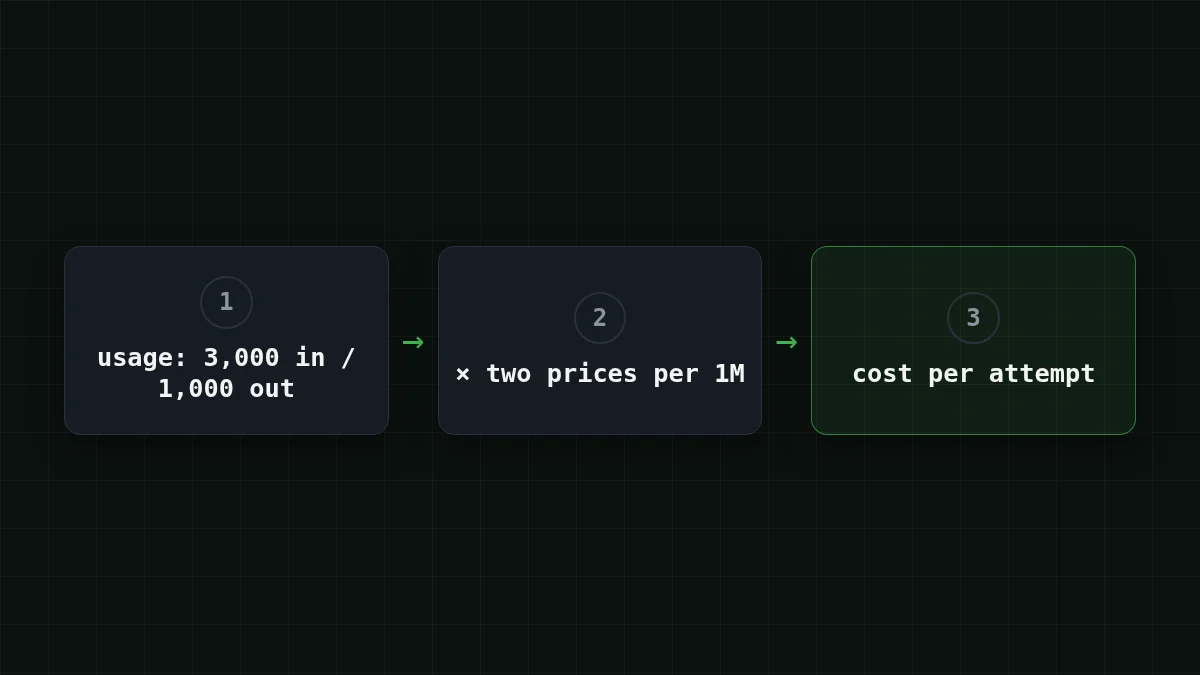
当它运行时,你会在一行中得到三个数字:输入 token、输出 token 和该次尝试的成本。然后:
- 运行 20 个你自己的真实任务,而不是玩具任务。
- 把每次尝试的成本加起来,包括你丢弃的那些。
- 除以 20。这就是你的每任务成本。
- 用另一个模型重复,并比较两个结果。
对于更长的运行,用 Python 跟踪 agent token 成本 在同样的思路上增加了预算和停止机制,而一个请求使用多少 token 展示了可以作为起点的典型规模。
快速检查#
快速检查
模型 B 的每 token 成本只有模型 A 的一半。什么时候 B 每个完成任务的成本仍然可能更高?
显示答案
答案: 当它需要更多尝试或写出长得多的答案时
每任务成本 = 尝试次数 × token 数 × 价格。价格减半,尝试次数变成三倍,你就要付 1.5 倍。
接下来,输入 vs 输出 token 解释了为什么两侧定价不同,而文档 会带你从密钥走到第一个请求。


