Presyo kada 1M token vs halaga kada gawain: paano ihambing ang mga AI model
Ang modelong may mas mababang presyo kada 1M token ay maaari pa ring mas mahal kada natapos na gawain. Matutunan kung paano kalkulahin ang halaga kada gawain mula sa tokens in, tokens out at mga pagtatangka.
Sa pahinang ito
Ihambing ang mga modelo sa halaga ng isang natapos na gawain, hindi sa presyo kada 1M token. Ang isang gawain ay nagkakahalaga ng tokens in × presyo ng input + tokens out × presyo ng output, na pinarami sa kung ilang pagtatangka ang kailangan. Kaya ang isang modelo na kalahati ang presyo kada token ay maaari pa ring magbigay sa iyo ng mas malaking bill.
Iyon ang karaniwang sorpresa: natapos ang agent, mukhang mura ang listahan ng presyo, at mas malaki ang invoice kaysa sa dapat na halaga ng gawain. Alamin natin kung saan nagtatago ang pagkakaiba.
Ang presyo kada token ay presyo kada kilo#
Ang presyo kada kilo ng harina ay walang sinasabi tungkol sa halaga ng hapunan. Kailangan mong malaman kung ilang kilo ang kailangan ng recipe, at kung masusunog mo ang unang batch at magsimula muli.
Ganito rin ang mga AI model. Ang presyo kada 1M token ay ang presyo kada kilo. Ang gawain ang hapunan. Bawat request ay sinisingil sa dalawang panig: ang mga token na ipinapadala mo (input) at ang mga token na isinusulat pabalik ng modelo (output). Bumalik ang parehong numero sa usage field ng bawat response mula sa OpenAI-compatible API tulad ng CheapTokens API sa https:/ (sinuri noong 29 Oktubre 2026), kaya hindi mo kailangang hulaan ang mga ito.
Narito ang buong formula:
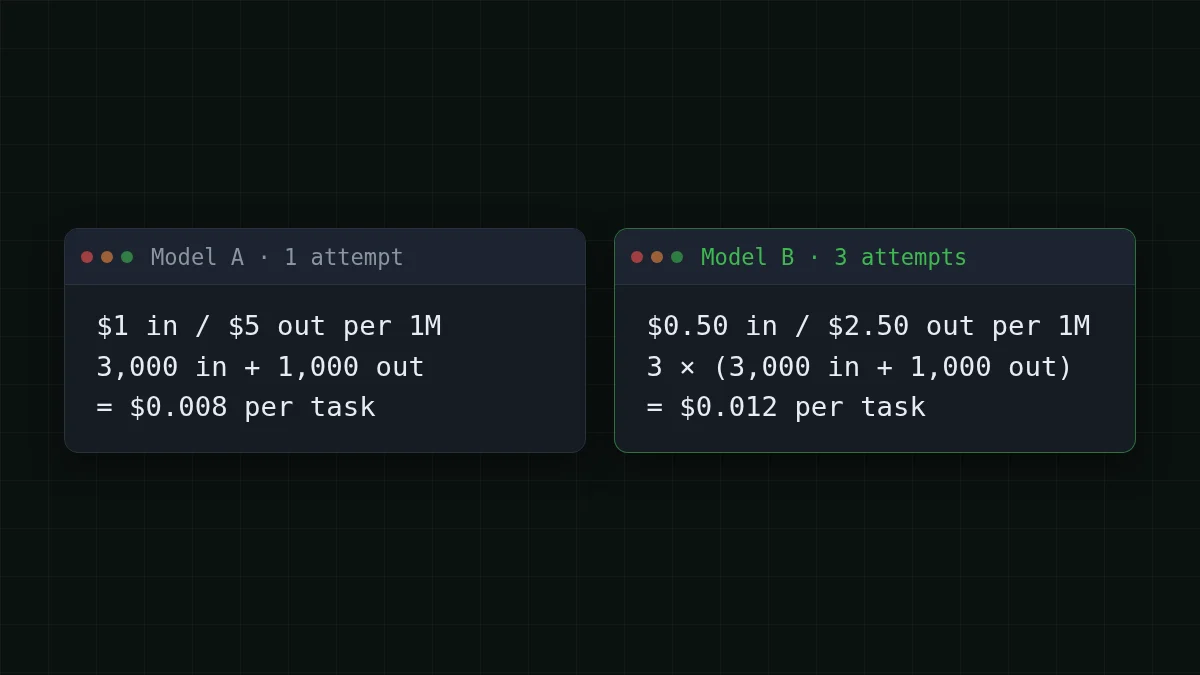
cost per task = attempts × (tokens in × input price + tokens out × output price)Sabihin nating ang isang gawain ay nagpapadala ng 3,000 token at nakakakuha ng 1,000 pabalik. Ang Model A ay nagkakahalaga ng $1 kada 1M token para sa input at $5 para sa output. Ang Model B ay kalahati niyon: $0.50 at $2.50. (Ito ay gawa-gawang bilog na presyo para sa halimbawa, hindi listahan ng presyo ng kahit sino.)
Model A, isang pagtatangka:
- 3,000 × $1 ÷ 1,000,000 = $0.003 para sa input
- 1,000 × $5 ÷ 1,000,000 = $0.005 para sa output
- $0.003 + $0.005 = $0.008 kada gawain
Mukhang bargain ang Model B. Pero sabihin nating kailangan nito ng tatlong subok para makakuha ng magagamit na resulta, at pareho ang halaga ng bawat subok:
- 3,000 × $0.50 ÷ 1,000,000 = $0.0015 para sa input
- 1,000 × $2.50 ÷ 1,000,000 = $0.0025 para sa output
- $0.0015 + $0.0025 = $0.004 kada pagtatangka
- 3 × $0.004 = $0.012 kada gawain
Kalahati ang presyo kada token, isa't kalahating beses ang presyo kada gawain. Nangyayari rin ang parehong bagay nang walang retry kung mas mahaba lang ang isinusulat ng B: na may 3,000 output token sa isang pagtatangka, 3,000 × $2.50 ÷ 1,000,000 = $0.0075, at $0.0015 + $0.0075 = $0.009. Mas mataas pa rin kaysa sa $0.008 ng A.
At totoo rin ang kabaligtaran. Kung makukuha ng B nang tama sa unang subok, nagkakahalaga ito ng $0.004 kada gawain, kalahati ng A. Nanalo ang presyo kada token kapag halos pantay ang bilang ng token at pagtatangka. Na siyang eksaktong bagay na dapat suriin.
Mga flashcard
Mga salitang makikita mo sa bawat API doc
I-tap ang card para i-flip ito
Saan talaga napupunta ang mga token kada gawain#
Tatlong bagay ang nagbabago ng bilang ng token, at wala sa mga ito ang lumalabas sa listahan ng presyo.
- Haba ng sagot. Ang modelong nagpapaliwanag nang mahaba ay nagsusulat ng mas maraming output token kaysa sa isang sumasagot sa isang linya.
- Mga retry. Ang nabigo o hindi magagamit na sagot ay may gastos pa ring token, at magbabayad muli sa susunod na subok.
- Muling ipinapadalang context. Hindi nagre-remember ang API: ipinapadala muli ng bawat hakbang ng agent ang mga instruksyon, mga file at history. Kung bago ito sa iyo, ipinapakita ng bakit mas mahal ang mahabang chat ang mekanismo.
Ang pangatlo ang pinakamalaki para sa mga agent. Kunin ang isang coding agent na gumagawa sa 20 hakbang. Ipagpalagay ang mabigat na hakbang ng agent: 20,000 token in at 1,000 pabalik. Para sa mas magaan na run na may totoong hakbang-hakbang na numero, tingnan ang bakit gumagamit ng napakaraming token ang mga AI agent. Maikli ang mga sagot. Hindi maikli ang input.
Hulaan ang numero
Ilang input token ang ipinapadala ng 20-hakbang na agent sa kabuuan, kung ang bawat hakbang ay nagpapadala ng 20,000?
Ang iyong hula
01,000,000
Ipakita ang sagot
Sagot: 400,000
20 × 20,000 = 400,000. Ipinapadala muli ng bawat hakbang ang context, kaya naiipon ang input kahit maikli ang bawat sagot.
Kaya para sa gawaing ito, ang panig ng input ang nagpapasya sa bill, at halos walang halaga ang panig ng output. Ang modelong may murang presyo ng input ay maaaring manalo dito kahit ordinaryo ang presyo ng output nito. Isang bagay na ipinapakita sa iyo ng listahan ng presyo kapag binasa mo ito nang may sariling gawain sa isip.
Narito ang eksaktong gawaing iyon, 20 hakbang na 20,000 in at 1,000 out, sa mga modelong available sa CheapTokens. Live ang table, kaya sumusunod ang mga numero sa kasalukuyang presyo, at naroon ang OpenRouter column para sa paghahambing. Kapag pinagsama ang input at output, mas mura ang tatlo kaysa sa OpenRouter sa kabuuan.
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 20 mga kahilingan | OpenRouter, 20 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20,000 input at 1,000 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Para sa mga agent loop na tulad nito, natural na tugma ang DeepSeek-V4-Flash: 380K context, hanggang 32,768 output token kada sagot, at isang presyo sa anumang oras ng araw, kaya pareho ang halaga ng night run at daytime run. Ang buong gawain sa lahat ng 20 hakbang dito ay nagkakahalaga ng $0.008. Tingnan ang pahina ng modelo para sa mga detalye at ang pricing table para sa bawat modelo.
Kabaligtaran ang kuwento ng chatbot#
Ngayon kunin ang isang support bot. Sabihin nating nakakatanggap ito ng 1,000 request kada araw, at ang bawat isa ay 2,000-token na tanong na may context at 500-token na sagot. Walang loop, walang history na lumalaki, isang pagtatangka.
Dito, ang presyo kada token ay halos ang halaga kada gawain, dahil walang nagpaparami nito. Sa GLM-5.3-Flash, na may 390K context at hanggang 8,192 output token kada sagot, ang isang request ay nagkakahalaga ng $0.00006 at ang buong araw ng 1,000 request ay nagkakahalaga ng $0.06.
Kaya simple ang rule of thumb. Maikli, single-shot na gawain: patas na gabay ang presyo kada token. Loop, gawaing madaling mag-retry o gawaing mahaba ang sagot: presyuhan ang buong gawain bago pumili.
Sukatin ang sarili mong gawain sa sampung minuto#
Mas mabuti ang sarili mong numero kaysa sa anumang halimbawa dito. Ang script sa ibaba ay nagpapadala ng isang request at nagpi-print kung ano talaga ang ginamit nito at magkano iyon. Halimbawa ang mga presyo sa loob nito: palitan ng kasalukuyang mga presyo mula sa pricing table.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
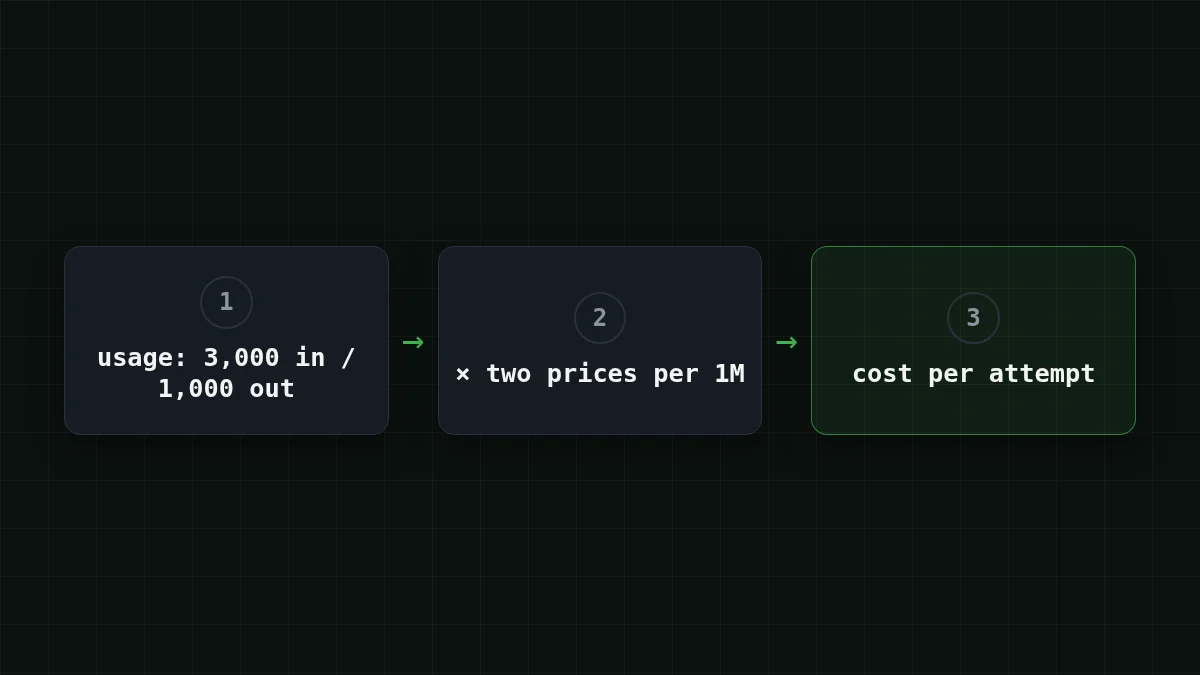
Kapag gumana ito, makakakuha ka ng tatlong numero sa isang linya: tokens in, tokens out at ang halaga ng pagtatangkang iyon. Pagkatapos:
- Magpatakbo ng 20 totoong gawain mo, hindi mga laruan.
- Pagsamahin ang halaga ng bawat pagtatangka, kasama ang mga itinapon mo.
- Hatiin sa 20. Iyon ang halaga mo kada gawain.
- Ulitin sa ibang modelo at ihambing ang dalawang resulta.
Para sa mas mahabang run, ang pagsubaybay sa token cost ng agent sa Python ay nagdadagdag ng budget at stop sa parehong ideya, at ipinapakita ng ilang token ang ginagamit ng isang request ang mga karaniwang sukat na pwedeng pagbatayan.
Mabilisang pagsusuri#
Mabilisang pagsusuri
Kalahati ang presyo ng Model B kada token kaysa sa Model A. Kailan pa rin mas mahal ang B kada natapos na gawain?
Ipakita ang sagot
Sagot: Kapag kailangan nito ng mas maraming pagtatangka o mas mahaba ang isinusulat na sagot
Halaga kada gawain = pagtatangka × token × presyo. Hatiin sa kalahati ang presyo, triplehin ang pagtatangka at magbabayad ka ng 1.5 beses.
Susunod, ipinapaliwanag ng input vs output tokens kung bakit magkaiba ang presyo ng dalawang panig, at dinadala ka ng docs mula sa key hanggang sa unang request.


