AI dla początkującychPrzewodnik
Cena za 1M tokenów vs koszt zadania: jak porównywać modele AI
Model z niższą ceną za 1M tokenów może wciąż kosztować więcej za ukończone zadanie. Naucz się liczyć koszt zadania z tokenów wejściowych, wyjściowych i prób.
Na tej stronie
Porównuj modele po koszcie ukończonego zadania, a nie po cenie za 1M tokenów. Koszt zadania to tokeny wejściowe × cena wejścia + tokeny wyjściowe × cena wyjścia, pomnożone przez liczbę prób, których wymaga. Model o połowę tańszy za token może więc wystawić ci wyższy rachunek.
To typowe zaskoczenie: agent skończył, cennik wyglądał tanio, a faktura jest większa, niż zadanie zasługiwało. Sprawdźmy, gdzie kryje się różnica.
Cena za token to cena za kilogram#
Cena za kilogram mąki nic nie mówi o koszcie obiadu. Musisz wiedzieć, ile kilogramów wymaga przepis i czy spalisz pierwszą partię i zaczniesz od nowa.
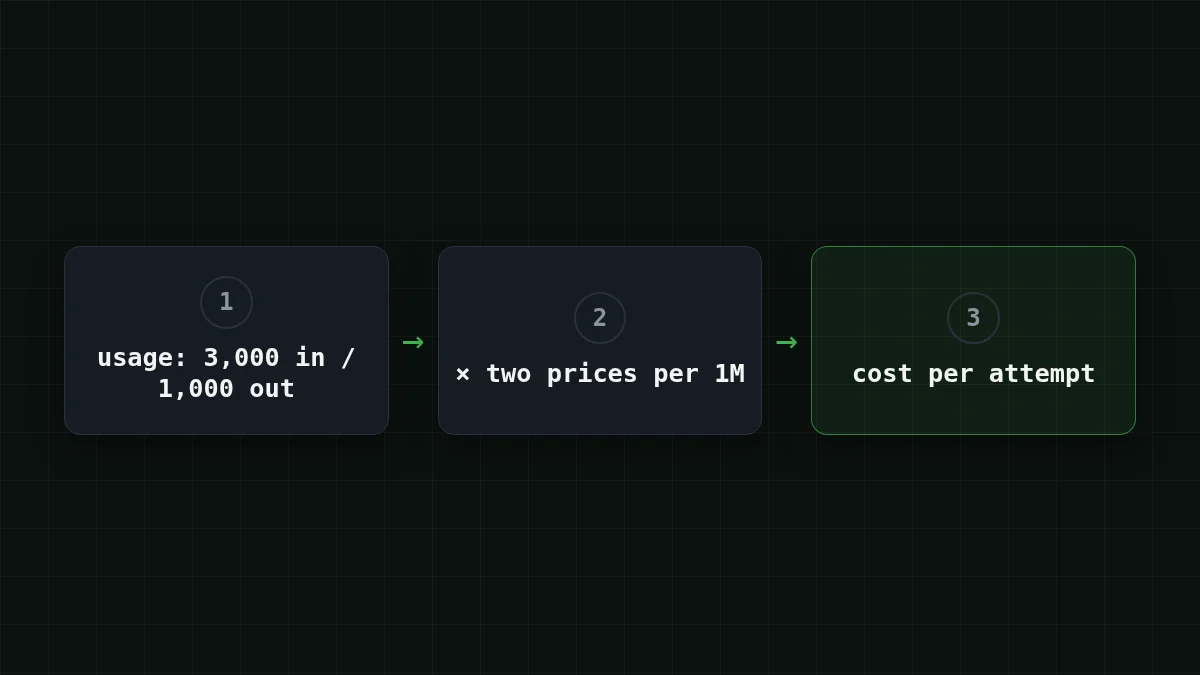
Modele AI działają tak samo. Cena za 1M tokenów to cena za kilogram. Zadanie to obiad. Każde zapytanie jest rozliczane po dwóch stronach: tokeny, które wysyłasz (wejście), i tokeny, które model odpisuje (wyjście). Obie liczby wracają w polu usage każdej odpowiedzi z API zgodnego z OpenAI, takiego jak API CheapTokens pod https:/ (sprawdzone 29 października 2026), więc nigdy nie musisz ich zgadywać.
Oto cały wzór:
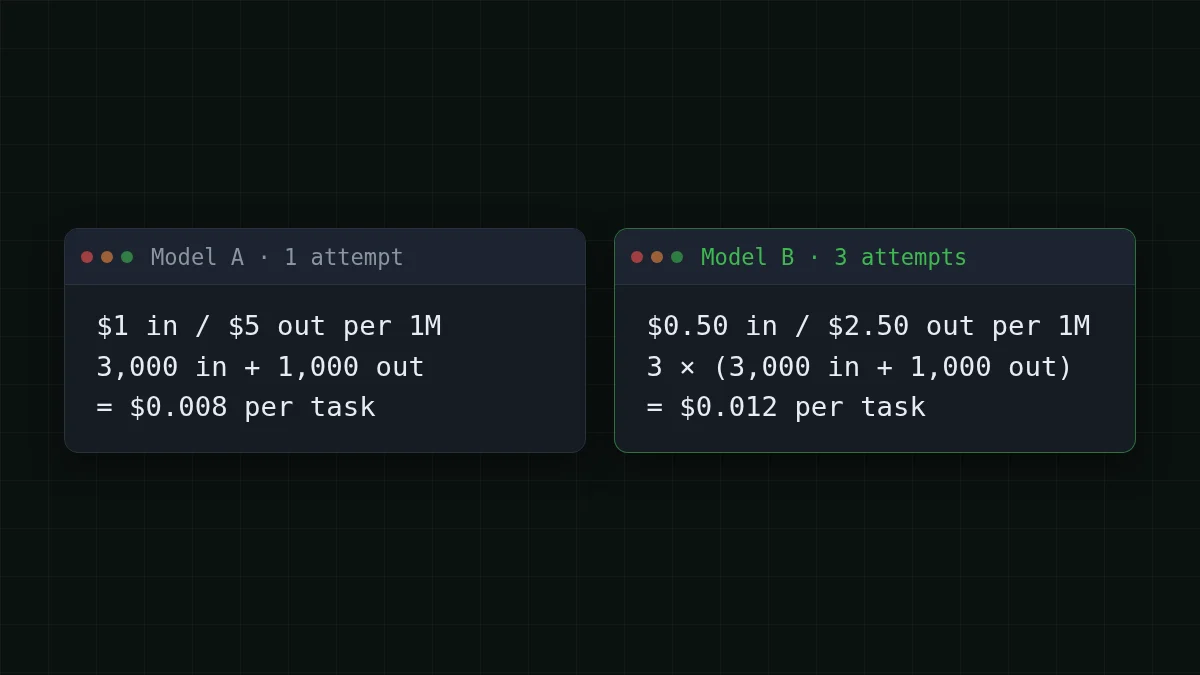
cost per task = attempts × (tokens in × input price + tokens out × output price)Załóżmy, że zadanie wysyła 3 000 tokenów i dostaje 1 000 z powrotem. Model A kosztuje $1 za 1M tokenów wejścia i $5 za wyjście. Model B jest o połowę tańszy: $0,50 i $2,50. (To wymyślone okrągłe ceny do obliczeń, nie czyjś cennik.)
Model A, jedna próba:
- 3 000 × $1 ÷ 1 000 000 = $0,003 za wejście
- 1 000 × $5 ÷ 1 000 000 = $0,005 za wyjście
- $0,003 + $0,005 = $0,008 za zadanie
Model B wygląda na okazję. Ale załóżmy, że potrzebuje trzech prób, by dać użyteczny wynik, a każda próba kosztuje tyle samo:
- 3 000 × $0,50 ÷ 1 000 000 = $0,0015 za wejście
- 1 000 × $2,50 ÷ 1 000 000 = $0,0025 za wyjście
- $0,0015 + $0,0025 = $0,004 za próbę
- 3 × $0,004 = $0,012 za zadanie
Połowa ceny za token, półtora raza wyższa cena za zadanie. To samo dzieje się bez ponownych prób, jeśli B po prostu pisze dłuższe odpowiedzi: przy 3 000 tokenów wyjściowych w jednej próbie 3 000 × $2,50 ÷ 1 000 000 = $0,0075, a $0,0015 + $0,0075 = $0,009. Wciąż więcej niż $0,008 u A.
I odwrotnie też bywa. Jeśli B za pierwszym razem trafi, kosztuje $0,004 za zadanie, czyli połowę A. Cena za token wygrywa tylko wtedy, gdy liczba tokenów i prób jest mniej więcej równa. I to jest dokładnie to, co trzeba sprawdzić.
Fiszki
Pojęcia, które spotkasz w każdej dokumentacji API
Dotknij kartę, aby ją odwrócić
Gdzie faktycznie idą tokeny na zadanie#
Trzy rzeczy zmieniają liczbę tokenów i żadna z nich nie pojawia się w cenniku.
- Długość odpowiedzi. Model, który się rozwodzi, pisze więcej tokenów wyjściowych niż ten, który odpowiada jednym zdaniem.
- Ponowne próby. Nieudana lub bezużyteczna odpowiedź też kosztowała tokeny, a następna próba płaci ponownie.
- Ponownie wysyłany kontekst. API nie pamięta: każdy krok agenta wysyła ponownie instrukcje, pliki i historię. Jeśli to dla ciebie nowość, dlaczego długi czat kosztuje więcej pokazuje mechanizm.
Trzecia rzecz jest najważniejsza dla agentów. Weź agenta kodującego, który pracuje w 20 krokach. Załóżmy ciężki krok agenta: 20 000 tokenów wejścia i 1 000 z powrotem. Lżejszy przebieg z rzeczywistymi liczbami krok po kroku znajdziesz w dlaczego agenci AI zużywają tak wiele tokenów. Odpowiedzi są krótkie. Wejście nie.
Zgadnij liczbę
Ile tokenów wejściowych wysyła łącznie agent w 20 krokach, jeśli każdy krok wysyła 20 000?
Twoje przypuszczenie
01 000 000
Pokaż odpowiedź
Odpowiedź: 400 000
20 × 20 000 = 400 000. Każdy krok ponownie wysyła kontekst, więc wejście się kumuluje, mimo że każda odpowiedź jest krótka.
Więc w tym zadaniu o rachunku decyduje strona wejściowa, a strona wyjściowa prawie nie ma znaczenia. Model z tanią ceną wejścia może tu wygrać, nawet jeśli jego cena wyjścia wygląda zwyczajnie. Cennik pokaże ci to tylko wtedy, gdy czytasz go z własnym zadaniem w głowie.
Oto dokładnie to zadanie, 20 kroków po 20 000 wejścia i 1 000 wyjścia, na modelach dostępnych w CheapTokens. Tabela jest aktualizowana na żywo, więc liczby podążają za bieżącymi cenami, a kolumna OpenRouter jest dla porównania. Licząc wejście i wyjście razem, wszystkie trzy są tańsze niż OpenRouter łącznie.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 20 żądań | OpenRouter, 20 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20 000 tokenów wejściowych i 1000 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Do takich pętli agentowych DeepSeek-V4-Flash pasuje naturalnie: kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź i jedna cena o każdej porze dnia, więc nocny przebieg kosztuje tyle samo co dzienny. Całe zadanie we wszystkich 20 krokach na nim kosztuje $0.008. Szczegóły znajdziesz na stronie modelu, a każdy model w tabeli cen.
Chatbot to odwrotna historia#
Weź teraz bota wsparcia. Załóżmy, że dostaje 1 000 zapytań dziennie, a każde to pytanie z kontekstem o 2 000 tokenów i odpowiedź o 500 tokenów. Bez pętli, bez rosnącej historii, jedna próba.
Tutaj cena za token to niemal koszt zadania, bo nic jej nie mnoży. Na GLM-5.3-Flash, z kontekstem 390K i do 8 192 tokenów wyjściowych na odpowiedź, jedno zapytanie kosztuje $0.00006, a cały dzień 1 000 zapytań kosztuje $0.06.
Zasada kciuka jest więc prosta. Krótkie zadanie jednorazowe: cena za token to uczciwy wskaźnik. Pętla, zadanie podatne na ponowne próby albo zadanie z długą odpowiedzią: wyceń całe zadanie, zanim wybierzesz.
Zmierz własne zadanie w dziesięć minut#
Twoje własne liczby biją każdy przykład tutaj. Poniższy skrypt wysyła jedno zapytanie i wypisuje, ile faktycznie zużył i ile to kosztuje. Ceny w nim są przykładowe: podstaw aktualne z tabeli cen.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Gdy zadziała, dostaniesz trzy liczby w jednej linii: tokeny wejściowe, tokeny wyjściowe i koszt tej próby. Potem:
- Uruchom 20 swoich prawdziwych zadań, nie zabawkowych.
- Zsumuj koszt każdej próby, także tych odrzuconych.
- Podziel przez 20. To twój koszt za zadanie.
- Powtórz z innym modelem i porównaj oba wyniki.
Przy dłuższym przebiegu śledzenie kosztu tokenów agenta w Pythonie dodaje budżet i zatrzymanie do tej samej idei, a ile tokenów zużywa zapytanie pokazuje typowe rozmiary na start.
Szybkie sprawdzenie#
Szybkie sprawdzenie
Model B kosztuje o połowę mniej za token niż model A. Kiedy B może wciąż kosztować więcej za ukończone zadanie?
Pokaż odpowiedź
Odpowiedź: Gdy potrzebuje więcej prób albo pisze znacznie dłuższe odpowiedzi
Koszt za zadanie = próby × tokeny × cena. Zmniejsz cenę o połowę, potroić próby i płacisz 1,5 raza więcej.
Dalej tokeny wejściowe vs wyjściowe wyjaśniają, dlaczego obie strony mają różne ceny, a dokumentacja prowadzi cię od klucza do pierwszego zapytania.


