Precio por 1M de tokens vs coste por tarea: cómo comparar modelos de IA
Un modelo con un precio por 1M de tokens más bajo puede seguir costando más por tarea terminada. Aprende a calcular el coste por tarea a partir de tokens de entrada, tokens de salida e intentos.
En esta página
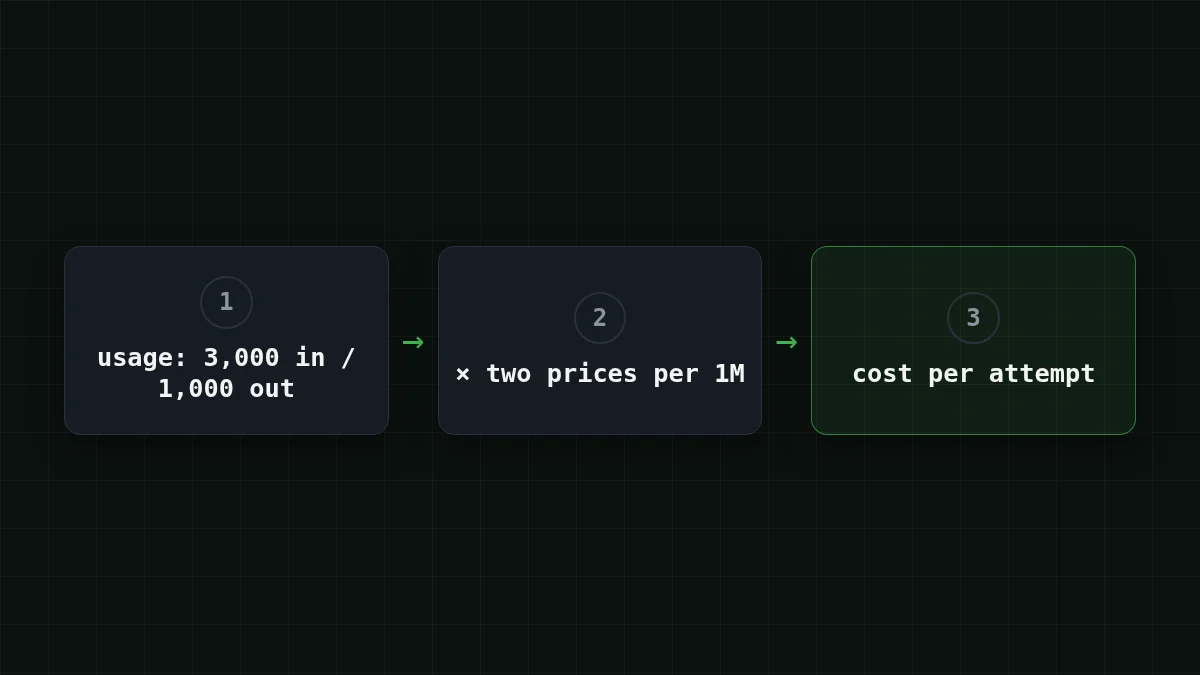
Compara modelos por lo que cuesta una tarea terminada, no por el precio por 1M de tokens. Una tarea cuesta tokens de entrada × precio de entrada + tokens de salida × precio de salida, multiplicado por el número de intentos que haga falta. Así que un modelo a la mitad de precio por token puede acabar dándote la factura más grande.
Esa es la sorpresa habitual: el agente terminó, la lista de precios parecía barata y la factura es mayor de lo que la tarea merecía. Vamos a ver dónde se esconde la diferencia.
Un precio por token es un precio por kilo#
Un precio por kilo de harina no te dice nada sobre el coste de la cena. Necesitas saber cuántos kilos lleva la receta y si quemas la primera tanda y empiezas de nuevo.
Los modelos de IA funcionan igual. El precio por 1M de tokens es el precio por kilo. La tarea es la cena. Cada petición se factura por dos lados: los tokens que envías (entrada) y los tokens que el modelo escribe de vuelta (salida). Ambos números vuelven en el campo usage de cada respuesta de una API compatible con OpenAI, como la API de CheapTokens en https:/ (comprobado el 29 de octubre de 2026), así que nunca tienes que adivinarlos.
Esta es la fórmula completa:
cost per task = attempts × (tokens in × input price + tokens out × output price)Digamos que una tarea envía 3.000 tokens y recibe 1.000 de vuelta. El modelo A cuesta $1 por 1M de tokens de entrada y $5 de salida. El modelo B cuesta la mitad: $0,50 y $2,50. (Son precios redondos inventados para la suma, no la lista de precios de nadie.)
Modelo A, un intento:
- 3.000 × $1 ÷ 1.000.000 = $0,003 de entrada
- 1.000 × $5 ÷ 1.000.000 = $0,005 de salida
- $0,003 + $0,005 = $0,008 por tarea
El modelo B parece la ganga. Pero digamos que necesita tres intentos para dar un resultado usable, y cada intento cuesta lo mismo:
- 3.000 × $0,50 ÷ 1.000.000 = $0,0015 de entrada
- 1.000 × $2,50 ÷ 1.000.000 = $0,0025 de salida
- $0,0015 + $0,0025 = $0,004 por intento
- 3 × $0,004 = $0,012 por tarea
La mitad de precio por token, una vez y media el precio por tarea. Lo mismo pasa sin reintentos si B simplemente escribe respuestas más largas: con 3.000 tokens de salida en un intento, 3.000 × $2,50 ÷ 1.000.000 = $0,0075, y $0,0015 + $0,0075 = $0,009. Sigue siendo más que los $0,008 de A.
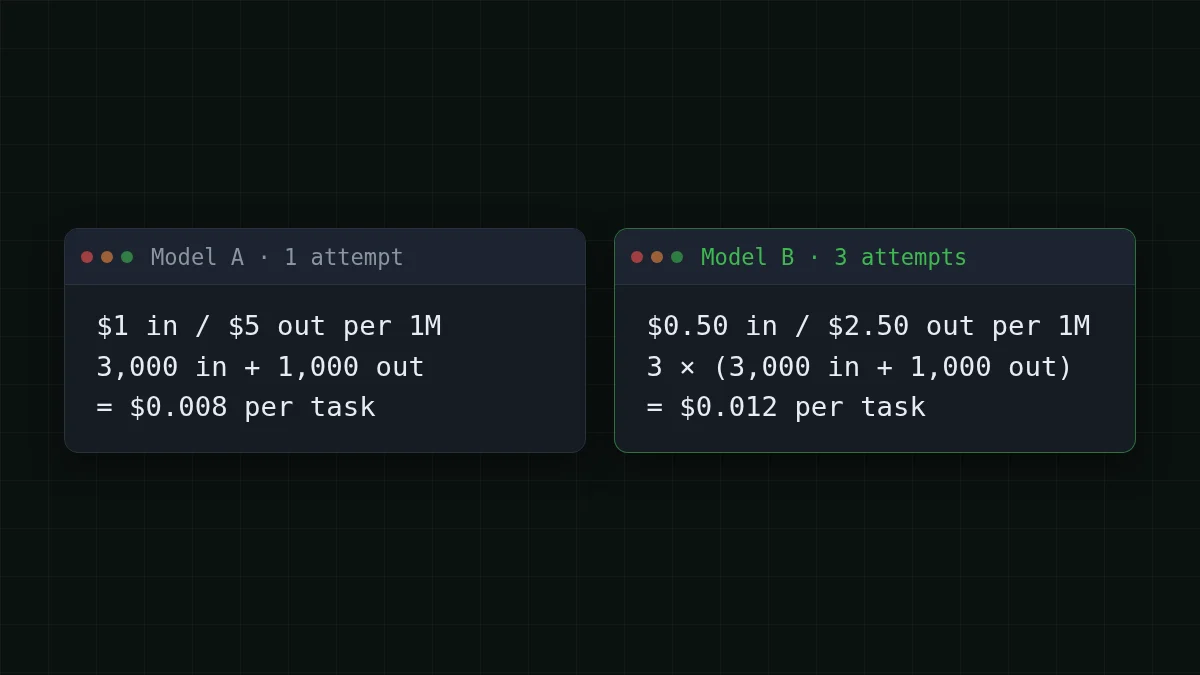
Y lo contrario también se cumple. Si B acierta a la primera, cuesta $0,004 por tarea, la mitad que A. El precio por token solo gana cuando el número de tokens e intentos es más o menos igual. Que es justo lo que hay que comprobar.
Tarjetas de memoria
Palabras que verás en toda documentación de API
Toca una tarjeta para voltearla
A dónde van realmente los tokens por tarea#
Tres cosas mueven el recuento de tokens, y ninguna aparece en una lista de precios.
- Longitud de la respuesta. Un modelo que se explica largo escribe más tokens de salida que uno que responde en una línea.
- Reintentos. Una respuesta fallida o inutilizable igualmente costó tokens, y el siguiente intento vuelve a pagar.
- Contexto reenviado. Una API no recuerda: cada paso de un agente vuelve a enviar las instrucciones, los archivos y el historial. Si esto es nuevo para ti, por qué un chat largo cuesta más muestra el mecanismo.
La tercera es la grande para los agentes. Toma un agente de programación que trabaja en 20 pasos. Supón un paso de agente pesado: 20.000 tokens de entrada y 1.000 de vuelta. Para una ejecución más ligera con números reales paso a paso, mira por qué los agentes de IA usan tantos tokens. Las respuestas son cortas. La entrada no.
Adivina el número
¿Cuántos tokens de entrada envía en total un agente de 20 pasos, si cada paso envía 20.000?
Tu respuesta
01.000.000
Mostrar respuesta
Respuesta: 400.000
20 × 20.000 = 400.000. Cada paso reenvía el contexto, así que la entrada se acumula aunque cada respuesta sea corta.
Así que para este trabajo el lado de la entrada decide la factura, y el lado de la salida apenas importa. Un modelo con un precio de entrada barato puede ganar aquí aunque su precio de salida parezca normal. Eso es algo que una lista de precios solo te muestra cuando la lees pensando en tu propia tarea.
Aquí está ese trabajo exacto, 20 pasos de 20.000 de entrada y 1.000 de salida, con los modelos disponibles en CheapTokens. La tabla está en vivo, así que los números siguen los precios actuales, y la columna de OpenRouter está ahí para comparar. Contando entrada y salida juntas, los tres son más baratos que OpenRouter en total.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 20 solicitudes | OpenRouter, 20 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20.000 tokens de entrada y 1000 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Para bucles de agente como este, DeepSeek-V4-Flash encaja de forma natural: 380K de contexto, hasta 32.768 tokens de salida por respuesta y un único precio a cualquier hora del día, así que una ejecución nocturna cuesta lo mismo que una diurna. El trabajo completo en los 20 pasos con él sale por $0.008. Consulta la página del modelo para más detalles y la tabla de precios para todos los modelos.
Un chatbot es la historia contraria#
Ahora toma un bot de soporte. Digamos que recibe 1.000 peticiones al día, y cada una es una pregunta de 2.000 tokens con contexto y una respuesta de 500 tokens. Sin bucle, sin historial que crezca, un intento.
Aquí el precio por token es casi el coste por tarea, porque nada lo multiplica. En GLM-5.3-Flash, con 390K de contexto y hasta 8.192 tokens de salida por respuesta, una petición cuesta $0.00006 y el día entero de 1.000 peticiones cuesta $0.06.
Así que la regla general es sencilla. Una tarea corta de un solo disparo: el precio por token es una guía justa. Un bucle, un trabajo propenso a reintentos o un trabajo de respuestas largas: calcula el precio de una tarea completa antes de elegir.
Mide tu propia tarea en diez minutos#
Tus propios números superan a cualquier ejemplo de aquí. El script de abajo envía una petición e imprime lo que realmente usó y lo que cuesta. Los precios que contiene son un ejemplo: sustituye los actuales de la tabla de precios.
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
Cuando funciona obtienes tres números en una línea: tokens de entrada, tokens de salida y el coste de ese intento. Después:
- Ejecuta 20 tareas reales tuyas, no de juguete.
- Suma el coste de cada intento, incluidos los que descartaste.
- Divide entre 20. Ese es tu coste por tarea.
- Repite con el otro modelo y compara los dos resultados.
Para una ejecución más larga, seguir el coste de tokens de un agente en Python añade un presupuesto y una parada a la misma idea, y cuántos tokens usa una petición muestra tamaños típicos por los que empezar.
Comprobación rápida#
Verificación rápida
El modelo B cuesta la mitad por token que el modelo A. ¿Cuándo puede B seguir costando más por tarea terminada?
Mostrar respuesta
Respuesta: Cuando necesita más intentos o escribe respuestas mucho más largas
Coste por tarea = intentos × tokens × precio. Divide el precio a la mitad, triplica los intentos y pagas 1,5 veces más.
A continuación, tokens de entrada vs salida explica por qué los dos lados tienen precios distintos, y la documentación te lleva de una clave a una primera petición.


