AI สำหรับผู้เริ่มต้นคู่มือ
ราคาต่อ 1M โทเคนกับต้นทุนต่องาน: วิธีเปรียบเทียบโมเดล AI
โมเดลที่มีราคาต่อ 1M โทเคนต่ำกว่าก็ยังมีต้นทุนต่องานที่เสร็จแล้วสูงกว่าได้ เรียนรู้การคำนวณต้นทุนต่องานจากโทเคนขาเข้า โทเคนขาออก และจำนวนครั้งที่ลอง
ในหน้านี้
เปรียบเทียบโมเดลจากต้นทุนของงานที่เสร็จแล้ว ไม่ใช่จากราคาต่อ 1M โทเคน ต้นทุนของงานคำนวณจากโทเคนขาเข้า × ราคาอินพุต + โทเคนขาออก × ราคาเอาต์พุต คูณด้วยจำนวนครั้งที่ต้องลอง ดังนั้นโมเดลที่มีราคาต่อโทเคนถูกกว่าครึ่งหนึ่งก็ยังอาจทำให้คุณจ่ายบิลที่สูงกว่าได้
นี่คือเรื่องเซอร์ไพรส์ที่เจอบ่อย: agent ทำงานเสร็จแล้ว ดูรายการราคาก็ถูกดี แต่ใบเรียกเก็บเงินกลับสูงเกินกว่าที่งานนั้นควรเป็น มาดูกันว่าความต่างซ่อนอยู่ตรงไหน
ราคาต่อโทเคนก็คือราคาต่อกิโล#
ราคาแป้งต่อกิโลไม่ได้บอกอะไรเกี่ยวกับต้นทุนของมื้ออาหาร คุณต้องรู้ว่าสูตรใช้แป้งกี่กิโล และต้องเผาทิ้งรอบแรกแล้วเริ่มใหม่หรือเปล่า
โมเดล AI ก็ทำงานแบบเดียวกัน ราคาต่อ 1M โทเคนคือราคาต่อกิโล ส่วนงานคือมื้ออาหาร ทุกคำขอถูกคิดเงินสองด้าน: โทเคนที่คุณส่งไป (อินพุต) และโทเคนที่โมเดลเขียนกลับมา (เอาต์พุต) ตัวเลขทั้งสองจะกลับมาในฟิลด์ usage ของทุกการตอบกลับจาก API ที่เข้ากันได้กับ OpenAI เช่น CheapTokens API ที่ https:/ (ตรวจสอบเมื่อ 29 ตุลาคม 2026) คุณจึงไม่ต้องเดาเลย
นี่คือสูตรทั้งหมด:
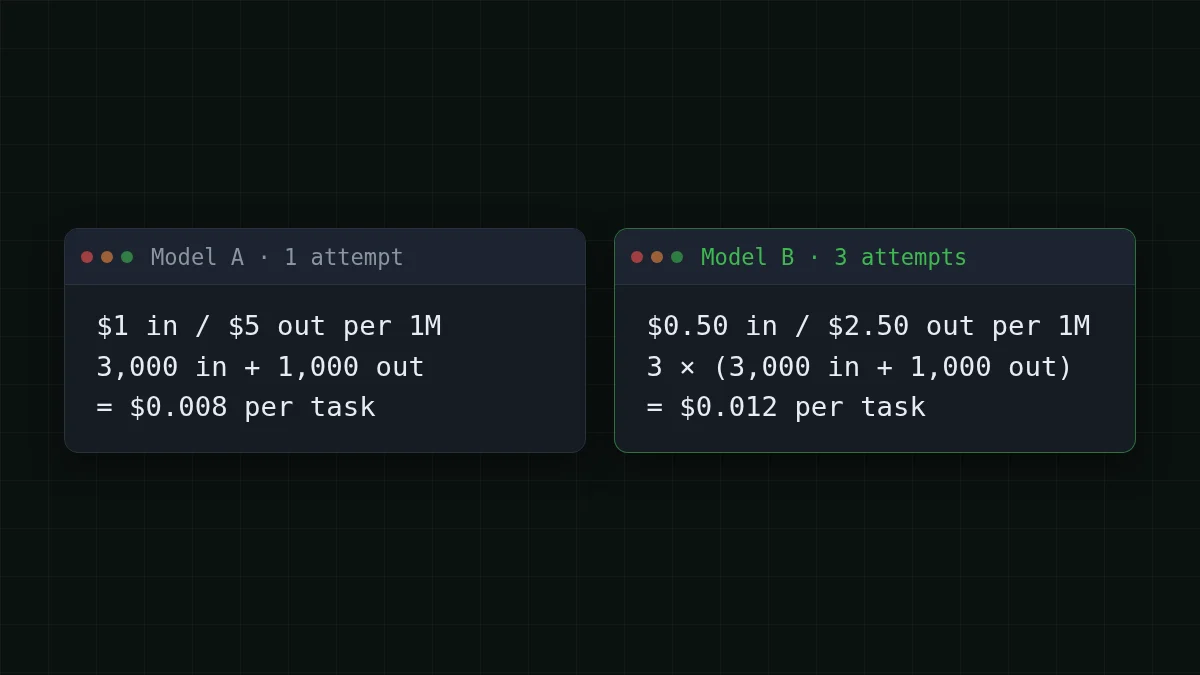
cost per task = attempts × (tokens in × input price + tokens out × output price)สมมติว่างานหนึ่งส่ง 3,000 โทเคนและได้กลับมา 1,000 โทเคน โมเดล A ราคา $1 ต่อ 1M โทเคนสำหรับอินพุต และ $5 สำหรับเอาต์พุต โมเดล B ถูกกว่าครึ่ง: $0.50 และ $2.50 (นี่เป็นราคาสมมติแบบกลมๆ สำหรับการคำนวณ ไม่ใช่รายการราคาของใคร)
โมเดล A ลองหนึ่งครั้ง:
- 3,000 × $1 ÷ 1,000,000 = $0.003 สำหรับอินพุต
- 1,000 × $5 ÷ 1,000,000 = $0.005 สำหรับเอาต์พุต
- $0.003 + $0.005 = $0.008 ต่องาน
โมเดล B ดูเหมือนจะคุ้มกว่า แต่สมมติว่าต้องลองสามครั้งถึงจะได้ผลลัพธ์ที่ใช้งานได้ และแต่ละครั้งมีต้นทุนเท่ากัน:
- 3,000 × $0.50 ÷ 1,000,000 = $0.0015 สำหรับอินพุต
- 1,000 × $2.50 ÷ 1,000,000 = $0.0025 สำหรับเอาต์พุต
- $0.0015 + $0.0025 = $0.004 ต่อครั้ง
- 3 × $0.004 = $0.012 ต่องาน
ราคาต่อโทเคนถูกกว่าครึ่ง แต่ราคาต่องานสูงกว่าหนึ่งเท่าครึ่ง เรื่องเดียวกันนี้เกิดขึ้นได้แม้ไม่มีการลองใหม่ ถ้า B เขียนคำตอบยาวกว่า: ด้วย 3,000 โทเคนเอาต์พุตในการลองครั้งเดียว 3,000 × $2.50 ÷ 1,000,000 = $0.0075 และ $0.0015 + $0.0075 = $0.009 ก็ยังมากกว่า $0.008 ของ A
และกลับกันก็เป็นจริงเช่นกัน ถ้า B ทำถูกตั้งแต่ครั้งแรก จะมีต้นทุน $0.004 ต่องาน ซึ่งเป็นครึ่งหนึ่งของ A ราคาต่อโทเคนจะชนะก็ต่อเมื่อจำนวนโทเคนและจำนวนครั้งใกล้เคียงกัน ซึ่งนั่นแหละคือสิ่งที่ต้องตรวจสอบ
แฟลชการ์ด
คำศัพท์ที่เจอในเอกสาร API ทุกฉบับ
แตะการ์ดเพื่อพลิก
โทเคนต่องานไปอยู่ที่ไหนจริงๆ#
มีสามสิ่งที่มีผลต่อจำนวนโทเคน และไม่มีสิ่งใดปรากฏในรายการราคาเลย
- ความยาวของคำตอบ โมเดลที่อธิบายตัวเองยาวๆ จะเขียนโทเคนเอาต์พุตมากกว่าโมเดลที่ตอบสั้นๆ บรรทัดเดียว
- การลองใหม่ คำตอบที่ล้มเหลวหรือใช้งานไม่ได้ก็ยังเสียโทเคนไปแล้ว และการลองครั้งถัดไปก็จ่ายอีกครั้ง
- บริบทที่ส่งซ้ำ API ไม่มีความจำ: ทุกขั้นตอนของ agent จะส่งคำสั่ง ไฟล์ และประวัติซ้ำอีกครั้ง ถ้าเรื่องนี้ยังใหม่สำหรับคุณ ทำไมแชทยาวถึงมีต้นทุนสูงขึ้น อธิบายกลไกไว้
ข้อที่สามคือเรื่องใหญ่สำหรับ agent ลองดู coding agent ที่ทำงาน 20 ขั้นตอน สมมติว่าแต่ละขั้นหนักๆ: 20,000 โทเคนขาเข้าและได้กลับมา 1,000 สำหรับการรันที่เบากว่าพร้อมตัวเลขจริงทีละขั้น ดู ทำไม AI agent ใช้โทเคนมากมาย คำตอบนั้นสั้น แต่ขาเข้าไม่สั้น
ทายตัวเลข
agent ที่ทำงาน 20 ขั้นตอนส่งโทเคนอินพุตรวมทั้งหมดเท่าไร ถ้าแต่ละขั้นส่ง 20,000?
คำตอบของคุณ
01,000,000
แสดงคำตอบ
คำตอบ: 400,000
20 × 20,000 = 400,000 ทุกขั้นส่งบริบทซ้ำ อินพุตจึงพอกพูนขึ้นแม้ว่าคำตอบแต่ละอันจะสั้น
ดังนั้นสำหรับงานนี้ ฝั่งอินพุตเป็นตัวตัดสินบิล และฝั่งเอาต์พุตแทบไม่มีผล โมเดลที่มีราคาอินพุตถูกสามารถชนะได้ตรงนี้แม้ว่าราคาเอาต์พุตจะดูธรรมดา นั่นคือสิ่งที่รายการราคาแสดงให้คุณเห็นก็ต่อเมื่อคุณอ่านมันโดยคำนึงถึงงานของคุณเอง
นี่คืองานนั้นเป๊ะๆ 20 ขั้นตอน ขั้นละ 20,000 ขาเข้าและ 1,000 ขาออก บนโมเดลที่มีใน CheapTokens ตารางเป็นแบบสด ตัวเลขจึงเป็นไปตามราคาปัจจุบัน และมีคอลัมน์ OpenRouter ไว้เปรียบเทียบ เมื่อนับอินพุตและเอาต์พุตรวมกัน ทั้งสามแบบถูกกว่า OpenRouter โดยรวม
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 20 คำขอ | OpenRouter, 20 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
20,000 โทเค็นอินพุตและ 1,000 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
สำหรับลูป agent แบบนี้ DeepSeek-V4-Flash เป็นตัวเลือกที่ลงตัว: คอนเท็กซ์ 380K เอาต์พุตสูงสุด 32,768 โทเคนต่อคำตอบ และราคาเดียวตลอดทั้งวัน การรันตอนกลางคืนจึงมีต้นทุนเท่ากับตอนกลางวัน งานทั้งหมดตลอด 20 ขั้นตอนบนโมเดลนี้รวมเป็น $0.008 ดูรายละเอียดที่ หน้ารุ่นโมเดล และ ตารางราคา สำหรับทุกโมเดล
แชทบอทเป็นเรื่องตรงกันข้าม#
ทีนี้ลองดูซัพพอร์ตบอท สมมติว่าได้รับ 1,000 คำขอต่อวัน และแต่ละอันเป็นคำถาม 2,000 โทเคนพร้อมบริบทและคำตอบ 500 โทเคน ไม่มีลูป ไม่มีประวัติที่โตขึ้น ลองครั้งเดียว
ตรงนี้ราคาต่อโทเคนแทบจะเท่ากับต้นทุนต่องาน เพราะไม่มีอะไรมาคูณเพิ่ม บน GLM-5.3-Flash ที่มีคอนเท็กซ์ 390K และเอาต์พุตสูงสุด 8,192 โทเคนต่อคำตอบ หนึ่งคำขอมีต้นทุน $0.00006 และทั้งวัน 1,000 คำขอมีต้นทุน $0.06
ดังนั้นหลักง่ายๆ คือ งานสั้นที่ทำครั้งเดียว: ราคาต่อโทเคนเป็นตัวชี้วัดที่ยุติธรรม งานที่เป็นลูป งานที่ต้องลองใหม่บ่อย หรือต้องตอบยาว: คิดราคาทั้งงานก่อนเลือก
วัดงานของคุณเองในสิบนาที#
ตัวเลขของคุณเองดีกว่าตัวอย่างใดๆ ในที่นี้ สคริปต์ด้านล่างส่งหนึ่งคำขอและพิมพ์จำนวนที่ใช้จริงและต้นทุนของมัน ราคาในสคริปต์เป็นเพียงตัวอย่าง: แทนที่ด้วยราคาปัจจุบันจาก ตารางราคา
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
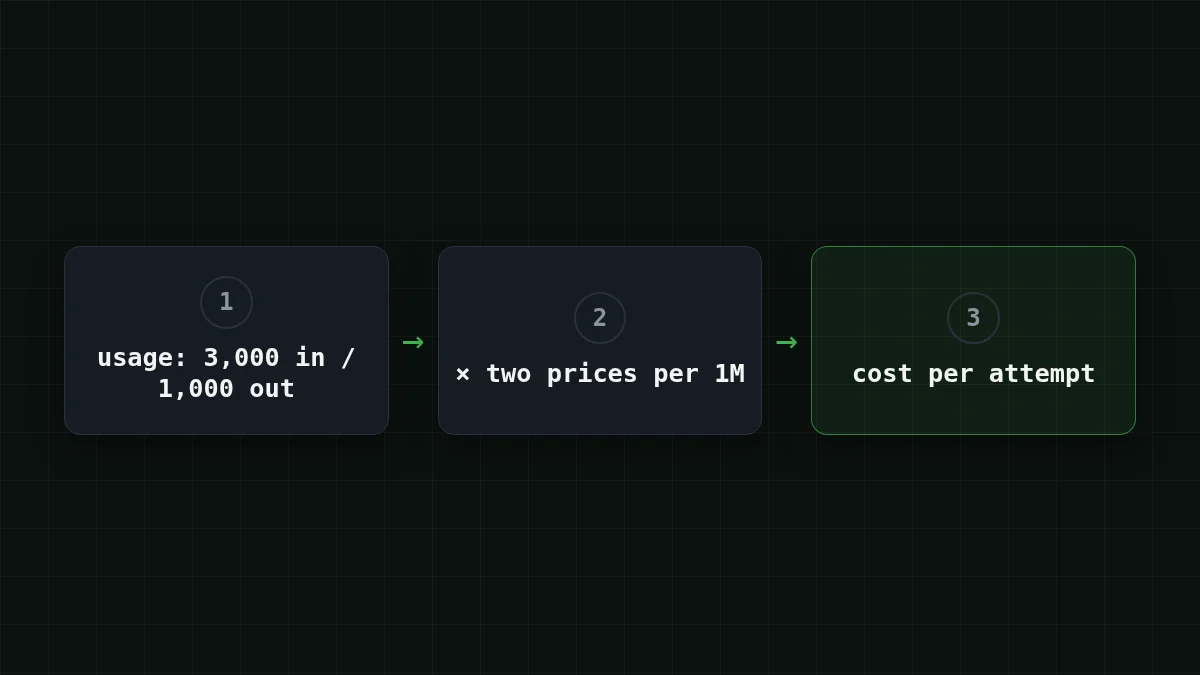
เมื่อมันทำงานได้ คุณจะได้ตัวเลขสามตัวในบรรทัดเดียว: โทเคนขาเข้า โทเคนขาออก และต้นทุนของการลองครั้งนั้น จากนั้น:
- รันงานจริงของคุณ 20 งาน ไม่ใช่ของเล่น
- รวมต้นทุนของทุกครั้งที่ลอง รวมถึงครั้งที่โยนทิ้งไป
- หารด้วย 20 นั่นคือต้นทุนต่องานของคุณ
- ทำซ้ำกับโมเดลอื่นแล้วเปรียบเทียบผลลัพธ์ทั้งสอง
สำหรับการรันที่ยาวขึ้น การติดตามต้นทุนโทเคนของ agent ใน Python เพิ่มงบประมาณและจุดหยุดให้กับแนวคิดเดียวกัน และ คำขอหนึ่งใช้กี่โทเคน แสดงขนาดทั่วไปให้เริ่มต้น
ตรวจสอบเร็วๆ#
เช็กด่วน
โมเดล B มีราคาต่อโทเคนถูกกว่าครึ่งหนึ่งของโมเดล A เมื่อไรที่ B ยังมีต้นทุนต่องานที่เสร็จแล้วสูงกว่าได้?
แสดงคำตอบ
คำตอบ: เมื่อต้องลองหลายครั้งขึ้นหรือเขียนคำตอบยาวกว่ามาก
ต้นทุนต่องาน = จำนวนครั้ง × โทเคน × ราคา ลดราคาลงครึ่ง เพิ่มจำนวนครั้งเป็นสามเท่า แล้วคุณจ่ายมากกว่า 1.5 เท่า
ต่อไป โทเคนอินพุตกับเอาต์พุต อธิบายว่าทำไมสองฝั่งจึงตั้งราคาต่างกัน และ เอกสาร พาคุณจากคีย์ไปสู่คำขอแรก


