प्रति 1M टोकन कीमत बनाम प्रति काम लागत: AI मॉडलों की तुलना कैसे करें
कम प्रति 1M टोकन कीमत वाला मॉडल फिर भी प्रति पूरे काम ज़्यादा महँगा पड़ सकता है। tokens in, tokens out और प्रयासों से प्रति-काम लागत निकालना सीखें।
इस पृष्ठ पर
मॉडलों की तुलना इस बात से करें कि एक पूरा हुआ काम कितने का पड़ता है, न कि प्रति 1M टोकन की कीमत से। एक काम की लागत = tokens in × input price + tokens out × output price, जिसे जितने भी प्रयास लगें उतने से गुणा करें। यानी आधी प्रति-टोकन कीमत वाला मॉडल भी आपको बड़ा बिल दे सकता है।
यही आम चौंकाने वाली बात है: एजेंट काम पूरा कर लेता है, कीमत सूची सस्ती लगती है, और बिल काम के हक से बड़ा आ जाता है। आइए देखें कि अंतर कहाँ छिपा है।
प्रति टोकन कीमत, प्रति किलो कीमत है#
आटे की प्रति किलो कीमत आपको रात के खाने की लागत के बारे में कुछ नहीं बताती। आपको यह जानना होता है कि रेसिपी में कितने किलो लगते हैं, और क्या आप पहला बैच जला कर फिर से शुरू करते हैं।
AI मॉडल भी इसी तरह काम करते हैं। प्रति 1M टोकन की कीमत प्रति किलो की कीमत है। काम रात का खाना है। हर अनुरोध का बिल दो तरफ़ से आता है: आपके भेजे गए टोकन (input) और मॉडल द्वारा लिखे गए टोकन (output)। दोनों संख्याएँ OpenAI-संगत API, जैसे https:/ पर CheapTokens API, के हर प्रतिक्रिया के usage फ़ील्ड में वापस आती हैं (29 अक्टूबर 2026 को जाँचा गया), इसलिए आपको इनका अंदाज़ा कभी नहीं लगाना पड़ता।
पूरा सूत्र यह है:
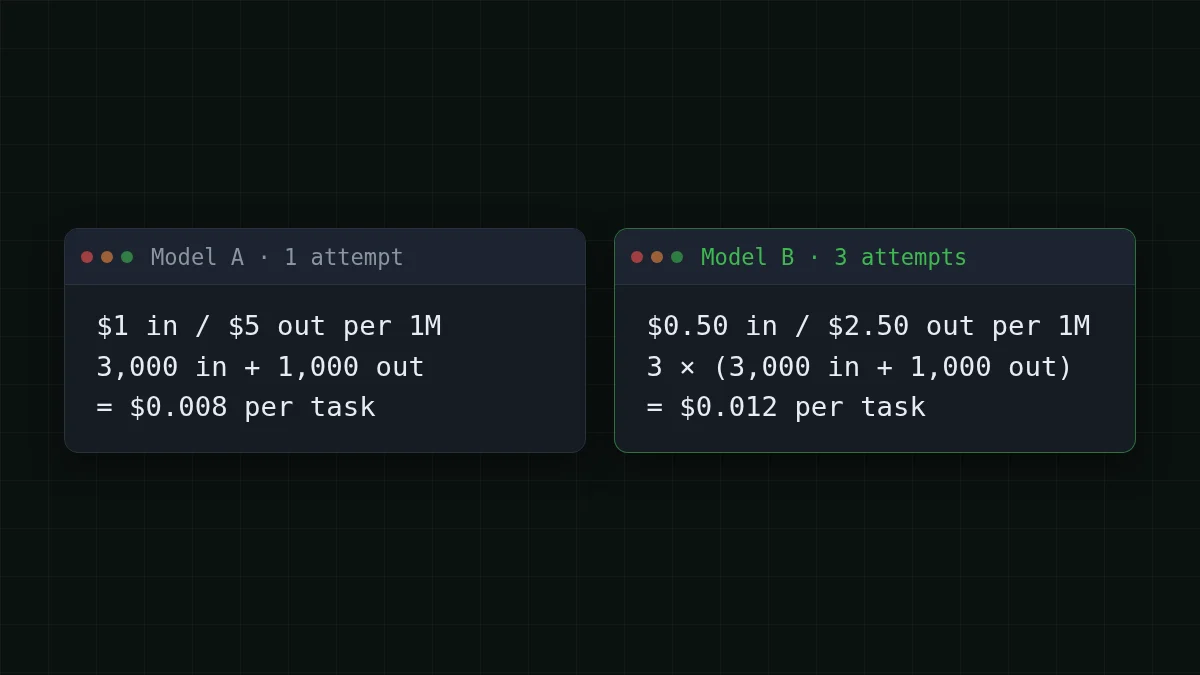
cost per task = attempts × (tokens in × input price + tokens out × output price)मान लें एक काम 3,000 टोकन भेजता है और 1,000 वापस पाता है। मॉडल A की input कीमत $1 प्रति 1M टोकन और output की $5 है। मॉडल B उससे आधा है: $0.50 और $2.50। (ये जोड़ के लिए बनाए गए गोल-मोल दाम हैं, किसी की कीमत सूची नहीं।)
मॉडल A, एक प्रयास:
- 3,000 × $1 ÷ 1,000,000 = input के लिए $0.003
- 1,000 × $5 ÷ 1,000,000 = output के लिए $0.005
- $0.003 + $0.005 = प्रति काम $0.008
मॉडल B सौदे जैसा लगता है। लेकिन मान लें कि उसे उपयोगी नतीजा पाने में तीन कोशिशें लगती हैं, और हर कोशिश का खर्च समान है:
- 3,000 × $0.50 ÷ 1,000,000 = input के लिए $0.0015
- 1,000 × $2.50 ÷ 1,000,000 = output के लिए $0.0025
- $0.0015 + $0.0025 = प्रति प्रयास $0.004
- 3 × $0.004 = प्रति काम $0.012
प्रति टोकन आधी कीमत, प्रति काम डेढ़ गुना कीमत। यही बात बिना दोबारा कोशिश के भी होती है अगर B बस लंबे जवाब लिखता है: एक प्रयास में 3,000 output टोकन के साथ, 3,000 × $2.50 ÷ 1,000,000 = $0.0075, और $0.0015 + $0.0075 = $0.009। फिर भी A के $0.008 से ज़्यादा।
और उल्टा भी सच है। अगर B पहली बार में सही कर दे, तो उसका खर्च प्रति काम $0.004 है, यानी A का आधा। प्रति-टोकन कीमत तभी जीतती है जब टोकन और प्रयासों की संख्या लगभग बराबर हो। और यही चीज़ जाँचने लायक है।
फ्लैशकार्ड
हर API दस्तावेज़ में मिलने वाले शब्द
पलटने के लिए कार्ड पर टैप करें
प्रति काम टोकन असल में कहाँ जाते हैं#
तीन चीज़ें टोकन की संख्या बदलती हैं, और इनमें से कोई भी कीमत सूची पर नहीं दिखती।
- जवाब की लंबाई। जो मॉडल खुद को विस्तार से समझाता है, वह एक पंक्ति में जवाब देने वाले से ज़्यादा output टोकन लिखता है।
- दोबारा कोशिशें। विफल या बेकार जवाब का भी टोकन खर्च हुआ, और अगली कोशिश फिर से भुगतान करती है।
- दोबारा भेजा गया संदर्भ। API को याद नहीं रहता: एजेंट का हर चरण निर्देश, फ़ाइलें और इतिहास फिर से भेजता है। अगर यह नया है, तो लंबी चैट ज़्यादा महँगी क्यों पड़ती है इसका तंत्र दिखाता है।
तीसरी बात एजेंट के लिए सबसे बड़ी है। एक कोडिंग एजेंट लें जो 20 चरणों में काम करता है। मान लें एक भारी एजेंट चरण: 20,000 टोकन in और 1,000 वापस। असली चरण-दर-चरण संख्याओं वाले हल्के रन के लिए, देखें AI एजेंट इतने सारे टोकन क्यों इस्तेमाल करते हैं। जवाब छोटे हैं। input नहीं।
संख्या का अनुमान लगाएँ
अगर हर चरण 20,000 भेजता है, तो 20-चरण वाला एजेंट कुल कितने input टोकन भेजता है?
आपका अनुमान
010,00,000
उत्तर दिखाएँ
उत्तर: 4,00,000
20 × 20,000 = 400,000। हर चरण संदर्भ फिर से भेजता है, इसलिए input जमा होता जाता है, भले ही हर जवाब छोटा हो।
तो इस काम के लिए बिल input पक्ष तय करता है, और output पक्ष का लगभग कोई महत्व नहीं। सस्ती input कीमत वाला मॉडल यहाँ जीत सकता है, भले ही उसकी output कीमत साधारण लगे। यह बात कीमत सूची आपको तभी दिखाती है जब आप उसे अपने काम को ध्यान में रखकर पढ़ें।
यही ठीक वह काम है, 20 चरण, हर चरण 20,000 in और 1,000 out, CheapTokens पर उपलब्ध मॉडलों पर। तालिका लाइव है, इसलिए संख्याएँ मौजूदा कीमतों के अनुसार चलती हैं, और OpenRouter कॉलम तुलना के लिए है। input और output को मिलाकर, तीनों कुल मिलाकर OpenRouter से सस्ते हैं।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 20 अनुरोध | OpenRouter, 20 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00044 | $0.0088 | $0.0151 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0004 | $0.008 | $0.0308 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0012 | $0.023 | $0.276 |
प्रति अनुरोध 20,000 इनपुट और 1,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
इस तरह के एजेंट लूप के लिए, DeepSeek-V4-Flash स्वाभाविक रूप से उपयुक्त है: 380K संदर्भ, प्रति जवाब अधिकतम 32,768 output टोकन, और दिन के किसी भी समय एक ही कीमत, इसलिए रात का रन दिन के रन जितना ही खर्च करता है। इस पर सभी 20 चरणों में पूरा काम $0.008 में आता है। विवरण के लिए मॉडल पेज देखें और हर मॉडल के लिए कीमत तालिका देखें।
चैटबॉट की कहानी उल्टी है#
अब एक सपोर्ट बॉट लें। मान लें उसे रोज़ 1,000 अनुरोध मिलते हैं, और हर एक संदर्भ के साथ 2,000-टोकन का सवाल और 500-टोकन का जवाब है। कोई लूप नहीं, बढ़ता इतिहास नहीं, एक प्रयास।
यहाँ प्रति-टोकन कीमत लगभग प्रति-काम लागत है, क्योंकि इसे कोई गुणा नहीं करता। GLM-5.3-Flash पर, 390K संदर्भ और प्रति जवाब अधिकतम 8,192 output टोकन के साथ, एक अनुरोध का खर्च $0.00006 है और 1,000 अनुरोधों का पूरा दिन $0.06 का पड़ता है।
तो अंगूठे का नियम सरल है। छोटा, एक-बार वाला काम: प्रति-टोकन कीमत उचित मार्गदर्शक है। लूप, दोबारा कोशिश वाला काम या लंबे जवाब वाला काम: चुनने से पहले पूरे काम का दाम निकालें।
अपना काम दस मिनट में मापें#
आपकी अपनी संख्याएँ यहाँ के किसी भी उदाहरण से बेहतर हैं। नीचे दी स्क्रिप्ट एक अनुरोध भेजती है और बताती है कि उसने असल में कितना इस्तेमाल किया और उसका खर्च क्या है। इसमें दी कीमतें एक उदाहरण हैं: कीमत तालिका से मौजूदा कीमतें डालें।
from openai import OpenAI

client = OpenAI(base_url="https://api.cheaptokens.dev/v1", api_key="YOUR_KEY")

# example prices per 1M tokens, substitute current ones
PRICE_IN, PRICE_OUT = 1.00, 5.00

resp = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Summarize this ticket in one sentence: <your text>"}],
    max_tokens=300,
)
u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(u.prompt_tokens, u.completion_tokens, round(cost, 6))
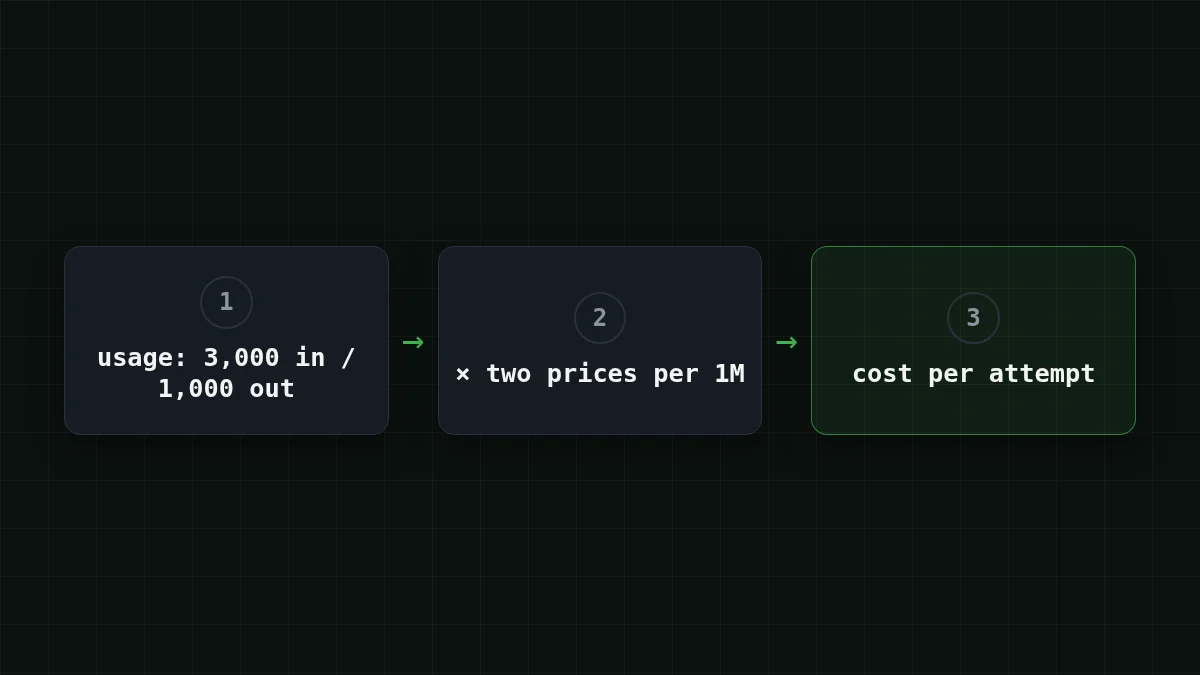
जब यह चलती है तो आपको एक पंक्ति में तीन संख्याएँ मिलती हैं: tokens in, tokens out और उस प्रयास की लागत। फिर:
- अपने 20 असली काम चलाएँ, खिलौने वाले नहीं।
- हर प्रयास की लागत जोड़ें, उन सहित जिन्हें आपने फेंक दिया।
- 20 से भाग दें। यही आपकी प्रति-काम लागत है।
- दूसरे मॉडल के साथ दोहराएँ और दोनों नतीजों की तुलना करें।
लंबे रन के लिए, Python में एजेंट टोकन लागत ट्रैक करना इसी विचार में बजट और रोक जोड़ता है, और एक अनुरोध कितने टोकन इस्तेमाल करता है शुरुआत के लिए सामान्य आकार दिखाता है।
त्वरित जाँच#
त्वरित जाँच
मॉडल B की प्रति-टोकन कीमत मॉडल A से आधी है। B फिर भी प्रति पूरे काम ज़्यादा महँगा कब पड़ सकता है?
उत्तर दिखाएँ
उत्तर: जब उसे ज़्यादा प्रयास लगें या वह बहुत लंबे जवाब लिखे
प्रति काम लागत = प्रयास × टोकन × कीमत। कीमत आधी करें, प्रयास तीन गुना करें और आप 1.5 गुना भुगतान करते हैं।
आगे, input बनाम output टोकन बताता है कि दोनों पक्षों की कीमत अलग क्यों है, और दस्तावेज़ आपको कुंजी से पहले अनुरोध तक पहुँचाते हैं।


