लागत अनुकूलनगाइड
चलाने से पहले एक मॉडल टूर्नामेंट की API लागत का अनुमान लगाएं
प्रति सीट टोकन गिनें, खेलों और पक्ष बदलने से गुणा करें, और Python में एक हार्ड कैप सेट करें: 6-सीट, 60-खेल मॉडल टूर्नामेंट के लिए एक काम किया हुआ अनुमान।
इस पृष्ठ पर
आप पहले अनुरोध से पहले ही एक मॉडल टूर्नामेंट का बिल जान सकते हैं: एक सीट पूरे खेल में कितने टोकन भेजती है, गिनें, सीटों और खेलों से गुणा करें, और कोड में एक हार्ड कैप लगाएं। जो चीज़ लोग चूक जाते हैं वह है हिस्ट्री। हर टर्न अब तक कही गई हर बात फिर से भेजता है, इसलिए इनपुट टर्न की संख्या से बहुत तेज़ी से बढ़ता है।
$20,000 का हेडलाइन क्या बताता है और क्या नहीं#
5 नवंबर 2026 को पॉडकास्टर Dwarkesh Patel ने Clocktower Bench प्रकाशित किया, एक बेंचमार्क जिसमें मॉडल एक-दूसरे के खिलाफ सोशल-डिडक्शन गेम Blood on the Clocktower खेलते हैं। वे कहते हैं कि उन्होंने हार्नेस बनाने में लगभग $20,000 के API क्रेडिट खर्च किए, और उसका बड़ा हिस्सा एनवायरनमेंट डिज़ाइन पर पुनरावृत्ति में गया, उनके अनुमानित टोकन से अधिक।
प्रोजेक्ट का README (8 नवंबर 2026 को जाँचा गया) सेटअप बताता है: 11 मॉडल, हेडलाइन रैंकिंग के लिए 386 खेल, एक मॉडल हर अच्छी सीट और दूसरा हर बुरी सीट खेलता है, 10–12 खिलाड़ी, कई घंटे चलने वाले खेल। हर डील पक्षों को बदलकर दोबारा खेली जाती है, ताकि किसी भी मॉडल को आसान भूमिका न मिले। इसमें एक मुफ़्त ड्राई रन (--model random) भी है, खर्च games/ में लिखा जाता है, और एक --budget कैप है जिसका डिफ़ॉल्ट $1,000 है।
जो यह नहीं देता वह है प्रति खेल टोकन। तो कॉपी करने के लिए कुछ नहीं है; आप अनुमान खुद बनाते हैं। यही इस लेख का बाकी हिस्सा करता है, स्पष्ट मान्यताओं के साथ जिन्हें आप अपनी मान्यताओं से बदल सकते हैं।
एक सीट: इनपुट क्यों बढ़ता रहता है#
मान लें आप एक छोटा खेल चलाते हैं: 6 सीटें, हर सीट एक मॉडल है जिसकी अपनी बातचीत है, प्रति सीट 20 टर्न। मान लें 2,000-टोकन का सिस्टम प्रॉम्प्ट (नियम और सीट की भूमिका), हर टर्न से पहले 600 नए टोकन की टेबल टॉक आती है, और 300-टोकन का जवाब। API की कोई मेमोरी नहीं होती, इसलिए हर अनुरोध पूरी बातचीत फिर से ले जाता है (लंबी चैट ज़्यादा महंगी क्यों पड़ती है)।
टर्न 1 भेजता है 2,000 + 600 = 2,600 टोकन। टर्न 20 भेजता है 2,000 + 600 × 20 + 300 × 19 = 19,700। आखिरी संख्या खुद आज़माएं:
संख्या का अनुमान लगाएँ
एक सीट अपने 20वें टर्न पर कितने इनपुट टोकन भेजती है?
आपका अनुमान
040,000
उत्तर दिखाएँ
उत्तर: 19,700
19,700: 2,000-टोकन का सिस्टम प्रॉम्प्ट, 20 × 600 नई बातचीत, और 300-300 के 19 पिछले जवाब। हर पुराना जवाब और हर पुराना संदेश वापस जाता है।
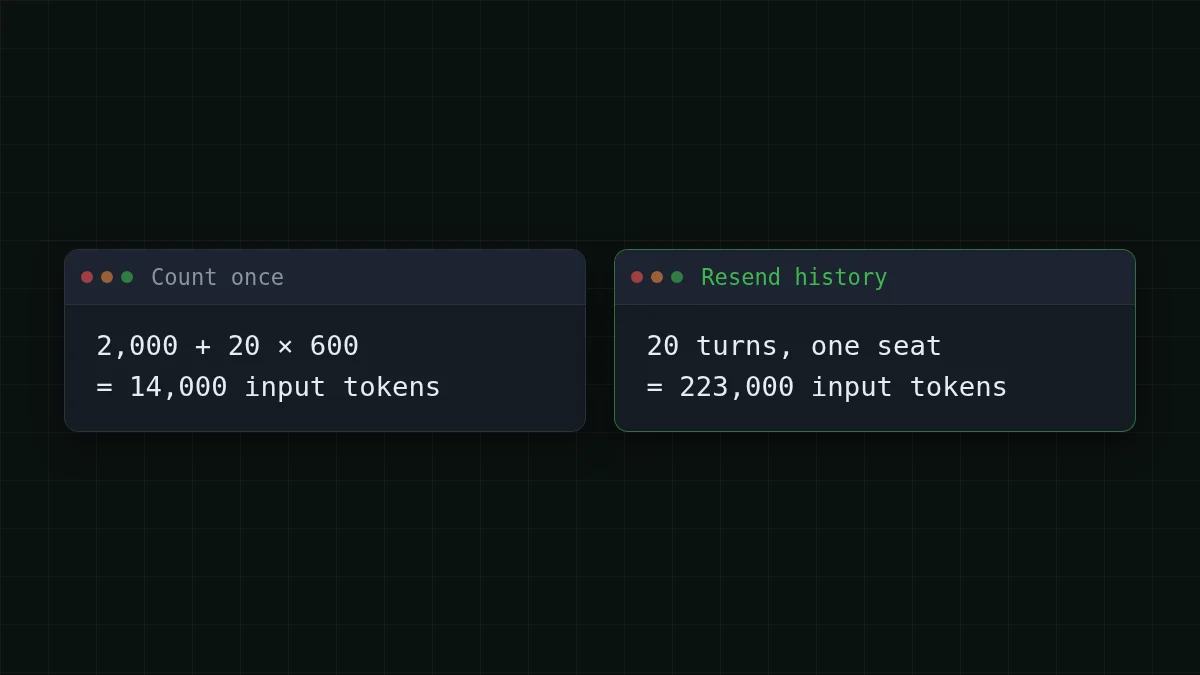
एक सीट के सभी 20 टर्न जोड़ें: 2,000 × 20 + 600 × 210 + 300 × 190 = 40,000 + 126,000 + 57,000 = 223,000 इनपुट टोकन। आउटपुट केवल 20 × 300 = 6,000 है। अगर आप हर संदेश एक बार गिनते, तो आपको 2,000 + 20 × 600 = 14,000 मिलता और आप सोलह के गुणक से चूक जाते।
आउटपुट पक्ष मुश्किल से हिलता है। पैसा इनपुट में जाता है, और यही वह पक्ष है जो खेल लंबे होने पर बदतर होता जाता है।
एक सीट से पूरे टूर्नामेंट तक#
अब इसे तीन गुणकों से स्केल करें।
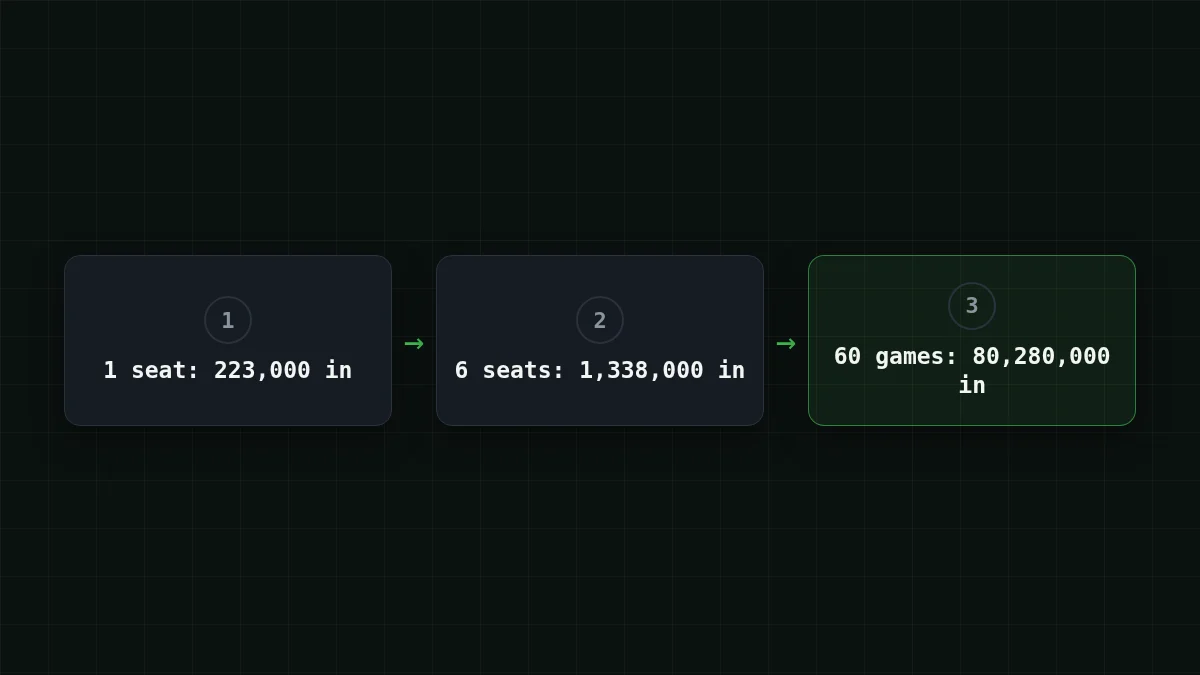
- सीटें। 6 सीटें × 223,000 = 1,338,000 इनपुट टोकन और प्रति खेल 6 × 6,000 = 36,000 आउटपुट टोकन।
- पक्ष बदलना। राउंड रॉबिन में 3 मॉडल लें: 3 जोड़ियाँ। प्रति जोड़ी 10 डील खेलें, हर एक दो बार पक्ष बदलकर: 3 × 10 × 2 = 60 खेल।
- खेल। टूर्नामेंट के लिए 60 × 1,338,000 = 80,280,000 इनपुट और 60 × 36,000 = 2,160,000 आउटपुट टोकन।
DeepSeek-V4-Flash पर एक खेल $0.0237 पर आता है। नीचे दी गई तालिका पूरे 60-खेल टूर्नामेंट की कीमत इस तरह लगाती है जैसे वह एक मॉडल हर सीट खेल रहा हो, ताकि आप इस तरह के लंबी-बातचीत वाले काम के लिए CheapTokens द्वारा दिए गए तीन मॉडलों की तुलना कर सकें। कुल मिलाकर, इनपुट और आउटपुट को साथ गिनते हुए, उनमें से हर एक आखिरी कॉलम में OpenRouter संदर्भ से सस्ता है।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 60 अनुरोध | OpenRouter, 60 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0282 | $1.69 | $2.87 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0237 | $1.42 | $5.92 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0723 | $4.34 | $52.06 |
प्रति अनुरोध 13,38,000 इनपुट और 36,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
बजट के लिहाज़ से यही पूरी तरकीब है: तीन मॉडलों में से कौन बातचीत का खेल बेहतर खेलता है, यह जानने के लिए आपको $20,000 की लाइन आइटम की ज़रूरत नहीं। आपको ऊपर का अनुमान चाहिए, और फिर उसे जाँचने के लिए एक असली पायलट।
त्वरित जाँच
आपका 6-सीट वाला खेल प्रति सीट 20 से 40 टर्न पर चला जाता है। इनपुट बिल का क्या होता है?
उत्तर दिखाएँ
उत्तर: यह लगभग 3.6 गुना बढ़ता है
40 टर्न के लिए वही सूत्र देता है 2,000 × 40 + 600 × 820 + 300 × 780 = 806,000 इनपुट टोकन, जबकि 20 टर्न के लिए 223,000। हिस्ट्री वाला पद टर्न की संख्या के वर्ग के साथ बढ़ता है।
ऐसी किसी भी संख्या पर भरोसा करने से पहले दो जाँचें। पहला, सबसे बड़ा अनुरोध मॉडल की विंडो में फिट होना चाहिए। 20 टर्न पर सबसे बड़ा अनुरोध 19,700 टोकन है, कोई दिक्कत नहीं। प्रति सीट 200 टर्न वाला कई घंटे का खेल 2,000 + 600 × 200 + 300 × 199 = 181,700 तक पहुँचता है, लगभग 182K, इसलिए खेल डिज़ाइन करने से पहले मॉडल के पेज पर कॉन्टेक्स्ट साइज़ पढ़ें। DeepSeek-V4-Flash की 380K विंडो और 32,768 आउटपुट टोकन तक है; देखें मॉडल पेज। दूसरा, अगर कोई मॉडल लंबा रीज़निंग देता है, तो आपके 300 आउटपुट टोकन बढ़ जाते हैं (बल्क जॉब में थिंकिंग टोकन)।
कोड में एक हार्ड कैप लगाएं#
README का --budget फ़्लैग सही विचार है, और इसे अपने हार्नेस में कॉपी करने में दस लाइनें लगती हैं। नीचे दी गई स्क्रिप्ट चलने से पहले अनुमान लगाती है, ऐसा अनुरोध भेजने से मना कर देती है जो कुल को कैप से ऊपर धकेल सकता है, और हर कॉल को एक लेजर फ़ाइल में लॉग करती है। इसमें दी गई कीमतें एक उदाहरण हैं: प्राइसिंग तालिका से मौजूदा कीमतें लगाएं।
import json, os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN, PRICE_OUT = 0.10, 0.40  # per 1M tokens: example, substitute current
CAP_USD = 5.00
spent = 0.0


def cost(tin, tout):
    return (tin * PRICE_IN + tout * PRICE_OUT) / 1_000_000


def estimate(seats, turns, system=2000, new_in=600, out=300):
    tin = sum(system + new_in * k + out * (k - 1) for k in range(1, turns + 1))
    return seats * tin, seats * turns * out


def ask(seat, history, max_out=400):
    global spent
    rough_in = sum(len(m['content']) for m in history) // 3  # pessimistic
    if spent + cost(rough_in, max_out) > CAP_USD:
        raise SystemExit(f'cap reached: ${spent:.4f} spent')
    r = client.chat.completions.create(
        model=MODEL, messages=history, max_tokens=max_out)
    u = r.usage
    spent += cost(u.prompt_tokens, u.completion_tokens)
    with open('ledger.jsonl', 'a') as f:
        f.write(json.dumps({'seat': seat, 'in': u.prompt_tokens,
                            'out': u.completion_tokens,
                            'spent': round(spent, 6)}) + '\n')
    return r.choices[0].message.content


print(estimate(6, 20))  # (1338000, 36000) per game
estimate(6, 20) (1338000, 36000) प्रिंट करता है, ऊपर वही प्रति-खेल संख्याएँ, ताकि कोड और अंकगणित एक-दूसरे की जाँच करें। usage. और usage. प्रतिक्रिया से आते हैं और इन्हीं का आपको बिल लगता है; प्री-चेक एक निराशावादी कैरेक्टर काउंट का उपयोग करता है क्योंकि असली गिनती कॉल के बाद ही पता चलती है। प्रति-प्रोजेक्ट लेजर के बारे में अधिक जानकारी Python में एजेंट टोकन लागत ट्रैक करना में।
पहले रन के लिए एक सुरक्षित क्रम#
रेपो का अपना क्रम एक अच्छा मॉडल है: पहले मुफ़्त, फिर सस्ता, आखिर में महंगा। इन चरणों को क्रम में रखें:
क्रम में लगाएँ
एक सुरक्षित पहले रन के चरणों को क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- एक रैंडम खिलाड़ी के साथ ड्राई रन, कोई API कॉल नहीं
estimate()चलाएं और इसकी तुलना अपने कैप से करें- एक असली खेल खेलें और लेजर पढ़ें
- असली टोकन गिनती से मान्यताओं को सुधारें
- कैप चालू रखते हुए पूरा टूर्नामेंट शुरू करें
README कहता है कि सस्ते मॉडलों पर एक डेमो खेल लगभग $2–5 का पड़ता है। यह लेखक का कथन है और मॉडलों के नाम नहीं दिए गए हैं, इसलिए इसे एक सैनिटी रेंज मानें, अपने सेटअप के लिए कोट नहीं। आपका अपना पायलट खेल वह संख्या देता है जो मायने रखती है: अगर इसका लेजर 1,500,000 इनपुट टोकन दिखाता है जहाँ आपने 1,338,000 माना था, तो आपने खेल 40 पर नहीं, कुछ सेंट में कुछ सीख लिया।
लंबे प्रयोगों के लिए, आम लीवर चैट हिस्ट्री छोटी करना में हैं: हर सीट को जो दोबारा पढ़ना पड़ता है उसे काटें, और द्विघातीय पद उसके साथ सिकुड़ जाता है। जब आप इसे चलाने के लिए तैयार हों, डॉक्स में एंडपॉइंट और मॉडल आईडी हैं।


