शुरुआत करेंगाइड
Python में requests के साथ CheapTokens को पहला request, बिना SDK
सिर्फ़ requests वाली 20-लाइन की Python स्क्रिप्ट: एक chat completion, एक timeout, HTTP error handling, और answer, finish_reason और usage प्रिंट।
इस पृष्ठ पर
OpenAI-संगत API से बात करने के लिए आपको openai पैकेज की ज़रूरत नहीं है। एक requests.post कॉल, एक Bearer key और एक JSON body काफ़ी है, और आपको ठीक-ठीक दिखता है कि wire पर क्या जाता है। यह गाइड CheapTokens (https:/) के लिए वही स्क्रिप्ट बनाती है और अंत में यह answer, finish_reason और token usage प्रिंट करती है।
यह तब अच्छी रहती है जब आप किसी locked-down मशीन पर हों जहाँ सिर्फ़ requests इंस्टॉल है, जब किसी छोटे cron job के लिए SDK नहीं चाहिए, या जब आप बस समझना चाहते हैं कि SDK आपके लिए क्या करता है। first-request guide में SDK, curl और Node के तरीके हैं; यह plain-Python वाला है।
पूरी स्क्रिप्ट#
पहले अपनी key एक environment variable में रखें (how to store an API key safely देखें), फिर इसे ask.py के रूप में सेव करें:
import os
import requests

url = "https://api.cheaptokens.dev/v1/chat/completions"
headers = {"Authorization": f"Bearer {os.environ['CHEAPTOKENS_API_KEY']}"}
payload = {
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [
        {"role": "user", "content": "Explain what a token is in two sentences."}
    ],
    "max_tokens": 200,
}

try:
    r = requests.post(url, headers=headers, json=payload, timeout=30)
    r.raise_for_status()
except requests.exceptions.Timeout:
    raise SystemExit("No reply within 30 seconds - try again or raise the timeout")
except requests.exceptions.HTTPError as e:
    raise SystemExit(f"HTTP {e.response.status_code}: {e.response.text}")

data = r.json()
choice = data["choices"][0]
print(choice["message"]["content"])
print("finish_reason:", choice["finish_reason"])
print("usage:", data["usage"])
python ask.py चलाएँ। model id पूरा gateway id है, deepseek-; अगर आपको पता नहीं कि वहाँ क्या डालना है, तो list the models with GET /v1/models देखें। दूसरा model आज़माने के लिए zai- डालें और बाकी कुछ न बदलें: एक balance सभी models के लिए चलता है।
हर लाइन क्या कर रही है#
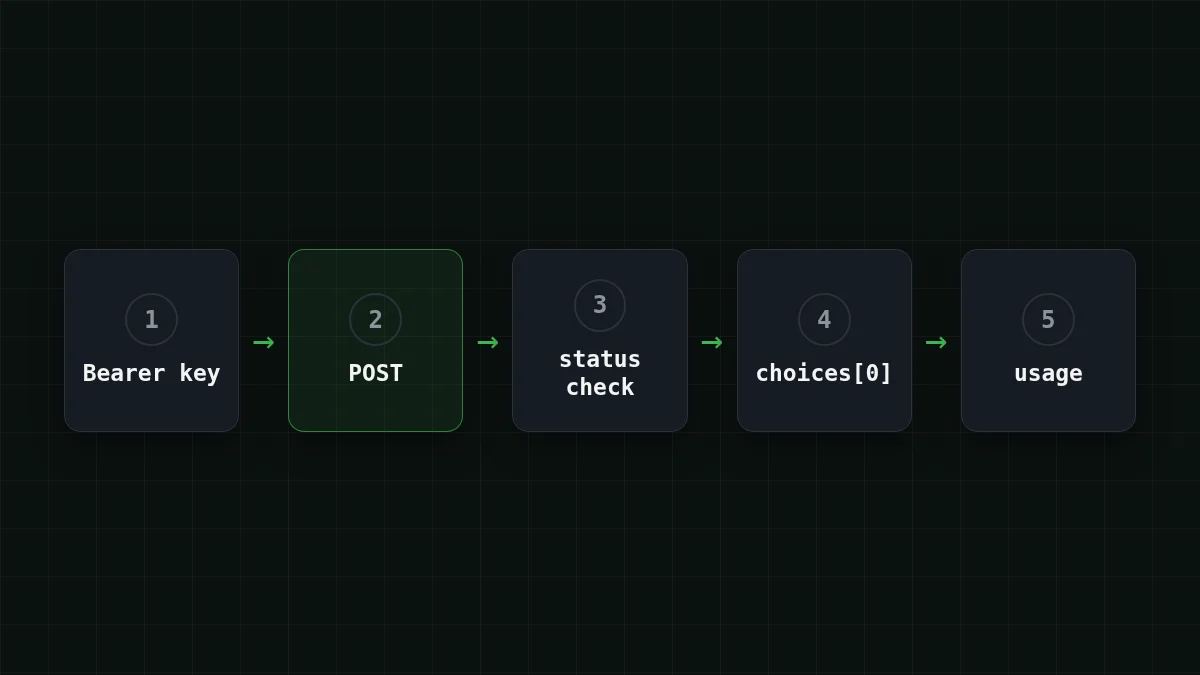
स्क्रिप्ट जिन पाँच बातों पर टिकी है, वे ये हैं। requests Quickstart (living docs, checked 2 November 2026) इनमें से ज़्यादातर समझाता है, और OpenAI का Chat Completions reference reply के fields परिभाषित करता है।
फ्लैशकार्ड
स्क्रिप्ट में पाँच चीज़ें
पलटने के लिए कार्ड पर टैप करें
तीसरा bullet ही वह है जिसे लोग छोड़ देते हैं। cron job में हमेशा के लिए अटकी स्क्रिप्ट 30 सेकंड बाद ज़ोर से fail होने वाली स्क्रिप्ट से कहीं ज़्यादा खराब है।
Reply पढ़ें#
सफल response JSON होता है। Chat Completions reference के अनुसार, जिन हिस्सों की आपको परवाह है:
choices[0].text है। यहmessage. content nullहो सकता है, इसलिए उस पर आँख मूँदकर string methods न चलाएँ।choices[0].बताता है कि model क्यों रुका:finish_ reason stop(पूरा हुआ),length(max_tokenslimit ने काट दिया),tool_calls,content_filter।usage.,prompt_ tokens usage.औरcompletion_ tokens usage.वही हैं जिनका आपको बिल लगता है: input, output, और उनका योग।total_ tokens
Reply का आकार ऐसा है (संख्याएँ placeholder हैं):
{
  "choices": [
    {
      "message": {"role": "assistant", "content": "A token is a small piece of text..."},
      "finish_reason": "stop"
    }
  ],
  "usage": {"prompt_tokens": 18, "completion_tokens": 52, "total_tokens": 70}
}
स्वयं आज़माएँआज़माएँ: max_tokens को 5 करें और स्क्रिप्ट फिर चलाएँ। finish_reason क्या कहता है?उत्तर दिखाएँ
यह length कहता है: model आपकी max_tokens limit से रुका, इसलिए answer बीच वाक्य में खत्म हो जाता है। limit बढ़ाएँ और आपको फिर stop मिलता है। पूरी कहानी AI answer cut off? Fix finish_reason "length" में है।
जब यह काम न करे#
स्क्रिप्ट ज़्यादातर failures को output की एक लाइन में बदल देती है। हर एक का आम मतलब यह है:
जोड़े मिलाएँ
हर message को उसके आम कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- HTTP 401Key गायब है, गलत टाइप हुई है या वह नहीं है जो आप भेजना चाहते थे
- HTTP 404URL path या model id गलत है
- requests.exceptions.Timeouttimeout के अंदर कोई bytes नहीं आए
- KeyError: 'CHEAPTOKENS_API_KEY'इस terminal में environment variable सेट नहीं है
असली error bodies और key, base URL और model id की step-by-step जाँच के लिए API 401 or 404 error: wrong key, base URL or model id देखें। दो छोटी gotchas: अगर आपको KeyError: 'choices' दिखे, तो आपने error body को success की तरह parse किया, यानी raise_ छूट गया। और अगर आपकी मशीन पर ~/.netrc फ़ाइल है, तो requests आपके सेट किए Authorization header की जगह उसकी credentials इस्तेमाल कर सकता है।
एक कॉल का खर्च#
ऊपर के reply की placeholder संख्याओं के साथ (लगभग 18 tokens in, 52 out), DeepSeek-V4-Flash की एक कॉल की लागत $0.0000055 है। यह ऐसी संख्या है जो महसूस नहीं होती, इसलिए इसे बड़ा करके देखें। मान लें आपकी स्क्रिप्ट रोज़ 1,000 support tickets summarize करती है, हर एक में लगभग 800 tokens in और 300 out:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
प्रति अनुरोध 800 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कीमतें हर model के लिए तय हैं, कोई peak hours नहीं, इसलिए वही स्क्रिप्ट रात 3 बजे और दोपहर में एक जैसी लागत लेती है। मौजूदा per-model कीमतें pricing page पर हैं, और docs endpoints की सूची देते हैं।
यहाँ से आगे कहाँ जाएँ#
एक बार यह चल जाए, तो आम अगले कदम हैं कई inputs पर loop, 429 पर retry (429 Too Many Requests: retries with backoff देखें), या वही कॉल streaming के साथ। अगर आप HTTP खुद manage नहीं करना चाहते, तो SDK वाला रास्ता बस एक base_url बदलाव दूर है।


