API और SDKगाइड
API (Python) के साथ एक प्रॉम्प्ट से HTML टूल उत्पन्न करें
एक Python स्क्रिप्ट जो एक प्रॉम्प्ट को काम करने वाले tool.html में बदलती है, finish_reason द्वारा कटे हुए उत्तर को पकड़ती है, और टोकन और लागत प्रिंट करती है।
इस पृष्ठ पर
एक API कॉल से आप एक काम करने वाला सिंगल-फ़ाइल टूल प्राप्त कर सकते हैं: एक सुव्यवस्थित प्रॉम्प्ट भेजें, सुनिश्चित करें कि max_tokens पूरे पेज के लिए पर्याप्त बड़ा है, जाँचें कि finish_reason stop है, और उत्तर को tool.html के रूप में सहेजें। नीचे वह स्क्रिप्ट है जो ठीक यही करती है, और एक प्रॉम्प्ट टेम्पलेट जिसे आप अपने टूल के लिए ढाल सकते हैं।
विचार सरल है, और DeepSeek ने इसे अभी दिखाया है। इसने DeepSeek Harness में Creator Mode के लिए सात डेमो प्रॉम्प्ट का संग्रह प्रकाशित किया (पेज, 3 नवंबर 2026 को जाँचा गया): एक 3D लैंडमार्क गैलरी, एक पोस्टर वर्कबेंच, एक वीडियो एडिटिंग वर्कबेंच, एक पेपर रीडर, एक बातचीत सांख्यिकी बोर्ड और कुछ अन्य। Creator Mode Harness ऐप के अंदर रहता है। यदि आप अपनी स्क्रिप्ट में और अपनी कुंजी के साथ वही "प्रॉम्प्ट इन, टूल आउट" प्रवाह चाहते हैं, तो सिंगल-फ़ाइल मामले के लिए एक साधारण चैट कम्प्लीशन पर्याप्त है। यदि आप स्वयं Harness का उपयोग करते हैं, तो इसे CheapTokens से जोड़ना एक अलग संक्षिप्त गाइड है।
"मेरे लिए एक टूल बनाओ" प्रॉम्प्ट में क्या होना चाहिए#
उन डेमो प्रॉम्प्ट में से कुछ पढ़ें और एक पैटर्न सामने आता है। प्रत्येक बताता है कि टूल क्या है, स्क्रीन पर क्या है, नियंत्रण क्या करते हैं, प्रारंभिक स्थिति क्या है, और इसे क्या नहीं करना चाहिए। इनमें से कोई एक छोड़ दें तो मॉडल उस अंतराल को अपने अनुमान से भर देता है, जो आमतौर पर आपका नहीं होता।
यहाँ टेम्पलेट है, पाँच भागों में:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
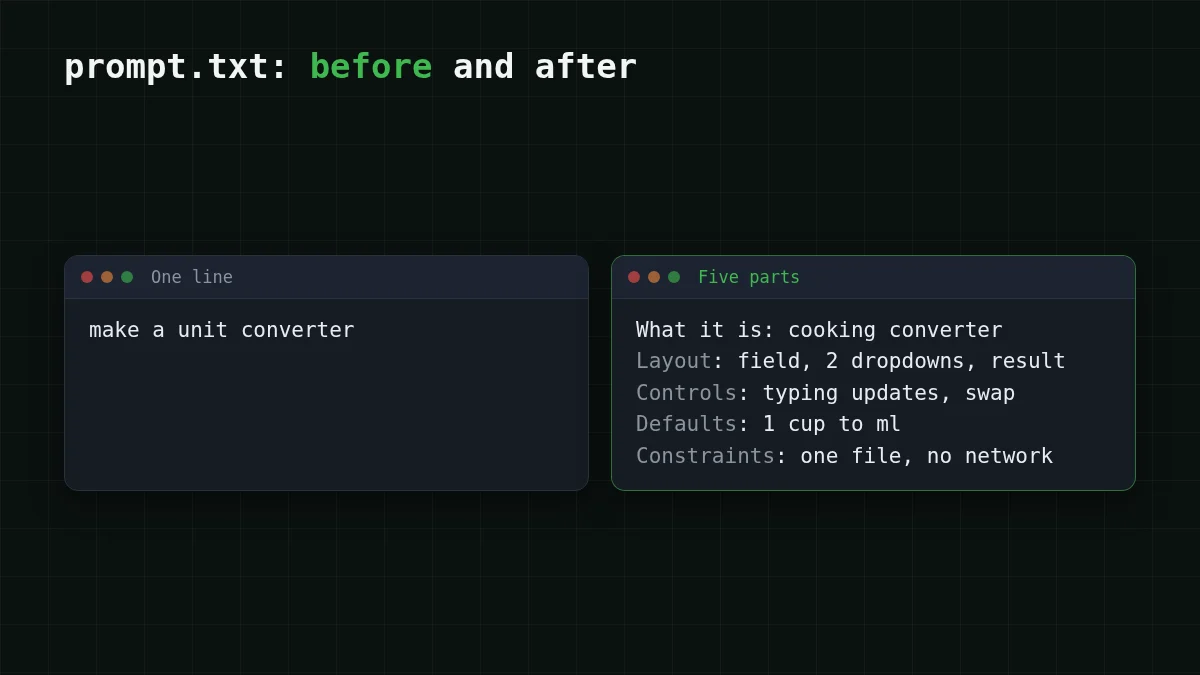
और एक भरा हुआ संस्करण। मान लें कि आप खाना पकाने के मापों को परिवर्तित करते रहते हैं और कनवर्टर खोजने से थक गए हैं:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
इसे स्क्रिप्ट के बगल में prompt.txt के रूप में सहेजें। "Constraints" पंक्ति सबसे अधिक भार उठाती है: "no external requests" के बिना मॉडल एक CDN लाइब्रेरी खींचना पसंद करता है, और फिर पेज ऑफ़लाइन टूट जाता है।
स्क्रिप्ट: अनुरोध, जाँच, सहेजें#
CheapTokens API https:/ पर OpenAI Chat Completions के अनुकूल है, इसलिए openai पैकेज दो बदलावों के साथ काम करता है: बेस URL और कुंजी। पूरे पेज के लिए हम deepseek- का उपयोग करते हैं: यह प्रति उत्तर 32,768 आउटपुट टोकन तक की अनुमति देता है और इसका 380K कॉन्टेक्स्ट विंडो है। पूर्ण API विवरण CheapTokens दस्तावेज़ में हैं।
पैकेज इंस्टॉल करें, अपनी कुंजी एक एनवायरनमेंट वेरिएबल में रखें, और मूल्य तालिका से दो कीमतें सेट करें (स्क्रिप्ट उनका उपयोग लागत प्रिंट करने के लिए करती है):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
फिर make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
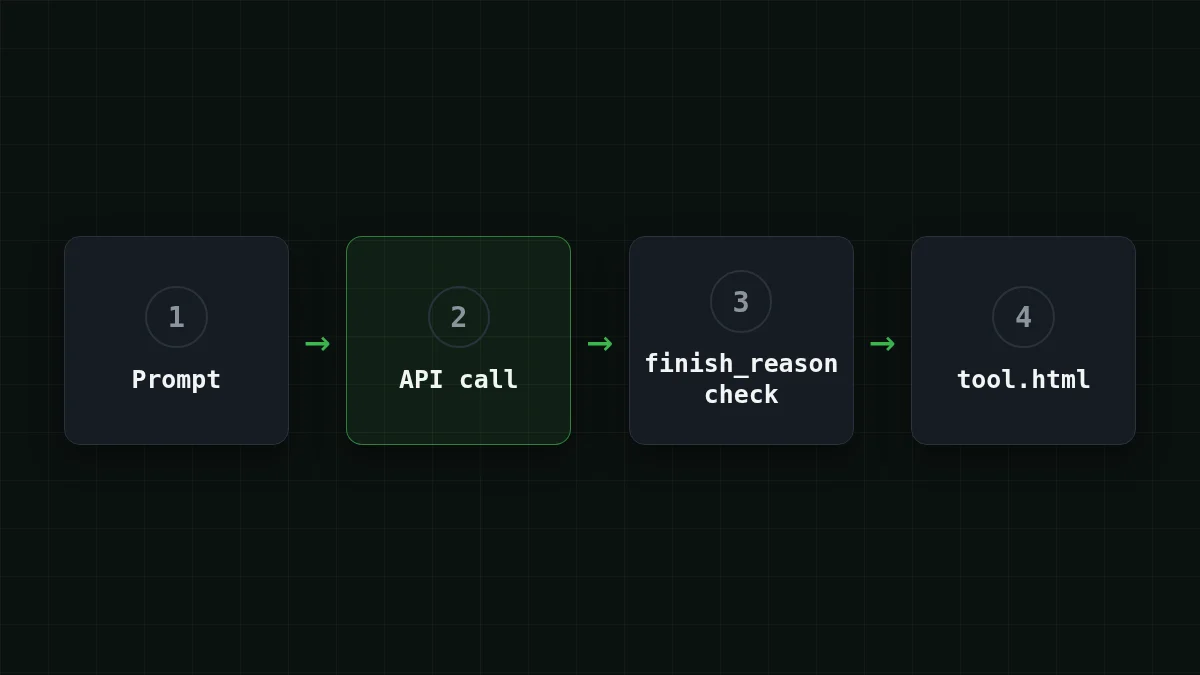
चरणों का क्रम मायने रखता है, और इसे गलत करना आसान है:
क्रम में लगाएँ
स्क्रिप्ट के चरणों को उसी क्रम में रखें जिस क्रम में वह उन्हें चलाती है
आइटम खींचें या तीरों का उपयोग करें
- उदार max_tokens के साथ प्रॉम्प्ट भेजें
- टेक्स्ट को छूने से पहले finish_reason जाँचें
- कोड फ़ेंस से HTML निकालें, यदि कोई हो
- पुष्टि करें कि समापन </html> मौजूद है
- tool.html सहेजें और उपयोग प्रिंट करें
max_tokens यह कैसे तय करता है कि पेज काम करेगा या नहीं#
एक पूर्ण इंटरैक्टिव पेज एक लंबा उत्तर है। HTML, CSS और JavaScript जल्दी जुड़ जाते हैं, और मॉडल उन्हें उसी क्रम में लिखता है: यदि उत्तर कट जाए, तो आप पहले स्क्रिप्ट का अंत खो देते हैं, जो ठीक वही हिस्सा है जो बटनों को काम कराता है। ब्राउज़र फिर भी पेज खोल सकता है। यह बस कुछ नहीं करता।
इसीलिए स्क्रिप्ट टेक्स्ट देखने से पहले finish_reason जाँचती है। stop का अर्थ है कि मॉडल ने स्वयं समाप्त किया। length का अर्थ है कि यह फ़ाइल के बीच में max_tokens सीमा पर पहुँच गया। इस समस्या का सामान्य संस्करण AI उत्तर कट गया? finish_reason length ठीक करें में शामिल है; यहाँ नियम संक्षिप्त है: ऐसा पेज कभी न सहेजें जिसका finish_reason length हो।
यदि आप इसे देखते हैं:
max_tokensबढ़ाएँ (DeepSeek-V4-Flash प्रति उत्तर 32,768 तक की अनुमति देता है);- या कम माँगें: कम नियंत्रण, एक स्क्रीन, कोई एनिमेशन नहीं;
- GLM-5.3-Flash (
zai-) पर सीमा 8,192 आउटपुट टोकन है, इसलिए वह मॉडल छोटे टूल के लिए उपयुक्त है, जैसे ऊपर दिया गया कनवर्टर।org/ GLM- 5. 3- Flash
दूसरी जाँच, टेक्स्ट में </html>, उस शांत विफलता को पकड़ती है जहाँ मॉडल फ़ाइल पूरी किए बिना विनम्रता से उत्तर समाप्त कर देता है। max_tokens सेट करने से मॉडल अधिक भी नहीं लिखता: यह केवल एक सीमा है, और आप वास्तव में उत्पन्न टोकन के लिए भुगतान करते हैं (इस पर अधिक आउटपुट टोकन कम करें में)।
त्वरित जाँच
स्क्रिप्ट ने finish_reason = length प्रिंट किया। आप क्या करते हैं?
उत्तर दिखाएँ
उत्तर: इसे न सहेजें; max_tokens बढ़ाएँ या अनुरोध छोटा करें
length का अर्थ है कि उत्तर सीमा पर काटा गया, इसलिए स्क्रिप्ट का अंत गायब है। कम सीमा कटौती को जल्दी लाती है।
इसे खोलें और पेज देखें#
tool.html को डबल-क्लिक करके खोलें, या टर्मिनल से: macOS पर open tool.html, Linux पर xdg-, Windows पर start tool.html।
यह मॉडल द्वारा आपके लिए लिखा गया कोड है, इसलिए इस पर भरोसा करने से पहले एक मिनट बिताएँ। ब्राउज़र के डेवलपर टूल (F12) खोलें, Network टैब देखें और पुनः लोड करें: "no external requests" बाधा के साथ यह खाली रहना चाहिए। फिर अपने प्रॉम्प्ट के "Controls" भाग से प्रत्येक नियंत्रण को एक बार क्लिक करें।
यदि कुछ गड़बड़ है, तो शुरू से पुनः उत्पन्न न करें। प्रॉम्प्ट में विशिष्ट बात के बारे में एक वाक्य जोड़ें ("स्वैप बटन को दोनों मानों को भी स्वैप करना चाहिए") और फिर से चलाएँ। DeepSeek का अपना पेज बताता है कि इसके कुछ डेमो कई बातचीत दौर में परिष्कृत किए गए थे, इसलिए दूसरा पास सामान्य है।
स्वयं आज़माएँइसे आज़माएँ: कनवर्टर के लिए आप Network टैब में क्या देखने की अपेक्षा करते हैं?उत्तर दिखाएँ
कुछ नहीं: पेज एक सिंगल फ़ाइल है जिसमें इनलाइन CSS और JavaScript है, इसलिए पहली लोड के बाद कोई और अनुरोध नहीं होते। यदि आप किसी CDN के लिए अनुरोध देखते हैं, तो मॉडल ने बाधा को अनदेखा किया; इसे प्रॉम्प्ट में बड़े अक्षरों में जोड़ें और फिर से चलाएँ।
एक जनरेशन की लागत#
मान लें कि प्रॉम्प्ट लगभग 600 इनपुट टोकन है और तैयार पेज लगभग 6,000 आउटपुट टोकन है (मध्यम आकार के टूल के लिए एक अनुमान; आपकी अपनी usage पंक्ति वास्तविक संख्याएँ दिखाएगी)। DeepSeek-V4-Flash पर एक रन $0.00061 है, और GLM-5.3-Flash पर $0.00025। दोनों वर्तमान मूल्य सूची से लाइव संख्याएँ हैं, और कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, दोनों OpenRouter से सस्ते हैं।
| मॉडल | इनपुट $/1M | आउटपुट $/1M | लागत | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
कुल 600 इनपुट और 6,000 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
व्यवहार में आपको टूल पहली कोशिश में सही नहीं मिलेगा, इसलिए पुनरावृत्तियों में सोचें: प्रॉम्प्ट के दस ट्वीक उस पंक्ति का दस गुना हैं, फिर भी एक ऐसे टूल के लिए छोटी राशि है जिसे आप अन्यथा हाथ से लिखते। इसका लगभग सारा हिस्सा आउटपुट पक्ष है, पेज स्वयं, इसीलिए माँग को छोटा करना (कम नियंत्रण) उत्तर और बिल दोनों को छोटा करता है।
यदि यह काम न करे#
तालिका को दाईं ओर स्क्रॉल करें →
| आप क्या देखते हैं | संभावित कारण | क्या करें |
|---|---|---|
API से 401 या 404 |
गलत कुंजी, बेस URL या मॉडल आईडी | तीनों की जाँच करें, देखें API 401 या 404 त्रुटि |
Cut off at max_ |
पेज सीमा से लंबा | max_tokens बढ़ाएँ या कम माँगें |
The reply has no closing </ |
मॉडल जल्दी रुक गया या टेक्स्ट जोड़ा | फिर से चलाएँ; प्रॉम्प्ट में "end with </html>" जोड़ें |
| पेज खुलता है लेकिन बटन कुछ नहीं करते | JavaScript त्रुटि | कंसोल खोलें (F12), लाल त्रुटि को फ़ॉलो-अप प्रॉम्प्ट में पेस्ट करें |
यदि आप मॉडल के उत्तर को पेज के बजाय डेटा के रूप में पार्स करना चाहते हैं, तो निष्कर्षण चाल वही है जो LLM उत्तर पर json.JSONDecodeError में है। API में नए हैं? अपने पहले API अनुरोध से शुरू करें।


