API и SDKИнструкция
HTML-инструмент из одного промпта через API на Python
Скрипт на Python: один промпт превращается в рабочий tool.html, обрезанный ответ ловится по finish_reason, а токены и стоимость печатаются.
Содержание
Рабочий инструмент в одном файле можно получить одним запросом к API: отправляете хорошо составленный промпт, ставите max_tokens с запасом на целую страницу, проверяете, что finish_reason равен stop, и сохраняете ответ как tool.html. Ниже — скрипт, который делает ровно это, и шаблон промпта, который вы подгоните под свою задачу.
Идея простая, и DeepSeek только что её показал: он опубликовал подборку из семи демо-промптов для Creator Mode в DeepSeek Harness (страница, проверена 3 ноября 2026): 3D-галерея достопримечательностей, мастерская постеров, видеоредактор, читалка статей, панель со статистикой разговоров и другие. Creator Mode работает внутри приложения Harness. Если вам нужен тот же ход «промпт на входе — инструмент на выходе» в своём скрипте и со своим ключом, для случая с одним файлом хватит обычного chat completion. А если пользуетесь самим Harness, то подключение к CheapTokens разобрано в отдельной короткой инструкции.
Что нужно в промпте «сделай мне инструмент»#
Прочитайте несколько демо-промптов, и закономерность видна. В каждом сказано, что это за инструмент, что на экране, что делают элементы управления, каким всё выглядит в начале и чего делать нельзя. Пропустите любой пункт — и модель заполнит пробел своей догадкой, а она обычно не ваша.
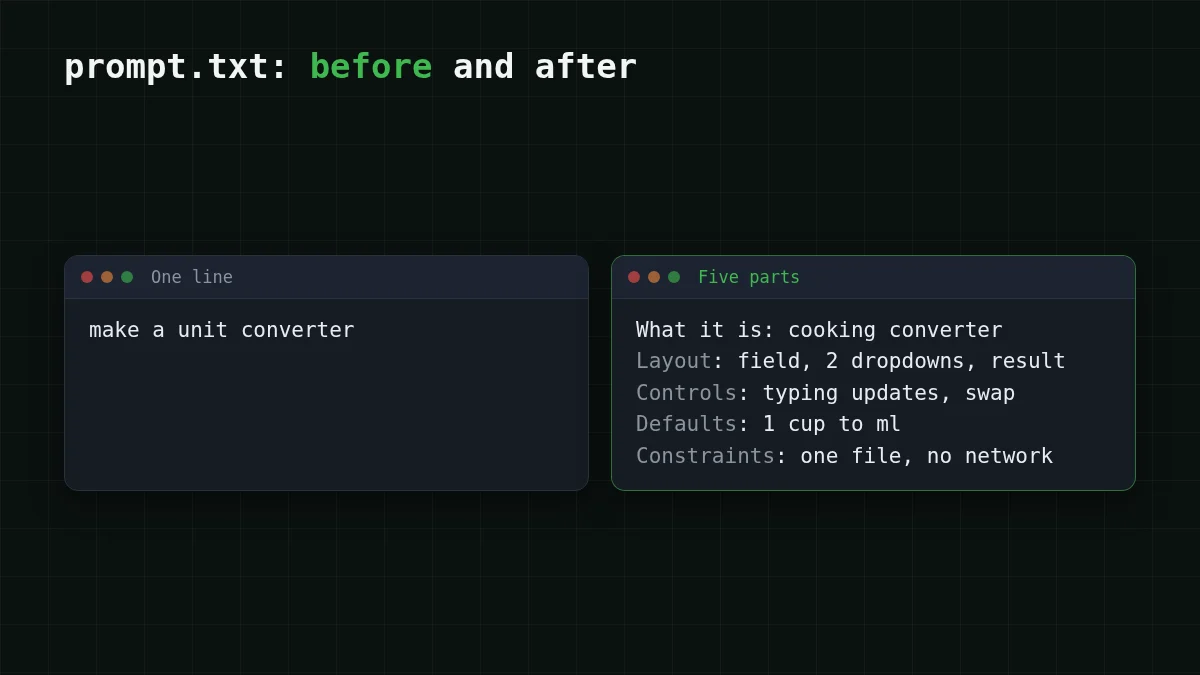
Шаблон из пяти частей:
Что это: <одно предложение: инструмент и кто им пользуется>
Экран: <что на экране сверху вниз>
Управление: <каждое поле и кнопка, и что они делают>
По умолчанию: <что показано, пока пользователь ничего не трогал>
Ограничения: <один HTML-файл, без внешних запросов, без библиотек, размер страницы>
И заполненный вариант. Допустим, вы постоянно пересчитываете кулинарные меры и устали искать конвертер:
Что это: конвертер кулинарных единиц для человека, который стоит на кухне с телефоном.
Экран: заголовок, одно числовое поле, два выпадающих списка (из чего, во что), под ними крупная строка с результатом.
Управление: в списках стакан, столовая ложка, чайная ложка, мл, унция, г (мука) и г (сахар). Ввод числа сразу обновляет результат. Кнопка «поменять» меняет списки местами.
По умолчанию: 1 стакан в мл, результат уже показан.
Ограничения: один HTML-файл с CSS и JavaScript внутри, без внешних библиотек, шрифтов и сетевых запросов, удобно на узком экране телефона, тёмный текст на светлом фоне.
Сохраните это как prompt.txt рядом со скриптом. Больше всего весит строка «Ограничения»: без «без внешних запросов» модель охотно подтягивает библиотеку с CDN, и страница ломается без интернета.
Скрипт: запрос, проверка, сохранение#
API CheapTokens совместим с OpenAI Chat Completions по адресу https:/, поэтому пакет openai работает с двумя заменами: адрес и ключ. Для целой страницы берём deepseek-: до 32 768 токенов в одном ответе и контекст 380K. Подробности API — в документации CheapTokens.
Установите пакет, положите ключ в переменную окружения и задайте две цены из таблицы цен (скрипт использует их, чтобы напечатать стоимость):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<цена входа за 1M из таблицы>"
export PRICE_OUT_PER_M="<цена выхода за 1M из таблицы>"
И сам make_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
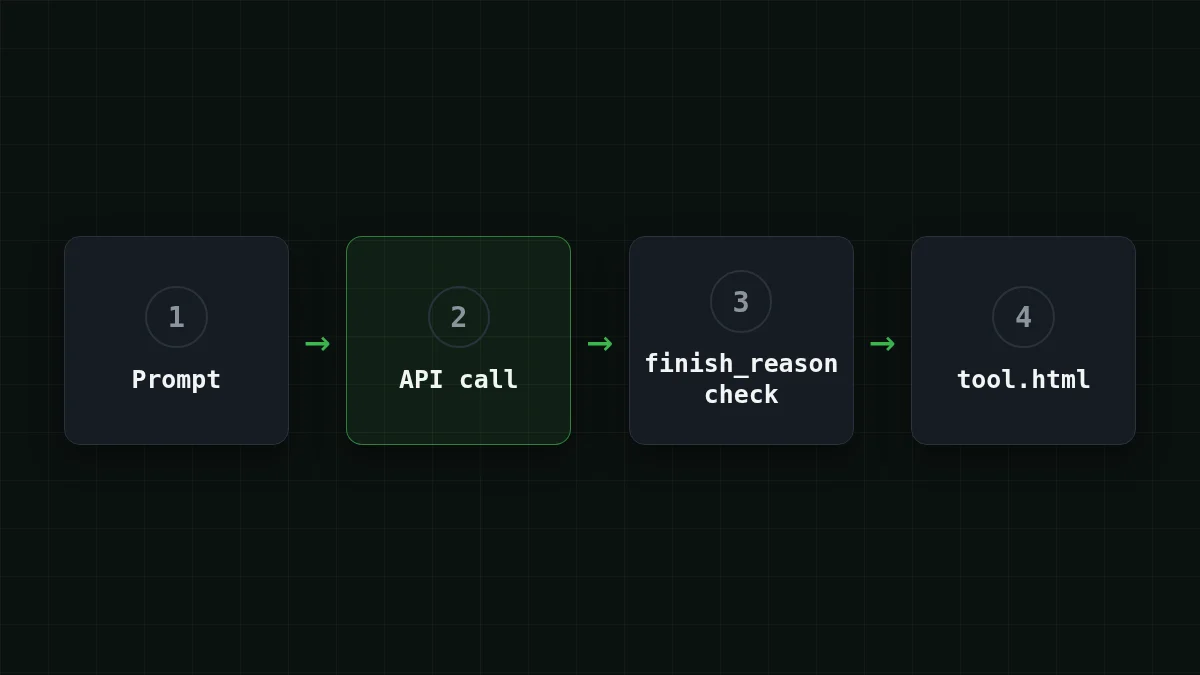
Порядок шагов важен, и в нём легко ошибиться:
Расставьте по порядку
Расставьте шаги скрипта в том порядке, в котором он их выполняет
Перетащите элементы или используйте стрелки
- Отправить промпт с запасом max_tokens
- Проверить finish_reason, пока не трогали текст
- Вытащить HTML из блока кода, если он есть
- Убедиться, что есть закрывающий </html>
- Сохранить tool.html и напечатать usage
Почему от max_tokens зависит, заработает ли страница#
Целая интерактивная страница — длинный ответ. HTML, CSS и JavaScript набегают быстро, и модель пишет их именно в таком порядке: если ответ обрезан, первым пропадает конец скрипта, а это как раз то, что оживляет кнопки. Браузер страницу, возможно, откроет. Просто ничего не будет происходить.
Поэтому скрипт смотрит на finish_reason раньше, чем на текст. stop — модель закончила сама. length — она упёрлась в потолок max_tokens посреди файла. Общий случай разобран в статье ответ обрывается: finish_reason length; здесь правило короткое: страницу с finish_reason равным length не сохраняйте.
Если увидели length:
- поднимите
max_tokens(DeepSeek-V4-Flash разрешает до 32 768 в одном ответе); - или попросите меньше: меньше элементов, один экран, без анимаций;
- у GLM-5.3-Flash (
zai-) потолок 8 192 токена ответа, поэтому она подходит для небольших инструментов вроде конвертера выше.org/ GLM- 5. 3- Flash
Вторая проверка, </html> в тексте, ловит тихий сбой: модель вежливо завершила ответ, не дописав файл. А сам max_tokens не заставляет модель писать больше: это только потолок, платите вы за реально выданные токены (подробнее — в статье как сократить выходные токены).
Быстрая проверка
Скрипт напечатал finish_reason = length. Что делать?
Показать ответ
Ответ: Не сохранять; поднять max_tokens или сократить запрос
length значит, что ответ оборвался на потолке, и конца скрипта нет. Более низкий потолок оборвёт ответ ещё раньше.
Откройте файл и посмотрите на страницу#
Откройте tool.html двойным щелчком или из терминала: open tool.html на macOS, xdg- на Linux, start tool.html на Windows.
Это код, который написала модель, так что минуту на проверку потратьте. Откройте инструменты разработчика (F12), вкладку Network, обновите страницу: при ограничении «без внешних запросов» там должно быть пусто. Затем один раз нажмите каждый элемент из части «Управление» вашего промпта.
Если что-то не так, не генерируйте всё заново. Добавьте в промпт одну фразу про конкретное место («кнопка «поменять» должна менять местами и значения») и запустите снова. На странице DeepSeek сказано, что часть демо дорабатывали за несколько раундов диалога, так что второй проход — это нормально.
Попробуйте самиПопробуйте: что вы ожидаете увидеть во вкладке Network для конвертера?Показать ответ
Ничего: страница — один файл с CSS и JavaScript внутри, после первой загрузки новых запросов нет. Если видите запрос к CDN, модель проигнорировала ограничение; допишите его в промпт заглавными буквами и запустите снова.
Сколько стоит одна генерация#
Допустим, промпт занимает около 600 токенов на входе, а готовая страница — около 6 000 на выходе (допущение для инструмента средней величины; настоящие числа покажет строка usage у вас). Один запуск на DeepSeek-V4-Flash — $0.00061, на GLM-5.3-Flash — $0.00025. Это живые числа из текущего прайса, и в сумме, с учётом входа и выхода, обе модели дешевле OpenRouter.
| Модель | Вход $/1M | Выход $/1M | Стоимость | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 входных и 6 000 выходных токенов всего. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
На практике с первого раза инструмент не получится, так что считайте итерациями: десять правок промпта — это десять таких строк, всё равно небольшая сумма за инструмент, который иначе пришлось бы писать руками. Почти всё приходится на выход, то есть на саму страницу, поэтому уменьшить запрос (меньше элементов) — значит сократить и ответ, и счёт.
Если не работает#
Прокрутите таблицу вправо →
| Что видите | Вероятная причина | Что делать |
|---|---|---|
401 или 404 от API |
неверный ключ, адрес или id модели | проверьте все три, см. ошибка API 401 или 404 |
Cut off at max_ |
страница длиннее потолка | поднимите max_tokens или попросите меньше |
The reply has no closing </ |
модель остановилась раньше или добавила текст | запустите снова; допишите в промпт «закончи файл тегом </html>» |
| Страница открылась, кнопки молчат | ошибка JavaScript | откройте консоль (F12), вставьте красную ошибку в следующий промпт |
Если ответ модели нужно разобрать как данные, а не как страницу, приём с извлечением тот же, что в ошибка JSONDecodeError на ответе модели. Только знакомитесь с API? Начните с первого запроса к API.


