APIとSDKガイド
API(Python)で1つのプロンプトからHTMLツールを生成する
1つのプロンプトを動作するtool.htmlに変え、finish_reasonで途中で切れた回答を検出し、トークンとコストを表示するPythonスクリプト。
このページの内容
1回のAPI呼び出しで、動作する単一ファイルのツールが手に入ります。よく構造化されたプロンプトを送り、max_tokensが1ページ全体に十分な大きさであることを確認し、finish_reasonがstopであることをチェックし、返答をtool.htmlとして保存します。以下に、まさにそれを行うスクリプトと、自分のツール向けに作り変えられるプロンプトテンプレートを示します。
考え方はシンプルで、DeepSeekがちょうどそれを示しました。DeepSeek HarnessのCreator Mode向けに7つのデモプロンプトを公開しています(ページは2026年11月3日確認):3Dランドマークギャラリー、ポスターワークベンチ、動画編集ワークベンチ、論文リーダー、会話統計ボードなどです。Creator ModeはHarnessアプリの中にあります。同じ「プロンプトを入れてツールを出す」流れを自分のスクリプトと自分のキーで実現したいなら、単一ファイルのケースでは通常のチャット補完で十分です。Harness自体を使う場合は、CheapTokensへの接続が別の短いガイドになっています。
「ツールを作って」プロンプトに必要なもの#
これらのデモプロンプトをいくつか読むと、パターンが見えてきます。それぞれが、ツールとは何か、画面に何があるか、コントロールが何をするか、初期状態はどうか、そして何をしてはいけないかを述べています。どれか1つを省くと、モデルは自分の推測でその隙間を埋めますが、それはたいていあなたの意図とは違います。
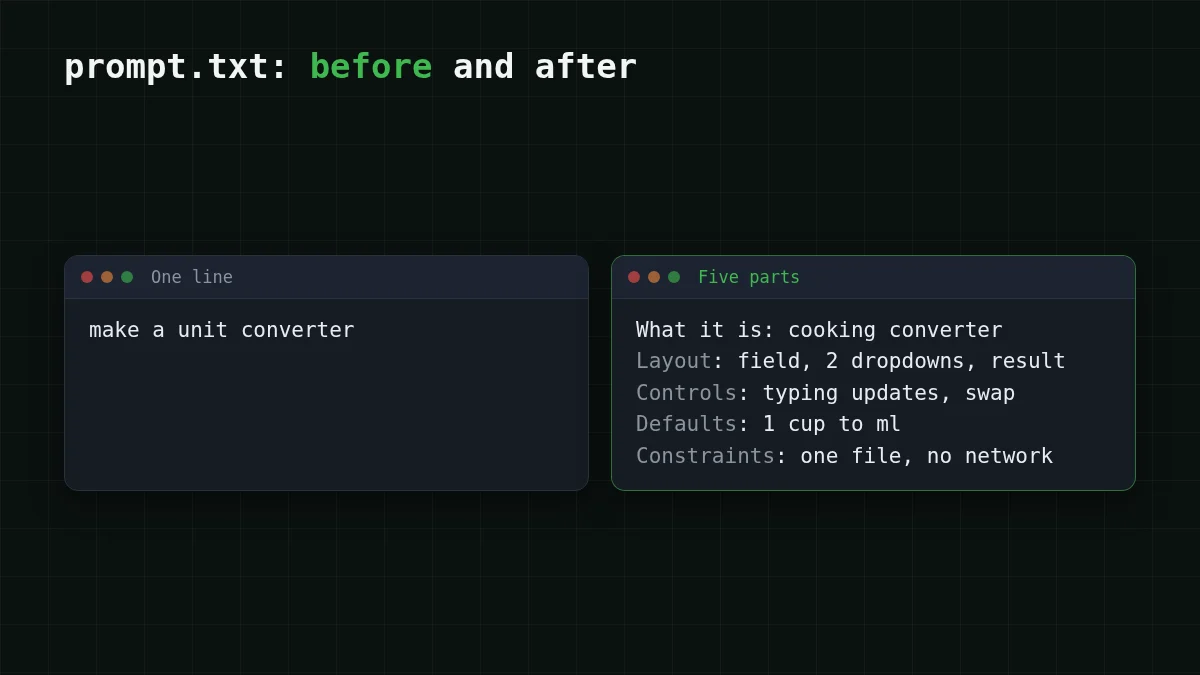
テンプレートは5つのパートです:
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
そして記入済みのバージョン。料理の計量単位をよく変換していて、コンバーターを検索するのにうんざりしているとします:
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.それをスクリプトの隣にprompt.txtとして保存します。「Constraints」の行が最も重要な役割を担います。「外部リクエストなし」がないと、モデルはCDNライブラリを読み込みたがり、ページはオフラインで壊れます。
スクリプト:リクエスト、チェック、保存#
CheapTokens APIはhttps:/でOpenAI Chat Completions互換なので、openaiパッケージは2つの変更で動きます:ベースURLとキーです。ページ全体にはdeepseek-を使います:回答あたり最大32,768出力トークンを許容し、380Kのコンテキストウィンドウを持ちます。APIの詳細はCheapTokensドキュメントにあります。
パッケージをインストールし、キーを環境変数に入れ、料金表から2つの価格を設定します(スクリプトはコストを表示するためにこれらを使います):
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"次にmake_tool.py:
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
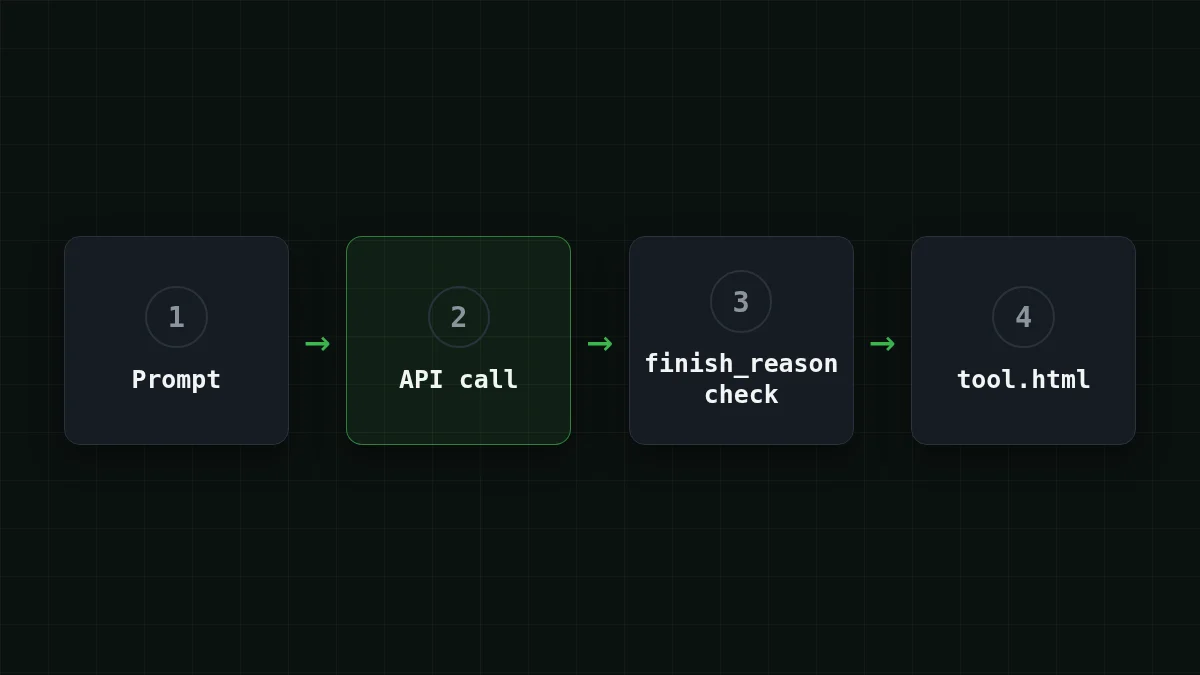
ステップの順序は重要で、間違えやすいです:
順番に並べる
スクリプトのステップを実行順に並べる
項目をドラッグするか矢印を使う
- 余裕のあるmax_tokensでプロンプトを送る
- テキストに触れる前にfinish_reasonをチェックする
- コードフェンスがあれば、そこからHTMLを取り出す
- 閉じタグの</html>があることを確認する
- tool.htmlを保存し、使用量を表示する
max_tokensがページの動作を決める理由#
完全なインタラクティブページは長い回答です。HTML、CSS、JavaScriptはすぐに積み上がり、モデルはその順に書きます:回答が切れると、まずスクリプトの末尾を失いますが、それはまさにボタンを動かす部分です。ブラウザはページを開けるかもしれません。ただ何も起きません。
だからこそスクリプトはテキストを見る前にfinish_reasonをチェックします。stopはモデルが自力で終えたことを意味します。lengthはファイルの途中でmax_tokensの上限に達したことを意味します。この問題の一般的な版はAIの回答が途中で切れた? finish_reason lengthを修正で扱っています;ここでのルールは短く:finish_reasonがlengthであるページは決して保存しないことです。
もしそれが見えたら:
max_tokensを上げる(DeepSeek-V4-Flashは回答あたり最大32,768を許容);- またはより少なく求める:コントロールを減らす、1画面、アニメーションなし;
- GLM-5.3-Flash(
zai-)では上限は8,192出力トークンなので、そのモデルは上のコンバーターのような小さなツールに向いています。org/ GLM- 5. 3- Flash
2つ目のチェック、テキスト内の</html>は、モデルがファイルを完成させずに丁寧に返答を終える、より静かな失敗を捕まえます。max_tokensを設定してもモデルがより多く書くわけではありません:それは単なる上限であり、実際に生成されたトークンに対して支払います(詳細は出力トークンを削減)。
クイックチェック
スクリプトがfinish_reason = lengthを表示しました。どうしますか?
答えを表示
答え: 保存しない;max_tokensを上げるかリクエストを小さくする
lengthは回答が上限で切れたことを意味するので、スクリプトの末尾が欠けている。上限を下げると切れが早く来る。
開いてページを見る#
tool.htmlをダブルクリックで開くか、ターミナルから:macOSではopen tool.html、Linuxではxdg-、Windowsではstart tool.html。
これはモデルがあなたのために書いたコードなので、信頼する前に1分費やしてください。ブラウザの開発者ツール(F12)を開き、Networkタブを見てリロードします:「外部リクエストなし」の制約があれば空のままのはずです。次に、プロンプトの「Controls」パートにあるすべてのコントロールを1回ずつクリックします。
何かおかしければ、ゼロから再生成しないでください。特定の事柄について1文をプロンプトに加え(「swapボタンは2つの値も入れ替えなければならない」)、再度実行します。DeepSeek自身のページは、デモのいくつかが複数回の会話ラウンドで洗練されたと述べているので、2回目のパスは普通のことです。
自分で試す試してみよう:コンバーターでNetworkタブに何が表示されると思いますか?答えを表示
何も表示されない:ページはインラインCSSとJavaScriptを持つ単一ファイルなので、最初の読み込み後にそれ以上のリクエストはありません。CDNへのリクエストが見えたら、モデルは制約を無視しています;プロンプトに大文字で追加して再度実行してください。
1回の生成にかかるコスト#
プロンプトが約600入力トークンで、完成したページが約6,000出力トークンだとします(中規模ツールの仮定;実際の数値はあなた自身のusage行に表示されます)。DeepSeek-V4-Flashでの1回の実行は$0.00061、GLM-5.3-Flashでは$0.00025です。どちらも現在の価格表からの実際の数値で、入力と出力を合計すると、どちらもOpenRouterより安いです。
| モデル | 入力 $/1M | 出力 $/1M | コスト | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
合計 600 入力トークンと 6,000 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
実際にはツールを一発で正しく作れることはないので、イテレーションで考えてください:プロンプトの10回の調整はその行の10倍で、それでも手書きするようなツールとしては小さな額です。ほとんどは出力側、つまりページ自体なので、要求を小さくする(コントロールを減らす)と回答と請求が短くなります。
うまくいかない場合#
テーブルを右にスクロールしてください →
| 表示されるもの | 考えられる原因 | 対処法 |
|---|---|---|
APIからの401または404 |
キー、ベースURL、モデルIDが間違っている | 3つを確認、API 401または404エラーを参照 |
Cut off at max_ |
ページが上限より長い | max_tokensを上げるか、より少なく求める |
The reply has no closing </ |
モデルが早く止まった、またはテキストを追加した | 再度実行;プロンプトに「</html>で終える」を追加 |
| ページは開くがボタンが何もしない | JavaScriptエラー | コンソール(F12)を開き、赤いエラーをフォローアッププロンプトに貼り付ける |
モデルの返答をページではなくデータとして解析したい場合、抽出のコツはjson.JSONDecodeError on an LLM replyと同じです。APIが初めてなら、最初のAPIリクエストから始めてください。


