API & SDKGuide
Générer un outil HTML à partir d'un prompt avec une API (Python)
Un script Python qui transforme un prompt en un tool.html fonctionnel, détecte une réponse tronquée via finish_reason, et affiche les tokens et le coût.
Sur cette page
Vous pouvez obtenir un outil fonctionnel en un seul fichier à partir d'un seul appel API : envoyez un prompt bien structuré, assurez-vous que max_tokens est suffisamment grand pour une page entière, vérifiez que finish_reason vaut stop, et enregistrez la réponse sous tool.html. Voici le script qui fait exactement cela, et un modèle de prompt que vous pouvez adapter à votre propre outil.
L'idée est simple, et DeepSeek vient de le montrer. Il a publié une collection de sept prompts de démonstration pour le Creator Mode dans DeepSeek Harness (la page, consultée le 3 novembre 2026) : une galerie de monuments 3D, un atelier d'affiches, un atelier de montage vidéo, un lecteur d'articles, un tableau de statistiques de conversation et quelques autres. Le Creator Mode vit à l'intérieur de l'application Harness. Si vous voulez le même flux « prompt en entrée, outil en sortie » dans votre propre script et avec votre propre clé, une simple complétion de chat suffit pour le cas du fichier unique. Si vous utilisez Harness lui-même, le connecter à CheapTokens fait l'objet d'un guide court séparé.
Ce dont a besoin un prompt « construis-moi un outil »#
Lisez quelques-uns de ces prompts de démonstration et un schéma apparaît. Chacun dit ce qu'est l'outil, ce qui est à l'écran, ce que font les contrôles, quel est l'état initial, et ce qu'il ne doit pas faire. Omettez l'un de ces éléments et le modèle comble le vide avec sa propre supposition, qui n'est généralement pas la vôtre.
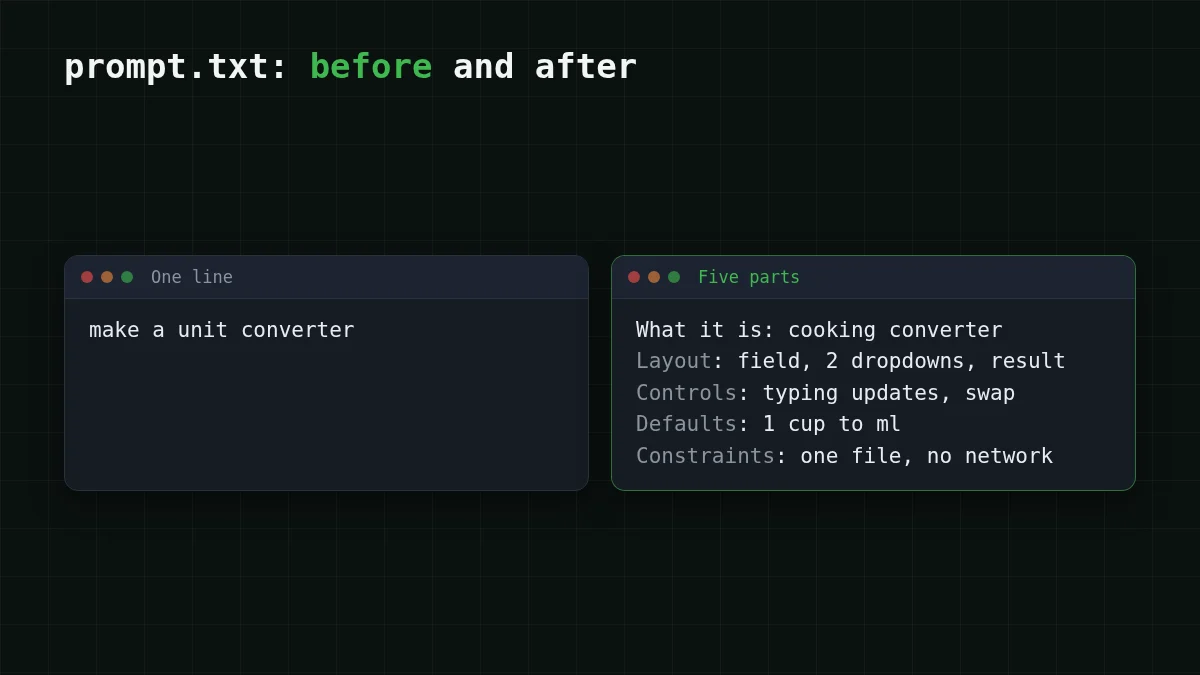
Voici le modèle, en cinq parties :
What it is: <one sentence: the tool and who uses it>
Layout: <what is on the screen, top to bottom>
Controls: <every input and button, and what each one does>
Defaults: <what the page shows before the user touches anything>
Constraints: <single HTML file, no external requests, no libraries, size of the page>
Et une version remplie. Disons que vous convertissez sans cesse des mesures de cuisine et que vous en avez assez de chercher un convertisseur :
What it is: a unit converter for cooking, for someone standing in a kitchen with a phone.
Layout: a title, one number field, two dropdowns (from, to), a large result line under them.
Controls: the dropdowns hold cup, tablespoon, teaspoon, ml, oz, g (flour) and g (sugar). Typing a number updates the result immediately. A swap button exchanges the two dropdowns.
Defaults: 1 cup to ml, result already shown.
Constraints: one HTML file with inline CSS and JavaScript, no external libraries, fonts or network requests, works on a narrow phone screen, dark text on a light background.
Enregistrez cela sous prompt.txt à côté du script. La ligne « Constraints » porte l'essentiel du poids : sans « no external requests », le modèle aime charger une bibliothèque depuis un CDN, et la page casse alors hors ligne.
Le script : requête, vérification, enregistrement#
L'API CheapTokens est compatible avec OpenAI Chat Completions à l'adresse https:/, donc le paquet openai fonctionne avec deux changements : l'URL de base et la clé. Pour une page entière, nous utilisons deepseek- : il autorise jusqu'à 32 768 tokens de sortie par réponse et dispose d'une fenêtre de contexte de 380K. Les détails complets de l'API sont dans la documentation CheapTokens.
Installez le paquet, placez votre clé dans une variable d'environnement, et définissez les deux prix depuis le tableau des tarifs (le script les utilise pour afficher le coût) :
pip install openai
export CHEAPTOKENS_API_KEY="your-key"
export PRICE_IN_PER_M="<input price per 1M from the table>"
export PRICE_OUT_PER_M="<output price per 1M from the table>"
Puis make_tool.py :
import os
import re
import sys

from openai import OpenAI

MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
PRICE_IN = float(os.environ['PRICE_IN_PER_M'])    # USD per 1M input tokens (from the table)
PRICE_OUT = float(os.environ['PRICE_OUT_PER_M'])  # USD per 1M output tokens (from the table)
FENCE = '`' * 3

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

prompt = open('prompt.txt', encoding='utf-8').read()

resp = client.chat.completions.create(
    model=MODEL,
    max_tokens=16000,
    messages=[
        {'role': 'system', 'content': 'You write one self-contained HTML file. Reply with the file only, no commentary.'},
        {'role': 'user', 'content': prompt},
    ],
)

choice = resp.choices[0]
if choice.finish_reason == 'length':
    sys.exit('Cut off at max_tokens: the page is unfinished. Raise max_tokens or shrink the request.')

text = choice.message.content or ''
m = re.search(FENCE + r'(?:html)?\s*(.*?)' + FENCE, text, re.DOTALL)
html = (m.group(1) if m else text).strip()
if '</html>' not in html.lower():
    sys.exit('The reply has no closing </html>; not saving it.')

with open('tool.html', 'w', encoding='utf-8') as f:
    f.write(html)

u = resp.usage
cost = (u.prompt_tokens * PRICE_IN + u.completion_tokens * PRICE_OUT) / 1_000_000
print(f'saved tool.html, {u.prompt_tokens} in / {u.completion_tokens} out, about ${cost:.6f}')
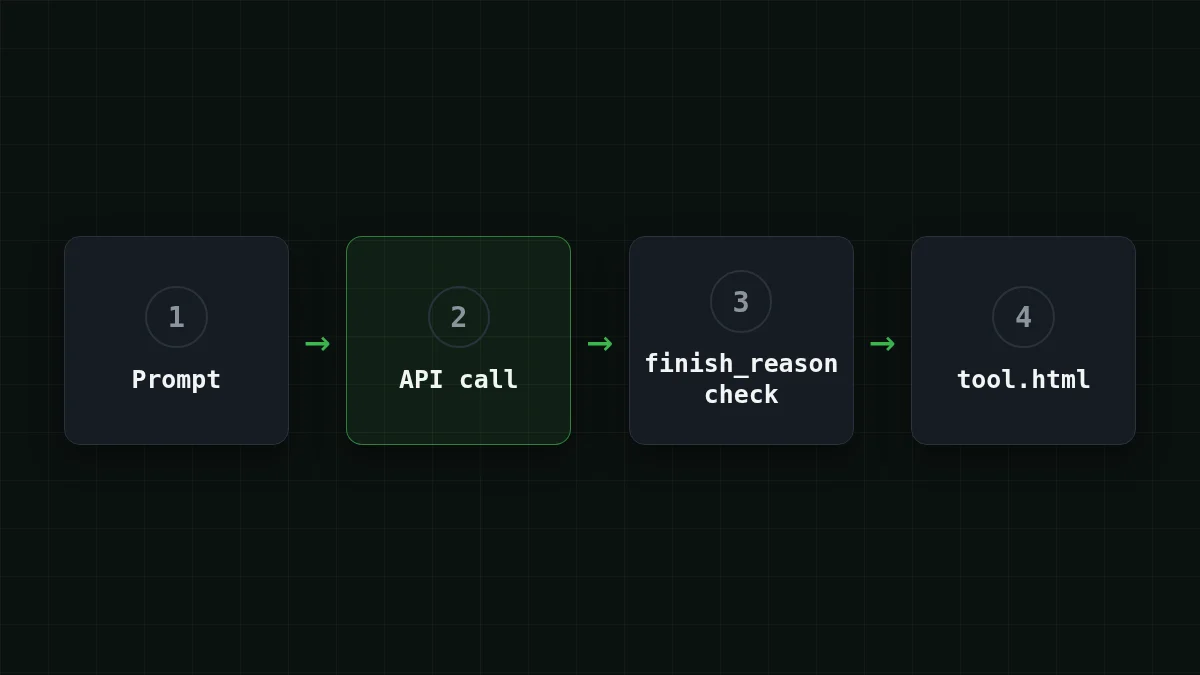
L'ordre des étapes compte, et il est facile de se tromper :
Remettre en ordre
Remettez les étapes du script dans l'ordre où il les exécute
Faites glisser les éléments ou utilisez les flèches
- Envoyer le prompt avec un max_tokens généreux
- Vérifier finish_reason avant de toucher au texte
- Extraire le HTML du bloc de code, s'il y en a un
- Confirmer que la balise fermante </html> est présente
- Enregistrer tool.html et afficher l'usage
Pourquoi max_tokens décide si la page fonctionne#
Une page interactive complète est une longue réponse. HTML, CSS et JavaScript s'additionnent vite, et le modèle les écrit dans cet ordre : si la réponse est coupée, vous perdez d'abord la fin du script, qui est précisément la partie qui fait fonctionner les boutons. Le navigateur peut quand même ouvrir la page. Elle ne fait simplement rien.
C'est pourquoi le script vérifie finish_reason avant de regarder le texte. stop signifie que le modèle a terminé de lui-même. length signifie qu'il a atteint le plafond max_tokens en plein fichier. La version générale de ce problème est traitée dans Réponse IA coupée ? Corriger finish_reason length ; ici la règle est courte : n'enregistrez jamais une page dont finish_reason vaut length.
Si vous le voyez quand même :
- augmentez
max_tokens(DeepSeek-V4-Flash autorise jusqu'à 32 768 par réponse) ; - ou demandez moins : moins de contrôles, un seul écran, pas d'animations ;
- sur GLM-5.3-Flash (
zai-) le plafond est de 8 192 tokens de sortie, donc ce modèle convient aux petits outils, comme le convertisseur ci-dessus.org/ GLM- 5. 3- Flash
La seconde vérification, </html> dans le texte, attrape l'échec plus discret où un modèle termine poliment la réponse sans finir le fichier. Définir max_tokens ne fait pas non plus écrire davantage au modèle : ce n'est qu'un plafond, et vous payez les tokens réellement produits (plus à ce sujet dans Réduire les tokens de sortie).
Vérification rapide
Le script a affiché finish_reason = length. Que faites-vous ?
Afficher la réponse
Réponse: Ne pas l'enregistrer ; augmenter max_tokens ou réduire la demande
length signifie que la réponse a été coupée au plafond, donc la fin du script manque. Un plafond plus bas fait arriver la coupure plus tôt.
Ouvrez-la et regardez la page#
Ouvrez tool.html en double-cliquant dessus, ou depuis le terminal : open tool.html sur macOS, xdg- sur Linux, start tool.html sur Windows.
C'est du code qu'un modèle a écrit pour vous, alors prenez une minute avant de lui faire confiance. Ouvrez les outils de développement du navigateur (F12), regardez l'onglet Network et rechargez : avec la contrainte « no external requests », il devrait rester vide. Ensuite, cliquez une fois sur chaque contrôle de la partie « Controls » de votre prompt.
Si quelque chose cloche, ne régénérez pas depuis zéro. Ajoutez une phrase au prompt sur le point précis (« le bouton d'échange doit aussi échanger les deux valeurs ») et relancez. La page de DeepSeek elle-même note que certaines de ses démos ont été affinées sur plusieurs tours de conversation, donc une seconde passe est normale.
Essayez vous-mêmeEssayez : que vous attendez-vous à voir dans l'onglet Network pour le convertisseur ?Afficher la réponse
Rien : la page est un fichier unique avec CSS et JavaScript en ligne, donc après le premier chargement il n'y a plus aucune requête. Si vous voyez une requête vers un CDN, le modèle a ignoré la contrainte ; ajoutez-la au prompt en majuscules et relancez.
Combien coûte une génération#
Disons que le prompt fait environ 600 tokens d'entrée et que la page finie fait environ 6 000 tokens de sortie (une hypothèse pour un outil de taille moyenne ; votre propre ligne usage affichera les vrais chiffres). Une exécution sur DeepSeek-V4-Flash coûte $0.00061, et sur GLM-5.3-Flash $0.00025. Ce sont tous deux des chiffres réels issus de la grille tarifaire actuelle, et au total, entrée et sortie comptées ensemble, les deux sont moins chers qu'OpenRouter.
| Modèle | Entrée $/1M | Sortie $/1M | Coût | OpenRouter |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00025 | $0.00052 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00061 | $0.00088 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00093 | $0.0112 |
600 tokens d'entrée et 6 000 tokens de sortie au total. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
En pratique, vous n'obtiendrez pas l'outil du premier coup, alors raisonnez en itérations : dix ajustements du prompt font dix fois cette ligne, toujours une petite somme pour un outil que vous auriez sinon écrit à la main. Presque tout se joue du côté de la sortie, la page elle-même, c'est pourquoi réduire la demande (moins de contrôles) raccourcit la réponse et la facture.
Si ça ne fonctionne pas#
Faites défiler le tableau vers la droite →
| Ce que vous voyez | Cause probable | Que faire |
|---|---|---|
401 ou 404 renvoyé par l'API |
mauvaise clé, URL de base ou id de modèle | vérifiez les trois, voir Erreur API 401 ou 404 |
Cut off at max_ |
page plus longue que le plafond | augmentez max_tokens ou demandez moins |
The reply has no closing </ |
le modèle s'est arrêté tôt ou a ajouté du texte | relancez ; ajoutez « terminer par </html> » au prompt |
| La page s'ouvre mais les boutons ne font rien | erreur JavaScript | ouvrez la console (F12), collez l'erreur en rouge dans un prompt de suivi |
Si vous voulez que la réponse du modèle soit analysée comme des données plutôt que comme une page, l'astuce d'extraction est la même que dans json.JSONDecodeError sur une réponse LLM. Nouveau sur l'API ? Commencez par votre première requête API.


