DépannageGuide
json.JSONDecodeError sur une réponse LLM : extraire le JSON en Python
json.loads échoue sur une réponse de modèle ? Lisez exc.pos et finish_reason pour trouver la cause, puis extrayez le JSON avec raw_decode et réessayez une fois.
Sur cette page
Votre script demande du JSON au modèle, appelle json. et meurt avec json.. En général, le modèle a bien répondu : il a enveloppé le JSON dans un ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder., et réessayez une fois si rien ne peut être sauvé.
Trois façons dont une réponse casse json.loads#
La documentation Python de json (docs Python 3.15, vérifiées le 2 novembre 2026) indique que JSONDecodeError est une sous-classe de ValueError avec les attributs msg, doc, pos, lineno et colno. Celui qui compte ici est pos : l'index dans la chaîne où l'analyse a échoué.
Supposons qu'un script extraie des champs d'e-mails clients et demande {"name": .. Ces trois chaînes sont les réponses qui le cassent. Collez-les dans un shell Python :
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Les deux premières échouent à pos 0 : l'analyseur a regardé le tout premier caractère, un backtick ou un S, et a abandonné. La troisième échoue à la fin de la chaîne (pos vaut len(reply)) : tout ce qu'il a lu était correct, puis le texte s'est arrêté. Cette différence est votre diagnostic. La position 0 signifie que le JSON est probablement là, juste enveloppé. La position à la fin signifie que la réponse s'est arrêtée trop tôt.
Réponses tronquées : vérifiez finish_reason avant d'analyser#
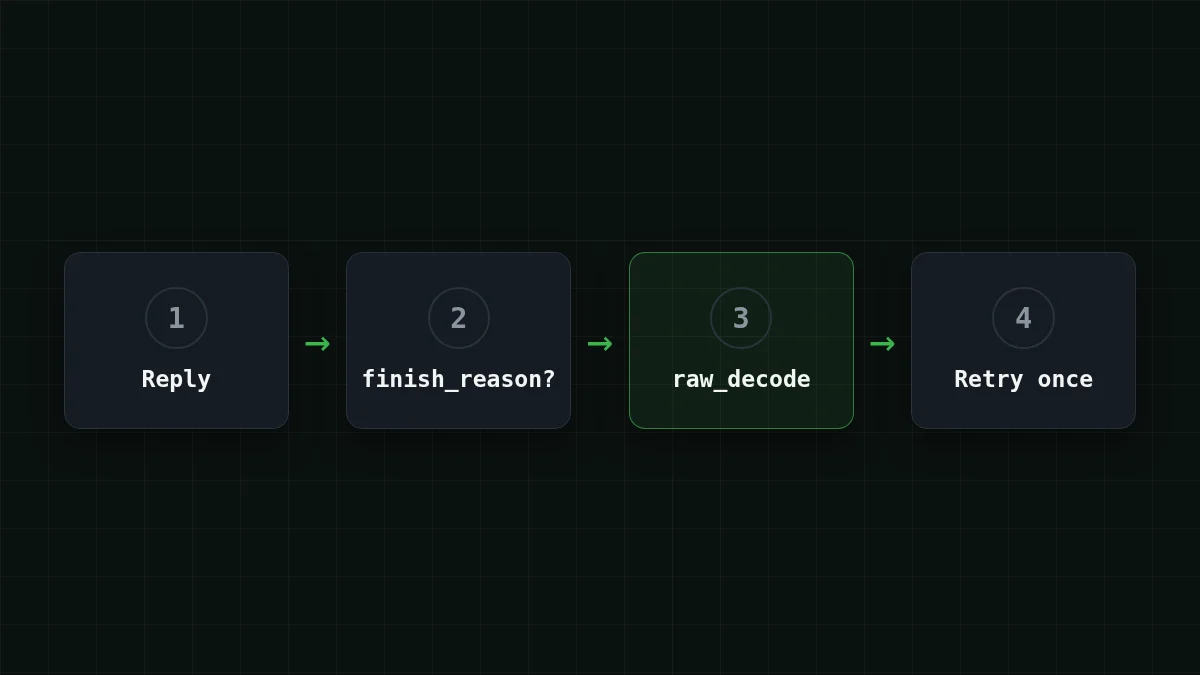
Une réponse qui s'arrête au milieu n'est pas un problème d'analyse, c'est un problème de longueur. L'API vous le dit : le choix a finish_reason, et "length" signifie que la réponse a été coupée par max_tokens (toute l'histoire est dans Réponse IA coupée ? Corriger finish_reason "length" et max_tokens). Regardez-le d'abord, avant toute extraction.
Il y a un piège vicieux si vous sautez cette étape. Un scanner qui cherche le premier { analysable peut récupérer un objet interne complet à partir d'un objet externe à moitié terminé, et votre script continue avec les mauvaises données sans erreur. Essayez :
Essayez vous-mêmeEssayez : que renvoie une fonction « trouver le premier objet » pour cette réponse coupée ?Afficher la réponse
Prenez '{"user": {"name": "Anna"}, "age": 31'. L'objet externe ne se ferme jamais, mais l'interne {"name": "Anna"} est complet, donc l'extracteur ci-dessous renvoie {'name': 'Anna'}. Aucune exception, résultat erroné. C'est pourquoi la vérification de finish_reason vient avant l'extraction.
Le correctif pour une vraie troncature est plus d'espace : augmentez max_tokens. DeepSeek-V4-Flash autorise jusqu'à 32 768 jetons de sortie par réponse, GLM-5.3-Flash jusqu'à 8 192, donc une longue liste JSON a plus de place sur le premier. Les détails des modèles sont sur la page des modèles CheapTokens.
Extraire le JSON du texte#
Pour les fences et le bavardage, la bibliothèque standard a déjà l'outil. Selon la même page Python, JSONDecoder. décode un document JSON à partir d'une chaîne qui commence par celui-ci et renvoie l'objet plus l'index où le document s'est terminé. La doc indique qu'il peut être utilisé sur une chaîne avec des données superflues à la fin. Il faut que le document commence au premier caractère, donc coupez d'abord le texte initial : cherchez un {, essayez de décoder à partir de là, et passez au { suivant si cela échoue.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
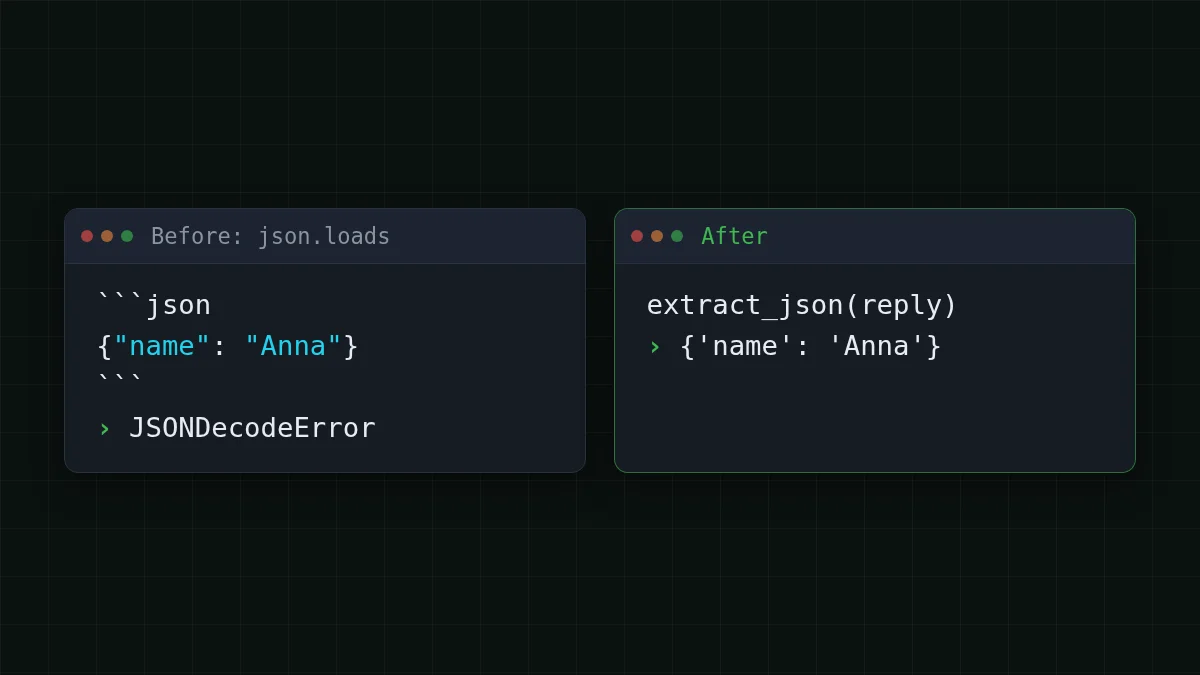
Il gère la fence (le ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] dans une phrase comme « voir note [1] » est du JSON valide et l'emporterait.
Deux choses qu'il ne fait délibérément pas. Il ne modifie jamais le texte (pas de regex qui supprime les backticks, pas de devinette sur les crochets manquants), donc vous ne pouvez pas transformer une réponse cassée en données valides mais fausses. Et il échoue bruyamment quand il n'y a rien à trouver, ce dont la nouvelle tentative ci-dessous a besoin.
Réessayer une fois avec un prompt plus strict#
Si la réponse a été coupée ou ne contient aucun objet, redemandez. Une fois, pas dans une boucle sans fin. Sur une troncature, donnez plus d'espace à la seconde tentative ; sinon, dites clairement ce que vous voulez. Cela utilise le SDK Python OpenAI contre l'URL de base CheapTokens (https:/) et l'identifiant complet du modèle issu de la doc ; la clé se trouve dans une variable d'environnement.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
L'ordre est le point clé : finish_reason d'abord, l'extraction ensuite, et seulement après une nouvelle tentative. Levez l'erreur après la seconde tentative pour qu'un job par lots puisse journaliser cet élément et continuer.
Le coût d'une nouvelle tentative est facile à estimer. Supposez une requête de 1 200 jetons d'entrée et 300 jetons de sortie (une hypothèse, utilisez vos propres chiffres) : $0.000048 sur DeepSeek-V4-Flash ou $0.000036 sur GLM-5.3-Flash. Si 30 requêtes sur 1 000 nécessitent la seconde tentative, la facture supplémentaire est de 30 × cette requête, $0.0014 sur DeepSeek-V4-Flash. Les prix sont en direct, ils proviennent de la liste de prix actuelle.
Remettre en ordre
Mettez les étapes de réparation dans l'ordre
Faites glisser les éléments ou utilisez les flèches
- Vérifier finish_reason : arrêtez-vous ici s'il indique length
- Trouver le premier { et couper le texte avant
- Décoder avec raw_decode et ignorer ce qui suit
- Si rien n'a été trouvé, réessayer une fois avec le prompt plus strict
Quel symptôme, quel correctif#
Les étapes ci-dessus tiennent dans votre tête jusqu'à la prochaine erreur bizarre. C'est la même chose qu'une table de correspondance : trouvez ce que vous voyez à l'écran et lisez le correctif.
Choisissez votre cas
Choisissez ce que vous voyez
Choisissez une option pour voir la réponse
json.loads échoue à pos 0
La réponse commence par une fence ou une phrase. Passez-la dans extract_json ; une nouvelle tentative n'est pas nécessaire.
pos est à la fin de la chaîne
La réponse s'est arrêtée trop tôt. Vérifiez finish_reason : si c'est length, augmentez max_tokens et redemandez.
L'erreur est quelque part au milieu
Le modèle a écrit lui-même du JSON cassé (une virgule manquante, une virgule finale, une guillemet non échappée). Ne le corrigez pas : réessayez une fois avec le prompt plus strict et journalisez la réponse si cela échoue encore.
json.loads fonctionne mais une clé manque
L'analyse est correcte, le contenu ne l'est pas. Listez les clés exactes dans le prompt et vérifiez-les dans le code après l'analyse.
L'API peut-elle forcer un JSON valide ?#
Parfois. Le guide des sorties structurées d'OpenAI documente deux modes : le mode JSON (type: json_), qui renvoie du JSON valide mais ne suit pas de schéma, et les Structured Outputs (type: json_, strict: true), qui le font ; OpenAI recommande le second quand c'est possible (source : developers.openai.com, vérifié le 2 novembre 2026). Ce sont les options propres à l'API d'OpenAI. Avant de compter sur response_format avec un autre endpoint, consultez la doc CheapTokens ; l'extraction et la nouvelle tentative ci-dessus fonctionnent avec de simples chat completions et ne nécessitent aucun paramètre spécial. Plus d'infos sur les options côté requête dans Obtenir du JSON valide d'une API LLM : response_format et nouvelles tentatives.
Avant de livrer l'analyseur, vérifiez quatre choses : finish_reason est lu avant l'analyse du texte, il n'y a qu'une seule nouvelle tentative (et le second échec est journalisé avec l'identifiant de l'élément), le code vérifie que les clés attendues existent après l'analyse, et max_tokens laisse de la place pour le plus long JSON que vous attendez.
La prochaine fois que json.loads est levée, affichez d'abord exc.pos et finish_reason. Ces deux nombres vous disent généralement ce qui s'est passé avant même de lire une ligne de la réponse.


