Rozwiązywanie problemówPrzewodnik
json.JSONDecodeError na odpowiedzi LLM: wyodrębnij JSON w Pythonie
json.loads zawodzi na odpowiedzi modelu? Odczytaj exc.pos i finish_reason, aby znaleźć przyczynę, a następnie wyodrębnij JSON za pomocą raw_decode i ponów raz.
Na tej stronie
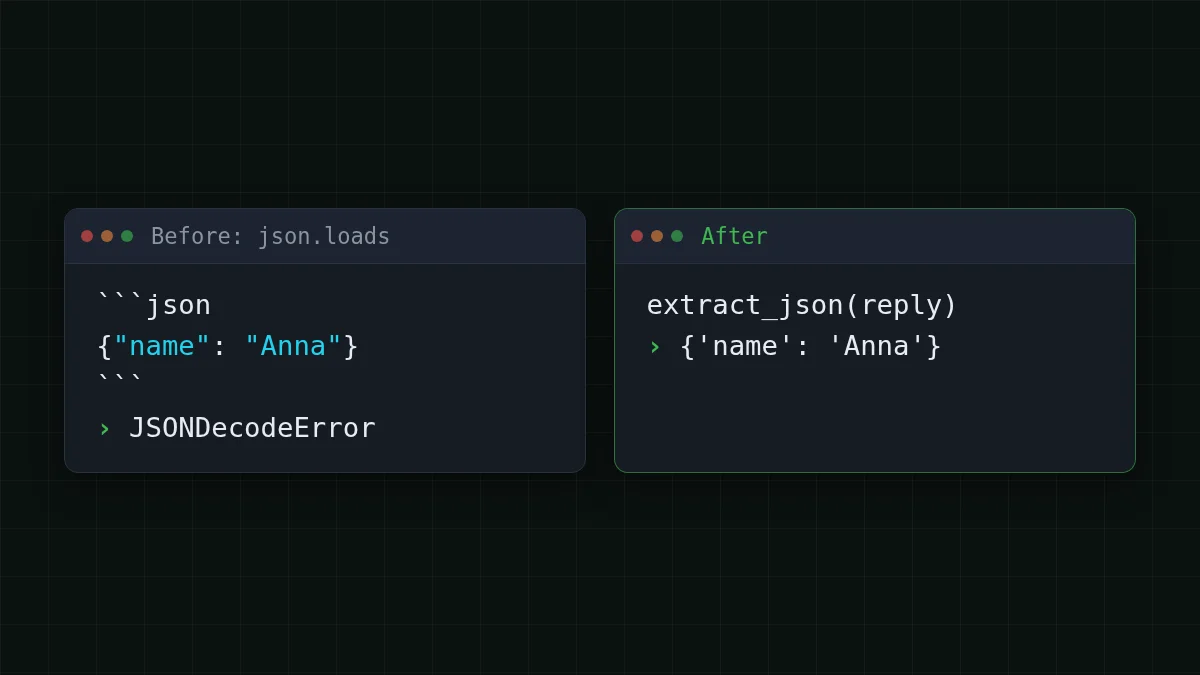
Twój skrypt prosi model o JSON, wywołuje json. i kończy się błędem json.. Zwykle model odpowiedział: opakował JSON w ```json fence, put a line of chat in front of it, or ran into max_tokens halfway through. Look at exc.pos and finish_reason to tell which one it is, pull the object out with JSONDecoder. i ponów próbę raz, jeśli nic nie da się uratować.
Trzy sposoby, w jakie odpowiedź psuje json.loads#
Dokumentacja Pythona dla json (dokumentacja Pythona 3.15, sprawdzona 2 listopada 2026) mówi, że JSONDecodeError jest podklasą ValueError z atrybutami msg, doc, pos, lineno i colno. Ten, który ma tu znaczenie, to pos: indeks w łańcuchu, na którym parsowanie się nie powiodło.
Załóżmy, że skrypt wyciąga pola z e-maili klientów i prosi o {"name": .. Te trzy łańcuchy to odpowiedzi, które go psują. Wklej je do powłoki Pythona:
import json

fenced = '```json\n{"name": "Anna", "age": 31}\n```'
chatty = 'Sure! Here is the JSON:\n{"name": "Anna", "age": 31}'
cut = '{"name": "Anna", "age": 31'

for reply in (fenced, chatty, cut):
    try:
        json.loads(reply)
    except json.JSONDecodeError as exc:
        print(exc.pos, len(reply))
Pierwsze dwa zawodzą na pos 0: parser spojrzał na sam pierwszy znak, backtick lub S, i się poddał. Trzeci zawodzi na końcu łańcucha (pos równa się len(reply)): wszystko, co przeczytał, było w porządku, a potem tekst się skończył. Ta różnica to twoja diagnoza. Pozycja 0 oznacza, że JSON prawdopodobnie tam jest, tylko opakowany. Pozycja na końcu oznacza, że odpowiedź urwała się wcześnie.
Ucięte odpowiedzi: sprawdź finish_reason, zanim zaczniesz parsować#
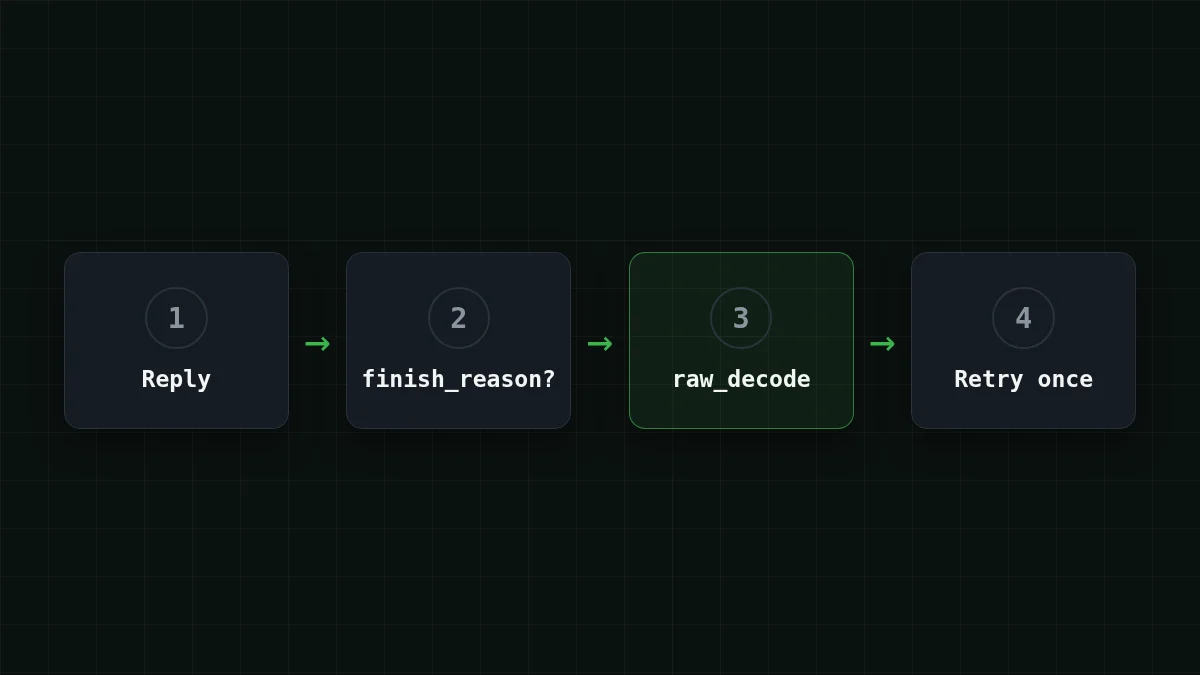
Odpowiedź, która urywa się w połowie, nie jest problemem parsowania, to problem długości. API ci to mówi: wybór ma finish_reason, a "length" oznacza, że odpowiedź została ucięta przez max_tokens (pełna historia w AI answer cut off? Fix finish_reason "length" and max_tokens). Spójrz na to najpierw, przed jakimkolwiek wyodrębnianiem.
Jest pewna paskudna pułapka, jeśli pominiesz ten krok. Skaner, który szuka pierwszego parsowalnego {, może wyłapać kompletny wewnętrzny obiekt z na wpół skończonego zewnętrznego, a twój skrypt pójdzie dalej z błędnymi danymi i bez błędu. Spróbuj:
Spróbuj samSpróbuj: co zwraca funkcja "znajdź pierwszy obiekt" dla tej uciętej odpowiedzi?Pokaż odpowiedź
Weź '{"user": {"name": "Anna"}, "age": 31'. Zewnętrzny obiekt nigdy się nie zamyka, ale wewnętrzny {"name": "Anna"} jest kompletny, więc poniższy ekstraktor zwraca {'name': 'Anna'}. Żadnego wyjątku, błędny wynik. Dlatego sprawdzenie finish_reason następuje przed wyodrębnianiem.
Poprawką na prawdziwe ucięcie jest więcej miejsca: podnieś max_tokens. DeepSeek-V4-Flash pozwala na do 32 768 tokenów wyjściowych na odpowiedź, GLM-5.3-Flash na do 8 192, więc długa lista JSON ma więcej miejsca na pierwszym z nich. Szczegóły modeli są na stronie modeli CheapTokens.
Wyciągnij JSON z tekstu#
Dla ogrodzeń i gadania biblioteka standardowa ma już narzędzie. Według tej samej strony Pythona JSONDecoder. dekoduje dokument JSON z łańcucha, który się nim zaczyna, i zwraca obiekt oraz indeks, na którym dokument się skończył. Dokumentacja mówi, że można go użyć na łańcuchu z nadmiarowymi danymi na końcu. Wymaga, aby dokument zaczynał się od pierwszego znaku, więc najpierw odetnij wiodący tekst: szukaj {, spróbuj dekodować od tego miejsca i przejdź do następnego {, jeśli to się nie uda.
import json

def extract_json(text):
    """Return the first JSON object found in text, or raise ValueError."""
    decoder = json.JSONDecoder()
    for i, ch in enumerate(text):
        if ch == '{':
            try:
                obj, _end = decoder.raw_decode(text[i:])
                return obj
            except json.JSONDecodeError:
                continue
    raise ValueError('no JSON object in the reply')
Radzi sobie z ogrodzeniem (wiodący ```json is skipped because it is not a {), the sentence before the object, and text after the closing brace. Expecting a list? Look for '[' instead. Don't look for both: a stray [1] w zdaniu typu "zobacz notatkę [1]" jest poprawnym JSON-em i wygrałby.
Dwie rzeczy celowo tego nie robią. Nigdy nie edytuje tekstu (żadnego regexu usuwającego backticki, żadnego zgadywania brakujących nawiasów), więc nie możesz zamienić zepsutej odpowiedzi w poprawnie wyglądające, ale błędne dane. I głośno zawodzi, gdy nie ma czego znaleźć, czego potrzebuje poniższa ponowna próba.
Ponów raz z bardziej rygorystycznym promptem#
Jeśli odpowiedź została ucięta lub w ogóle nie zawiera obiektu, zapytaj ponownie. Raz, nie w nieskończonej pętli. Przy ucięciu daj drugiej próbie więcej miejsca; w przeciwnym razie powiedz wprost, czego chcesz. Używa to OpenAI Python SDK przeciwko bazowemu URL CheapTokens (https:/) i pełnego id modelu z dokumentacji; klucz siedzi w zmiennej środowiskowej.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)
MODEL = 'deepseek-ai/DeepSeek-V4-Flash-0731'
STRICT = '\n\nReply with one JSON object only. No text before or after it, no code fence.'

def ask_json(prompt, max_tokens=800):
    content = prompt
    for attempt in (1, 2):
        resp = client.chat.completions.create(
            model=MODEL,
            messages=[{'role': 'user', 'content': content}],
            max_tokens=max_tokens,
        )
        choice = resp.choices[0]
        if choice.finish_reason == 'length':
            max_tokens *= 2          # cut off: more room next time
        else:
            try:
                return extract_json(choice.message.content or '')
            except ValueError:
                pass                 # no object: try the stricter prompt
        content = prompt + STRICT
    raise ValueError('no valid JSON after one retry')
Kolejność jest tu sednem: najpierw finish_reason, potem wyodrębnianie, a dopiero potem ponowna próba. Podnieś błąd po drugiej próbie, aby zadanie wsadowe mogło zalogować ten element i iść dalej.
Koszt ponownej próby łatwo oszacować. Załóżmy żądanie 1 200 tokenów wejściowych i 300 tokenów wyjściowych (założenie, użyj własnych liczb): $0.000048 na DeepSeek-V4-Flash lub $0.000036 na GLM-5.3-Flash. Jeśli 30 z 1 000 żądań potrzebuje drugiej próby, dodatkowy rachunek to 30 × to żądanie, $0.0014 na DeepSeek-V4-Flash. Ceny są aktualne, pochodzą z bieżącego cennika.
Ustaw w kolejności
Ułóż kroki naprawy w kolejności
Przeciągnij elementy lub użyj strzałek
- Sprawdź finish_reason: zatrzymaj się tutaj, jeśli mówi length
- Znajdź pierwszy { i odetnij tekst przed nim
- Dekoduj za pomocą raw_decode i zignoruj to, co następuje
- Jeśli nic nie znaleziono, ponów raz z bardziej rygorystycznym promptem
Który objaw, która poprawka#
Powyższe kroki mieszczą się w głowie do następnego dziwnego błędu. To jest to samo co tabela: znajdź to, co widzisz na ekranie, i przeczytaj poprawkę.
Wybierz swój przypadek
Wybierz to, co widzisz
Wybierz opcję, aby zobaczyć odpowiedź
json.loads zawodzi na pos 0
Odpowiedź zaczyna się od ogrodzenia lub zdania. Przepuść ją przez extract_json; ponowna próba nie jest potrzebna.
pos jest na końcu łańcucha
Odpowiedź urwała się wcześnie. Sprawdź finish_reason: jeśli to length, podnieś max_tokens i zapytaj ponownie.
Błąd jest gdzieś w środku
Model sam napisał zepsuty JSON (brakujący przecinek, końcowy przecinek, nieescapowany cudzysłów). Nie łataj go: ponów raz z bardziej rygorystycznym promptem i zaloguj odpowiedź, jeśli znowu zawiedzie.
json.loads działa, ale brakuje klucza
Parsowanie jest w porządku, treść nie. Wymień dokładne klucze w prompcie i sprawdź je w kodzie po parsowaniu.
Czy API może wymusić poprawny JSON?#
Czasami. Przewodnik OpenAI po structured outputs dokumentuje dwa tryby: tryb JSON (type: json_), który zwraca poprawny JSON, ale nie przestrzega schematu, oraz Structured Outputs (type: json_, strict: true), który przestrzega; OpenAI zaleca drugi, gdzie to możliwe (źródło: developers.openai.com, sprawdzone 2 listopada 2026). To są opcje własnego API OpenAI. Zanim polegniesz na response_format z innym endpointem, sprawdź dokumentację CheapTokens; powyższe wyodrębnianie i ponowna próba działają ze zwykłymi chat completions i nie wymagają żadnego specjalnego parametru. Więcej o opcjach po stronie żądania w Get valid JSON from an LLM API: response_format and retries.
Zanim wypuścisz parser, sprawdź cztery rzeczy: finish_reason jest odczytywane przed parsowaniem tekstu, jest tylko jedna ponowna próba (a drugie niepowodzenie jest logowane z id elementu), kod sprawdza, czy oczekiwane klucze istnieją po parsowaniu, a max_tokens zostawia miejsce na najdłuższy oczekiwany JSON.
Następnym razem, gdy json.loads rzuci wyjątek, wypisz najpierw exc.pos i finish_reason. Te dwie liczby zwykle mówią ci, co się stało, zanim przeczytasz choćby wiersz odpowiedzi.


