API i SDKPrzewodnik
LiteLLM z niestandardowym api_base: wywołaj CheapTokens w Pythonie
Użyj prefiksu openai/, api_base i pełnego identyfikatora modelu, aby wywołać CheapTokens z litellm.completion() i konfiguracji proxy config.yaml LiteLLM, oraz napraw Not Found.
Na tej stronie
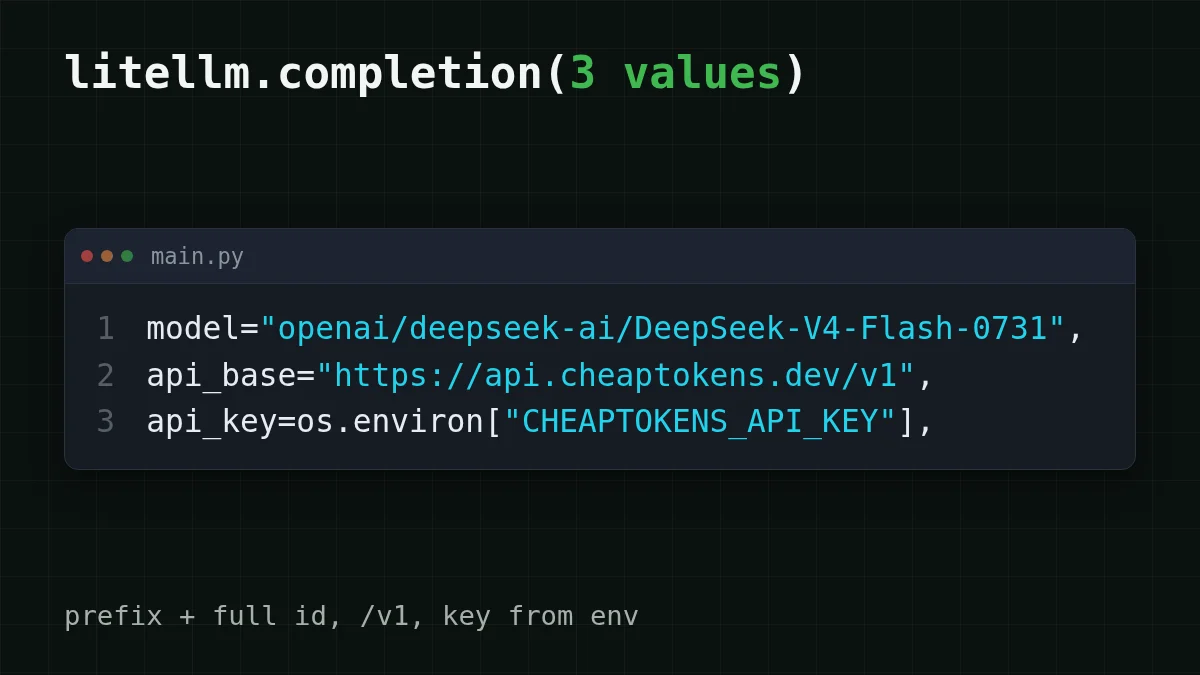
Aby skierować LiteLLM do CheapTokens, zmieniasz trzy wartości: model otrzymuje prefiks openai/ przed pełnym identyfikatorem modelu, api_base staje się https:/, a api_key to Twój klucz CheapTokens. To cała zmiana, zarówno dla litellm. w Pythonie, jak i dla proxy LiteLLM.
Załóżmy, że masz już projekt, który wywołuje litellm. z modelem OpenAI lub Anthropic, i chcesz wypróbować tańszy bez dotykania reszty kodu. Prefiks jest tym, co to umożliwia: dokumentacja dostawcy zgodnego z OpenAI LiteLLM (sprawdzona 29 października 2026) mówi, że dla dowolnego punktu końcowego zgodnego z OpenAI ustawiasz model za pomocą openai/, aby LiteLLM kierował do dostawcy OpenAI, a następnie przekazujesz obok api_base i api_key. CheapTokens obsługuje format OpenAI Chat Completions pod https:/, więc pasuje.
To samo wywołanie w Pythonie i w proxy#
Obie konfiguracje są krótkie. Wybierz kartę odpowiadającą sposobowi uruchamiania LiteLLM.
Jeden model CheapTokens, dwa sposoby wywołania
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Trzymaj klucz w zmiennej środowiskowej, nie w pliku.
Konfiguracja proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Uruchom ją za pomocą litellm -. Klienci pytają proxy o cheap-chat i nigdy nie widzą prawdziwego identyfikatora modelu.
Wywołanie proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Proxy domyślnie nasłuchuje na porcie 4000. Zmień później model stojący za cheap-chat, a to żądanie się nie zmieni.
Identyfikator modelu to część, na której ludzie się potykają. Identyfikator akceptowany przez CheapTokens to pełny identyfikator, deepseek-, a openai/ idzie przed nim. Nie deepseek-, nie sam prefiks plus krótka nazwa. Jeśli nie jesteś pewien, jak nazywa się model, wylistuj modele za pomocą GET /v1/models i skopiuj identyfikator z odpowiedzi.
Co powinieneś zobaczyć#
Uruchom kartę Python. Pierwszy print pokazuje tekst modelu. Drugi pokazuje response.usage, liczby tokenów dla tego jednego wywołania: prompt_tokens za to, co wysłałeś, i completion_ za to, co napisał model. LiteLLM zwraca je w formacie OpenAI, więc kod, który już odczytuje usage, nadal działa. Jeśli chcesz zamienić te dwie liczby na bieżący rachunek, śledzenie kosztu tokenów agenta w Pythonie pokazuje jak.
Dodawanie kolejnych modeli do proxy#
Sens model_name polega na tym, że Twoi klienci zachowują jeden alias, podczas gdy Ty zmieniasz to, co za nim stoi. model_list może zawierać kilka wpisów, wszystkie wskazujące na ten sam api_base i ten sam klucz, ponieważ jedno saldo CheapTokens obejmuje każdy model:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Który alias do jakiego zadania? Do czatu i wywołań agenta, gdzie odpowiedź może być długa, DeepSeek-V4-Flash jest tym, od którego warto zacząć: kontekst 380K, do 32 768 tokenów wyjściowych na odpowiedź i stała cena bez godzin szczytu. GLM-5.3-Flash ma kontekst 390K i do 8 192 tokenów wyjściowych. MiniMax-M2.7 ma kontekst 180K. Strona DeepSeek zawiera szczegóły, a cennik wymienia aktualne stawki dla wszystkich trzech.
Gdy się psuje: Not Found i 401#
Dwa błędy obejmują większość nieudanych pierwszych wywołań. Dokumentacja LiteLLM mówi, aby nie dodawać niczego ekstra do bazowego URL-a, i że przy błędzie Not Found należy sprawdzić, czy api_base kończy się na /v1. Jedna pułapka: własny przykład dokumentacji dla lokalnego proxy używa http:/ bez /v1. To inny serwer. Dla CheapTokens /v1 zostaje.
Wybierz swój przypadek
Jak wygląda Twój błąd?
Wybierz opcję, aby zobaczyć odpowiedź
Not Found (404)
Sprawdź api_base. Musi być dokładnie https:/, z /v1 i bez / na końcu. LiteLLM sam dodaje resztę ścieżki.
401 Unauthorized
Klucz jest brakujący, błędny lub LiteLLM odczytał pustą zmienną środowiskową. Wypisz długość os., nie sam klucz, aby sprawdzić, czy jest ustawiony, i upewnij się, że nie przekazałeś z przyzwyczajenia klucza OpenAI.
Model jest odrzucany
Porównaj identyfikator litera po literze z tym z /v1/models. Prefiks openai/ jest tylko dla LiteLLM; to, co po nim następuje, to pełny identyfikator CheapTokens, włącznie z częścią dewelopera przed ukośnikiem.
Pełny przegląd kodów statusu znajdziesz w API 401 lub 404: zły klucz, bazowy URL lub identyfikator modelu. Jeśli najpierw chcesz poznać ideę stojącą za api_base, czym jest base_url i jak go przełączyć wyjaśnia to w prostym języku.
Szybkie sprawdzenie
Twój api_base to https://api.cheaptokens.dev i wywołanie zwraca Not Found. Co zmieniasz najpierw?
Pokaż odpowiedź
Odpowiedź: Dodaj /v1, aby brzmiał https://api.cheaptokens.dev/v1
Not Found wskazuje na ścieżkę. Klucz dałby 401, a prefiks to to, co mówi LiteLLM, by użyć żądania w stylu OpenAI.
Ile kosztuje tysiąc wywołań#
Załóżmy, że bot wsparcia za proxy wysyła 1000 żądań dziennie, każde z około 2000 tokenów na wejściu (pytanie plus kontekst) i 500 tokenów na wyjściu. Oto to obciążenie przy aktualnych cenach, z kolumną OpenRouter do porównania w sumie, licząc wejście i wyjście razem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2000 tokenów wejściowych i 500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Dla DeepSeek-V4-Flash to obciążenie kosztuje $0.08 dziennie, a tabela pokazuje, że jest tańsze niż OpenRouter w sumie. Zmień te dwie liczby na swoje średnie żądanie i masz swój budżet.
To wszystko, czego potrzebuje LiteLLM: trzy wartości, jeden /v1 i pełny identyfikator modelu. Dodaj klucz z panelu i uruchom kartę Python.


