API e SDKGuida
LiteLLM con un api_base personalizzato: chiamare CheapTokens in Python
Usa il prefisso openai/, api_base e un id completo del modello per chiamare CheapTokens da litellm.completion() e da un config.yaml del proxy LiteLLM, e correggi Not Found.
In questa pagina
Per inviare LiteLLM a CheapTokens cambi tre valori: model riceve il prefisso openai/ davanti all'id completo del modello, api_base diventa https:/ e api_key è la tua chiave CheapTokens. Questo è l'intero passaggio, sia per litellm. in Python sia per un proxy LiteLLM.
Supponi di avere già un progetto che chiama litellm. con un modello OpenAI o Anthropic e di voler provare un modello più economico senza toccare il resto del codice. Il prefisso è ciò che lo rende possibile: la documentazione del provider compatibile con OpenAI di LiteLLM (consultata il 29 ottobre 2026) afferma che per qualsiasi endpoint compatibile con OpenAI si imposta il modello con openai/ in modo che LiteLLM instradi verso il provider OpenAI, poi si passano api_base e api_key accanto. CheapTokens parla il formato OpenAI Chat Completions su https:/, quindi si adatta.
La stessa chiamata in Python e in un proxy#
Le due configurazioni sono brevi. Scegli la scheda che corrisponde a come esegui LiteLLM.
Un modello CheapTokens, due modi per chiamarlo
SDK Python
import os
import litellm

response = litellm.completion(
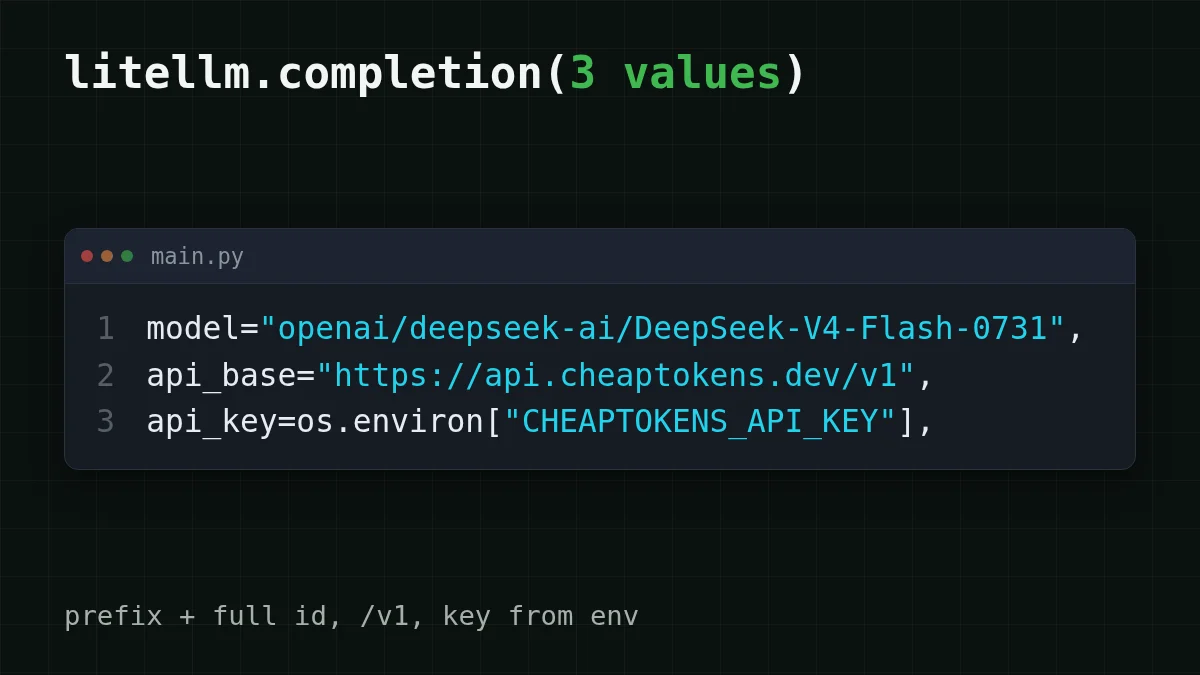
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Tieni la chiave in una variabile d'ambiente, non nel file.
Configurazione del proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Avvialo con litellm -. I client chiedono al proxy cheap-chat e non vedono mai l'id reale del modello.
Chiama il proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Il proxy ascolta sulla porta 4000 per impostazione predefinita. Cambia il modello dietro cheap-chat in seguito e questa richiesta non cambia.
L'id del modello è la parte su cui le persone inciampano. L'id che CheapTokens accetta è quello completo, deepseek-, e openai/ va davanti. Non deepseek-, non solo il prefisso più un nome breve. Se non sei sicuro di come si chiami un modello, elenca i modelli con GET /v1/models e copia l'id dalla risposta.
Cosa dovresti vedere#
Esegui la scheda Python. Il primo print mostra il testo del modello. Il secondo mostra response.usage, i conteggi dei token per quella singola chiamata: prompt_tokens per ciò che hai inviato e completion_ per ciò che il modello ha scritto. LiteLLM li restituisce nella forma OpenAI, quindi il codice che già legge usage continua a funzionare. Se vuoi trasformare quei due numeri in un conto corrente, tracciare il costo dei token degli agenti in Python mostra come fare.
Aggiungere altri modelli al proxy#
Il punto di model_name è che i tuoi client mantengono un alias mentre tu cambi ciò che sta dietro. Un model_list può contenere diverse voci, tutte puntate allo stesso api_base e alla stessa chiave, perché un saldo CheapTokens copre ogni modello:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Quale alias per quale compito? Per le chiamate di chat e agenti in cui la risposta può essere lunga, DeepSeek-V4-Flash è quello con cui iniziare: contesto da 380K, fino a 32.768 token di output per risposta e un prezzo fisso senza ore di punta. GLM-5.3-Flash ha un contesto da 390K e fino a 8.192 token di output. MiniMax-M2.7 ha un contesto da 180K. La pagina DeepSeek ha i dettagli e i prezzi elencano le tariffe attuali per tutti e tre.
Quando si rompe: Not Found e 401#
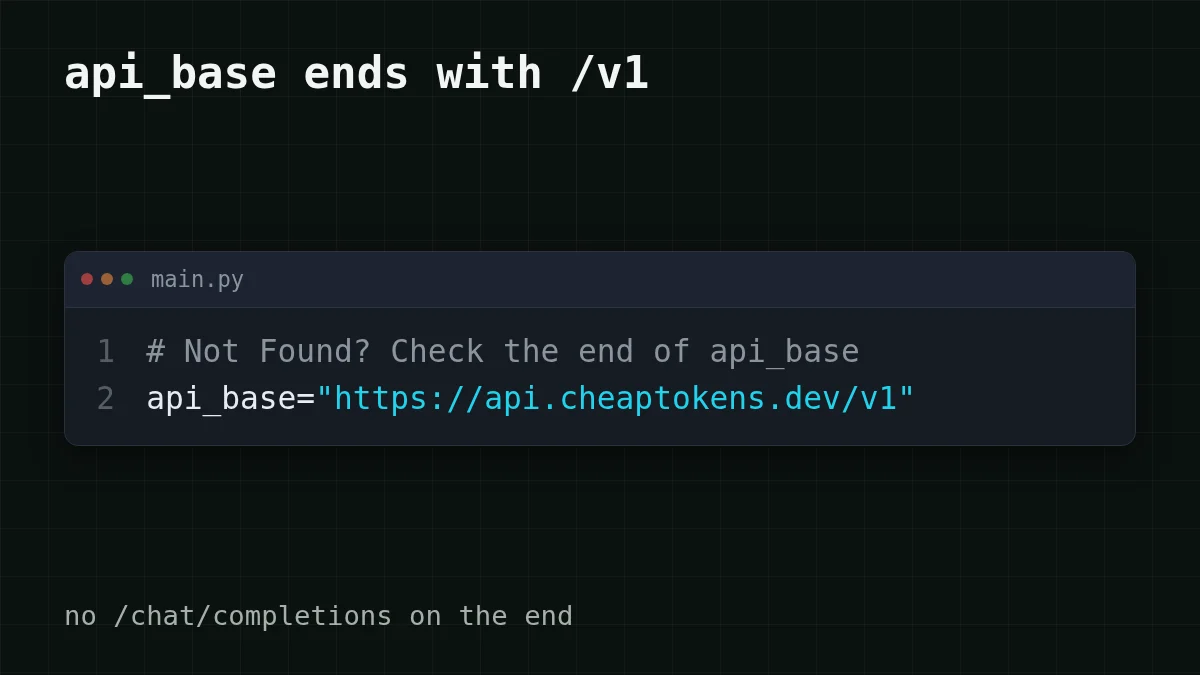
Due errori coprono la maggior parte delle prime chiamate fallite. La documentazione di LiteLLM dice di non aggiungere nulla di extra all'URL di base e che, in caso di errore Not Found, bisogna verificare che api_base termini con /v1. Una nota: l'esempio della documentazione per un proxy locale usa http:/ senza /v1. Quello è un server diverso. Per CheapTokens il /v1 resta.
Scegli il tuo caso
Che aspetto ha il tuo errore?
Scegli un'opzione per vedere la risposta
Not Found (404)
Controlla api_base. Deve essere esattamente https:/, con /v1 e senza / alla fine. LiteLLM aggiunge da sé il resto del percorso.
401 Unauthorized
La chiave manca, è sbagliata o LiteLLM ha letto una variabile d'ambiente vuota. Stampa la lunghezza di os., non la chiave stessa, per verificare che sia impostata, e assicurati di non aver passato una chiave OpenAI per abitudine.
Il modello viene rifiutato
Confronta l'id lettera per lettera con quello di /v1/models. Il prefisso openai/ è solo per LiteLLM; ciò che segue è l'id completo di CheapTokens, inclusa la parte dello sviluppatore prima della barra.
Per la panoramica completa dei codici di stato vedi API 401 o 404: chiave, URL di base o id del modello sbagliati. Se vuoi prima l'idea dietro api_base, cos'è base_url e come cambiarlo lo spiega in linguaggio semplice.
Verifica rapida
Il tuo api_base è https://api.cheaptokens.dev e la chiamata restituisce Not Found. Cosa cambi per primo?
Mostra risposta
Risposta: Aggiungi /v1 in modo che diventi https://api.cheaptokens.dev/v1
Not Found punta al percorso. La chiave darebbe 401 e il prefisso è ciò che dice a LiteLLM di usare la richiesta in stile OpenAI.
Quanto costano mille chiamate#
Supponi che un bot di supporto dietro il proxy invii 1.000 richieste al giorno, ciascuna con circa 2.000 token in ingresso (la domanda più il contesto) e 500 token in uscita. Ecco quel carico sui prezzi attuali, con una colonna OpenRouter per confrontare il totale, contando insieme input e output:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2000 token di input e 500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Per DeepSeek-V4-Flash quel carico costa $0.08 al giorno e la tabella mostra che è più economico di OpenRouter in totale. Cambia i due numeri con la tua richiesta media e hai il tuo budget.
Questo è tutto ciò che serve a LiteLLM: tre valori, un /v1 e un id completo del modello. Aggiungi la chiave dalla tua dashboard ed esegui la scheda Python.


