API at SDKGabay
LiteLLM na may custom na api_base: tawagin ang CheapTokens sa Python
Gamitin ang openai/ prefix, api_base at buong model id para tawagin ang CheapTokens mula sa litellm.completion() at isang LiteLLM proxy config.yaml, at ayusin ang Not Found.
Sa pahinang ito
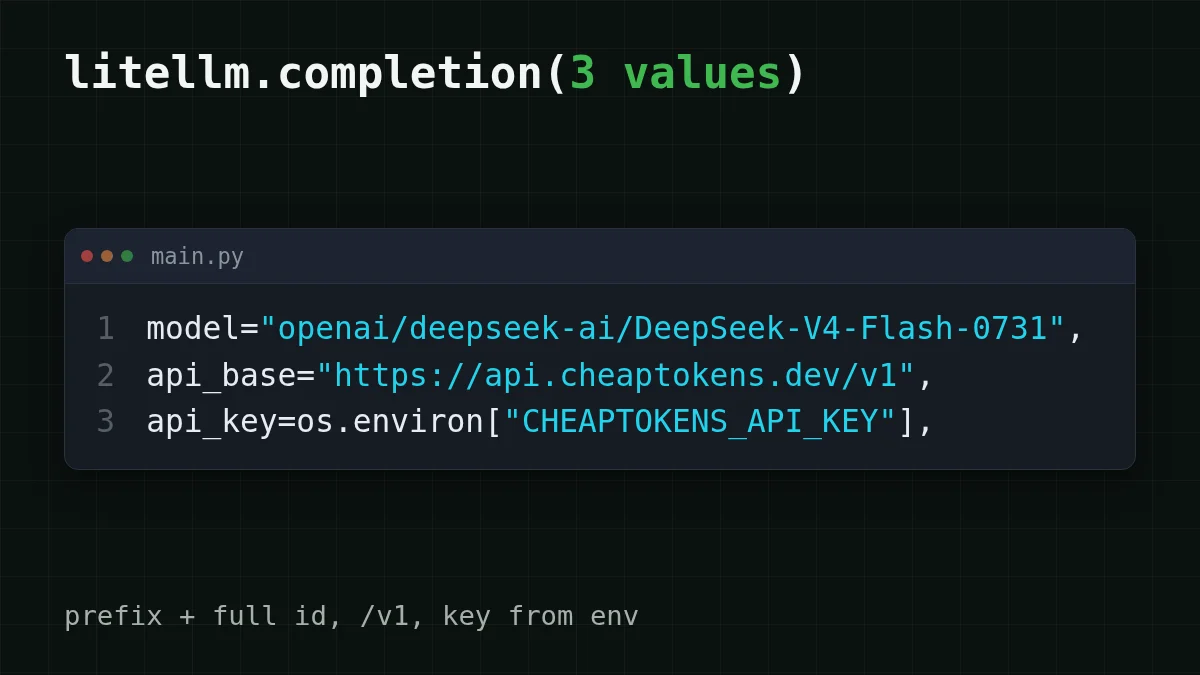
Para ipadala ang LiteLLM sa CheapTokens, babaguhin mo ang tatlong value: ang model ay nilalagyan ng openai/ prefix sa harap ng buong model id, ang api_base ay nagiging https:/, at ang api_key ay ang iyong CheapTokens key. Iyon lang ang buong switch, para sa litellm. sa Python at para sa isang LiteLLM proxy.
Sabihin nating mayroon ka nang project na tumatawag sa litellm. gamit ang OpenAI o Anthropic model, at gusto mong subukan ang mas mura nang hindi hinahawakan ang ibang code. Ang prefix ang dahilan kung bakit ito gumagana: sinasabi ng OpenAI-compatible provider docs ng LiteLLM (sinuri noong 29 Oktubre 2026) na para sa anumang OpenAI-compatible endpoint, itinatakda mo ang model gamit ang openai/ para i-route ng LiteLLM sa OpenAI provider, pagkatapos ay ipasa ang api_base at api_key sa tabi nito. Nagsasalita ang CheapTokens ng OpenAI Chat Completions format sa https:/, kaya bagay ito.
Ang parehong tawag sa Python at sa isang proxy#
Maikli lang ang dalawang setup. Piliin ang tab na tumutugma sa kung paano mo pinapatakbo ang LiteLLM.
Isang CheapTokens model, dalawang paraan para tawagin ito
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Ilagay ang key sa isang environment variable, hindi sa file.
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Simulan ito gamit ang litellm -. Hinihingi ng mga client sa proxy ang cheap-chat at hindi kailanman nakikita ang tunay na model id.
Tawagin ang proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Nakikinig ang proxy sa port 4000 bilang default. Palitan ang model sa likod ng cheap-chat mamaya at hindi magbabago ang request na ito.
Ang model id ang bahaging madalas ikinakamali ng mga tao. Ang id na tinatanggap ng CheapTokens ay ang buo, deepseek-, at ang openai/ ay inilalagay sa harap nito. Hindi deepseek-, hindi lang ang prefix kasama ang maikling pangalan. Kung hindi ka sigurado kung ano ang tawag sa isang model, ilista ang mga model gamit ang GET /v1/models at kopyahin ang id mula sa sagot.
Ano ang dapat mong makita#
Patakbuhin ang Python tab. Ang unang print ay nagpapakita ng teksto ng model. Ang pangalawa ay nagpapakita ng response.usage, ang token counts para sa isang tawag na iyon: prompt_tokens para sa ipinadala mo at completion_ para sa isinulat ng model. Ibinalik sila ng LiteLLM sa OpenAI shape, kaya patuloy na gumagana ang code na nagbabasa na ng usage. Kung gusto mong gawing running bill ang dalawang numerong iyon, ipinapakita ng pagsubaybay sa token cost ng agent sa Python kung paano.
Pagdaragdag ng mas maraming model sa proxy#
Ang punto ng model_name ay panatilihin ng iyong mga client ang isang alias habang binabago mo ang nasa likod nito. Ang isang model_list ay maaaring maglaman ng ilang entry, lahat nakaturo sa parehong api_base at parehong key, dahil sinasaklaw ng isang CheapTokens balance ang bawat model:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Aling alias para sa aling trabaho? Para sa chat at agent calls kung saan maaaring humaba ang sagot, ang DeepSeek-V4-Flash ang simulang gamitin: 380K context, hanggang 32,768 output tokens bawat sagot, at fixed price na walang peak hours. Ang GLM-5.3-Flash ay may 390K context at hanggang 8,192 output tokens. Ang MiniMax-M2.7 ay may 180K context. Nasa DeepSeek page ang mga detalye, at nakalista sa pricing ang kasalukuyang rates para sa tatlo.
Kapag nasira: Not Found at 401#
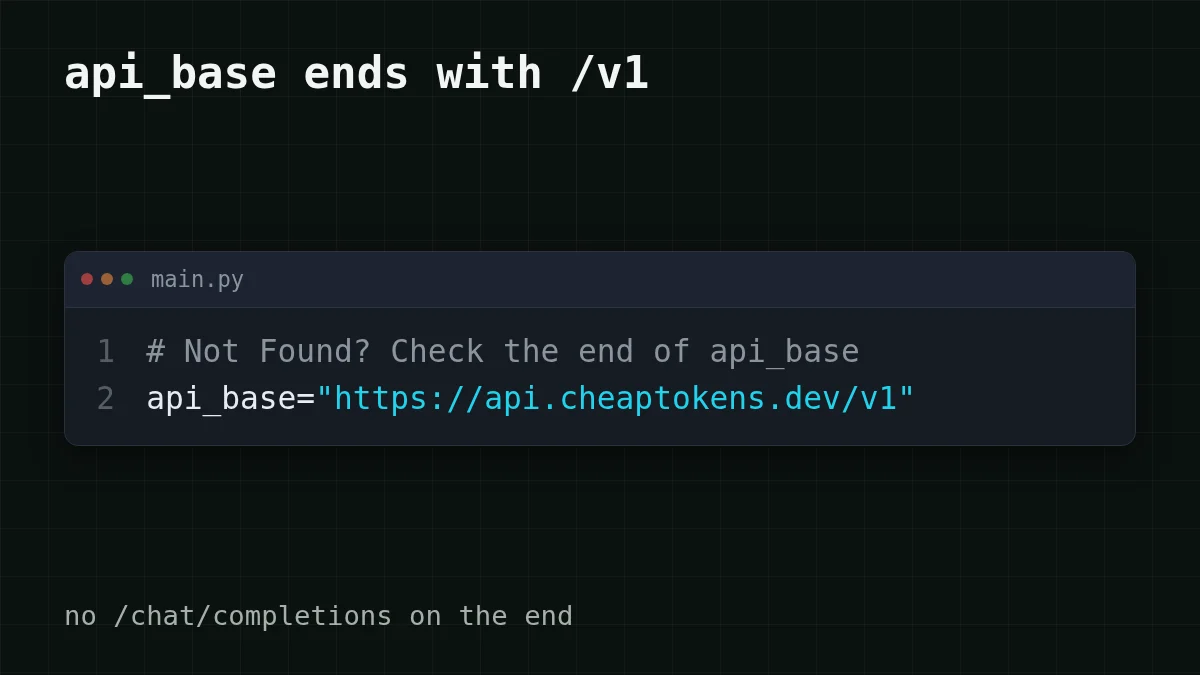
Dalawang error ang sumasaklaw sa karamihan ng nabigong unang tawag. Sinasabi ng LiteLLM docs na huwag magdagdag ng anumang extra sa base URL, at sa Not Found error ay dapat mong suriin na ang api_base ay nagtatapos sa /v1. Isang catch: ang sariling halimbawa ng docs para sa local proxy ay gumagamit ng http:/ na walang /v1. Iba iyon na server. Para sa CheapTokens, nananatili ang /v1.
Piliin ang iyong kaso
Ano ang hitsura ng iyong error?
Pumili ng opsyon upang makita ang sagot
Not Found (404)
Suriin ang api_base. Dapat itong eksaktong https:/, may /v1 at walang / sa dulo. Idinadagdag ng LiteLLM ang natitirang path mismo.
401 Unauthorized
Kulang ang key, mali, o may nabasang empty environment variable ang LiteLLM. I-print ang haba ng os., hindi ang key mismo, para suriin kung nakatakda ito, at tiyakin na hindi ka nagpasa ng OpenAI key dahil sa ugali.
Tinatanggihan ang model
Ihambing ang id titik-titik sa isa mula sa /v1/models. Ang openai/ prefix ay para sa LiteLLM lamang; ang sumusunod dito ay ang buong CheapTokens id, kasama ang developer part bago ang slash.
Para sa buong walk through ng status codes, tingnan ang API 401 o 404: maling key, base URL o model id. Kung gusto mo munang ang ideya sa likod ng api_base, ipinapaliwanag ito ng ano ang base_url at paano magpalit sa simpleng pananalita.
Mabilisang pagsusuri
Ang iyong api_base ay https://api.cheaptokens.dev at nagbabalik ng Not Found ang tawag. Ano ang una mong babaguhin?
Ipakita ang sagot
Sagot: Idagdag ang /v1 para maging https://api.cheaptokens.dev/v1
Itinuturo ng Not Found ang path. Ang key ay magbibigay ng 401, at ang prefix ang nagsasabi sa LiteLLM na gamitin ang OpenAI-style request.
Magkano ang isang libong tawag#
Ipagpalagay na ang support bot sa likod ng proxy ay nagpapadala ng 1,000 request bawat araw, bawat isa ay may mga 2,000 tokens in (ang tanong kasama ang context) at 500 tokens out. Narito ang load na iyon sa live na presyo, may OpenRouter column para ihambing sa total, pinagsama ang input at output:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2,000 input at 500 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Para sa DeepSeek-V4-Flash, ang load na iyon ay nagkakahalaga ng $0.08 bawat araw, at ipinapakita ng table na mas mura ito kaysa OpenRouter sa total. Palitan ang dalawang numero ng sarili mong average request at mayroon ka nang budget.
Iyon lang ang kailangan ng LiteLLM: tatlong value, isang /v1, at isang buong model id. Idagdag ang key mula sa iyong dashboard at patakbuhin ang Python tab.


