API और SDKगाइड
कस्टम api_base के साथ LiteLLM: Python में CheapTokens को कॉल करें
litellm.completion() और LiteLLM प्रॉक्सी config.yaml से CheapTokens को कॉल करने के लिए openai/ प्रीफ़िक्स, api_base और पूरी मॉडल id इस्तेमाल करें, और Not Found ठीक करें।
इस पृष्ठ पर
LiteLLM को CheapTokens पर भेजने के लिए आप तीन मान बदलते हैं: model में पूरे मॉडल id से पहले openai/ प्रीफ़िक्स लगता है, api_base https:/ बन जाता है, और api_key आपकी CheapTokens कुंजी है। बस इतना ही बदलाव है, Python में litellm. के लिए और LiteLLM प्रॉक्सी के लिए भी।
मान लीजिए आपके पास पहले से एक प्रोजेक्ट है जो OpenAI या Anthropic मॉडल के साथ litellm. कॉल करता है, और आप बाकी कोड छुए बिना कोई सस्ता मॉडल आज़माना चाहते हैं। प्रीफ़िक्स ही इसे काम कराता है: LiteLLM के OpenAI-compatible provider docs (29 अक्टूबर 2026 को जाँचा गया) कहते हैं कि किसी भी OpenAI-compatible endpoint के लिए आप मॉडल को openai/ के साथ सेट करते हैं ताकि LiteLLM OpenAI प्रोवाइडर पर रूट करे, फिर उसके साथ api_base और api_key पास करते हैं। CheapTokens https:/ पर OpenAI Chat Completions फ़ॉर्मैट बोलता है, इसलिए यह फ़िट बैठता है।
Python और प्रॉक्सी में वही कॉल#
दोनों सेटअप छोटे हैं। जिस तरह आप LiteLLM चलाते हैं उससे मेल खाने वाला टैब चुनें।
एक CheapTokens मॉडल, कॉल करने के दो तरीके
Python SDK
import os
import litellm

response = litellm.completion(
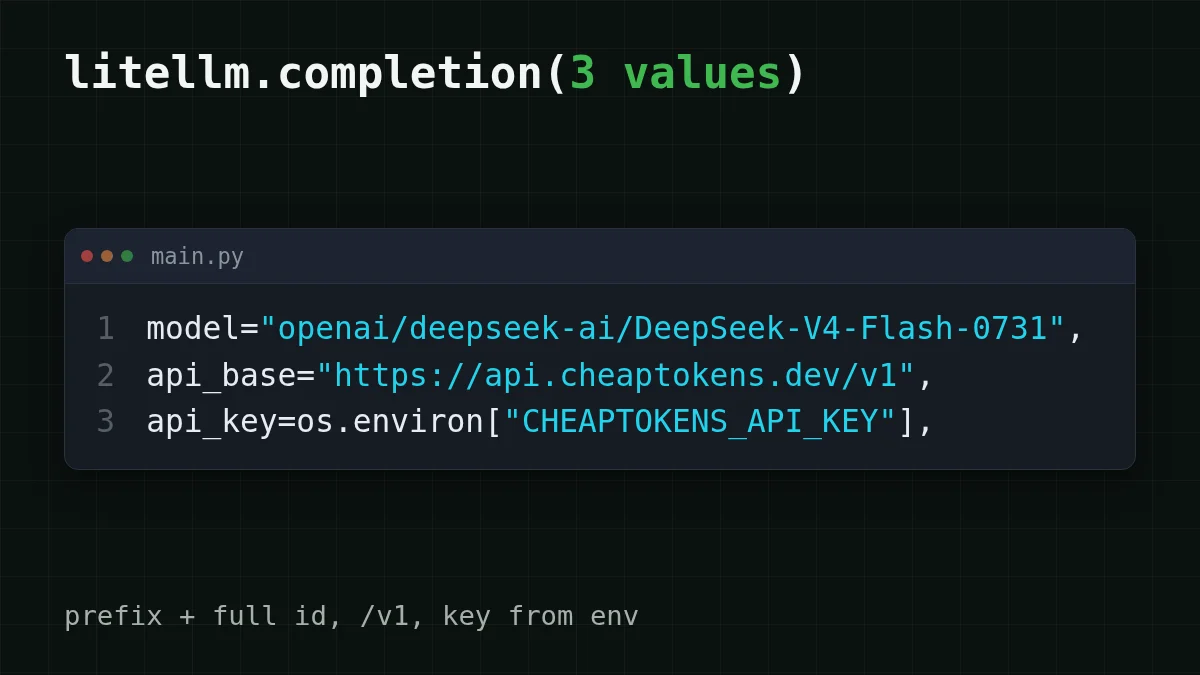
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
कुंजी को एनवायरनमेंट वेरिएबल में रखें, फ़ाइल में नहीं।
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
इसे litellm - से शुरू करें। क्लाइंट प्रॉक्सी से cheap-chat माँगते हैं और असली मॉडल id कभी नहीं देखते।
प्रॉक्सी को कॉल करें
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
प्रॉक्सी डिफ़ॉल्ट रूप से पोर्ट 4000 पर सुनता है। बाद में cheap-chat के पीछे का मॉडल बदल दें और यह रिक्वेस्ट नहीं बदलती।
मॉडल id वह हिस्सा है जहाँ लोग अटकते हैं। CheapTokens जो id स्वीकार करता है वह पूरी है, deepseek-, और उसके आगे openai/ लगता है। deepseek- नहीं, और न ही सिर्फ़ प्रीफ़िक्स प्लस कोई छोटा नाम। अगर आपको पता नहीं कि किसी मॉडल का नाम क्या है, तो GET /v1/models से मॉडलों की सूची लें और जवाब से id कॉपी करें।
आपको क्या दिखना चाहिए#
Python टैब चलाएँ। पहला print मॉडल का टेक्स्ट दिखाता है। दूसरा response.usage दिखाता है, उस एक कॉल के टोकन गिनती: आपने जो भेजा उसके लिए prompt_tokens और मॉडल ने जो लिखा उसके लिए completion_। LiteLLM इन्हें OpenAI के आकार में लौटाता है, इसलिए जो कोड पहले से usage पढ़ता है वह चलता रहता है। अगर आप इन दो संख्याओं को चलते हुए बिल में बदलना चाहते हैं, तो Python में एजेंट टोकन लागत ट्रैक करना दिखाता है कि कैसे।
प्रॉक्सी में और मॉडल जोड़ना#
model_name का मतलब यह है कि आपके क्लाइंट एक ही alias रखते हैं जबकि आप उसके पीछे जो है उसे बदलते रहते हैं। एक model_list में कई एंट्री हो सकती हैं, सभी एक ही api_base और एक ही कुंजी की ओर इशारा करती हैं, क्योंकि एक CheapTokens बैलेंस हर मॉडल को कवर करता है:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
किस काम के लिए कौन सा alias? चैट और एजेंट कॉल के लिए जहाँ जवाब लंबा हो सकता है, DeepSeek-V4-Flash से शुरू करें: 380K कॉन्टेक्स्ट, प्रति जवाब 32,768 आउटपुट टोकन तक, और बिना पीक आवर्स के तय कीमत। GLM-5.3-Flash में 390K कॉन्टेक्स्ट और 8,192 आउटपुट टोकन तक हैं। MiniMax-M2.7 में 180K कॉन्टेक्स्ट है। DeepSeek पेज पर ब्यौरा है, और pricing तीनों के मौजूदा रेट बताती है।
जब यह टूटे: Not Found और 401#
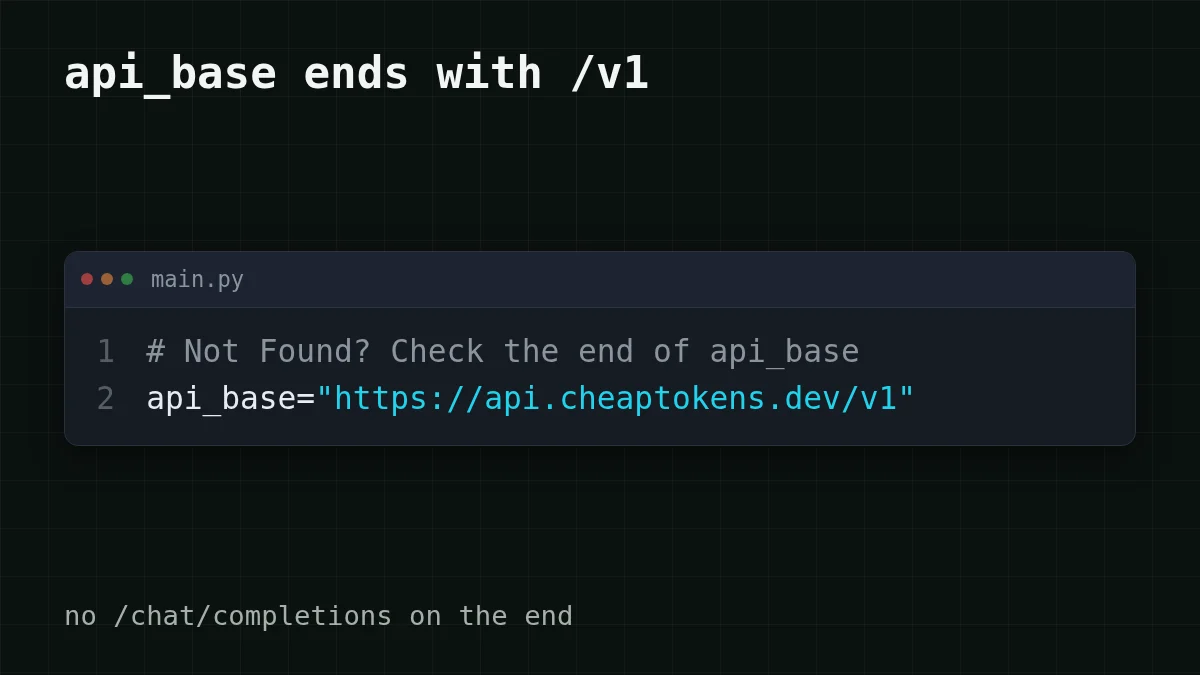
दो एरर ज़्यादातर फेल हुई पहली कॉलों को कवर करते हैं। LiteLLM के डॉक्स कहते हैं कि base URL में कुछ अतिरिक्त न जोड़ें, और Not Found एरर पर आपको जाँचना चाहिए कि api_base का अंत /v1 पर होता है। एक पेच: डॉक्स का अपना उदाहरण लोकल प्रॉक्सी के लिए http:/ इस्तेमाल करता है जिसमें /v1 नहीं है। वह अलग सर्वर है। CheapTokens के लिए /v1 बना रहता है।
अपना मामला चुनें
आपका एरर कैसा दिखता है?
उत्तर देखने के लिए एक विकल्प चुनें
Not Found (404)
api_base जाँचें। यह ठीक https:/ होना चाहिए, /v1 के साथ और अंत में / के बिना। बाकी पाथ LiteLLM खुद जोड़ता है।
401 Unauthorized
कुंजी गायब है, गलत है, या LiteLLM ने खाली एनवायरनमेंट वेरिएबल पढ़ा है। जाँचने के लिए os. की लंबाई प्रिंट करें, कुंजी खुद नहीं, और पक्का करें कि आपने आदतवश कोई OpenAI कुंजी नहीं पास की।
मॉडल अस्वीकार हो रहा है
id की /v1/models से आने वाले id के साथ अक्षर-दर-अक्षर तुलना करें। openai/ प्रीफ़िक्स सिर्फ़ LiteLLM के लिए है; उसके बाद पूरी CheapTokens id आती है, जिसमें स्लैश से पहले डेवलपर वाला हिस्सा भी शामिल है।
स्टेटस कोड के पूरे वॉकथ्रू के लिए API 401 या 404: गलत कुंजी, base URL या मॉडल id देखें। अगर आप पहले api_base के पीछे का विचार चाहते हैं, तो base_url क्या है और कैसे बदलें इसे सरल भाषा में समझाता है।
त्वरित जाँच
आपका api_base https://api.cheaptokens.dev है और कॉल Not Found लौटाती है। आप पहले क्या बदलते हैं?
उत्तर दिखाएँ
उत्तर: /v1 जोड़ें ताकि यह https://api.cheaptokens.dev/v1 पढ़े
Not Found पाथ की ओर इशारा करता है। कुंजी 401 देती, और प्रीफ़िक्स ही LiteLLM को बताता है कि OpenAI-शैली की रिक्वेस्ट इस्तेमाल करनी है।
हज़ार कॉल की लागत#
मान लें कि प्रॉक्सी के पीछे एक सपोर्ट बॉट रोज़ 1,000 रिक्वेस्ट भेजता है, हर एक में लगभग 2,000 टोकन इन (सवाल प्लस कॉन्टेक्स्ट) और 500 टोकन आउट। यहाँ लाइव कीमतों पर वह लोड है, तुलना के लिए OpenRouter कॉलम के साथ, कुल, इनपुट और आउटपुट मिलाकर गिना गया:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
प्रति अनुरोध 2,000 इनपुट और 500 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
DeepSeek-V4-Flash के लिए वह लोड प्रति दिन $0.08 का पड़ता है, और तालिका दिखाती है कि कुल मिलाकर यह OpenRouter से सस्ता है। दोनों संख्याओं को अपनी औसत रिक्वेस्ट में बदलें और आपका बजट तैयार है।
LiteLLM को बस इतना ही चाहिए: तीन मान, एक /v1, और पूरी मॉडल id। अपने डैशबोर्ड से कुंजी जोड़ें और Python टैब चलाएँ।


