API & SDKHướng dẫn
LiteLLM với api_base tùy chỉnh: gọi CheapTokens trong Python
Dùng tiền tố openai/, api_base và id model đầy đủ để gọi CheapTokens từ litellm.completion() và config.yaml của proxy LiteLLM, và sửa lỗi Not Found.
Trên trang này
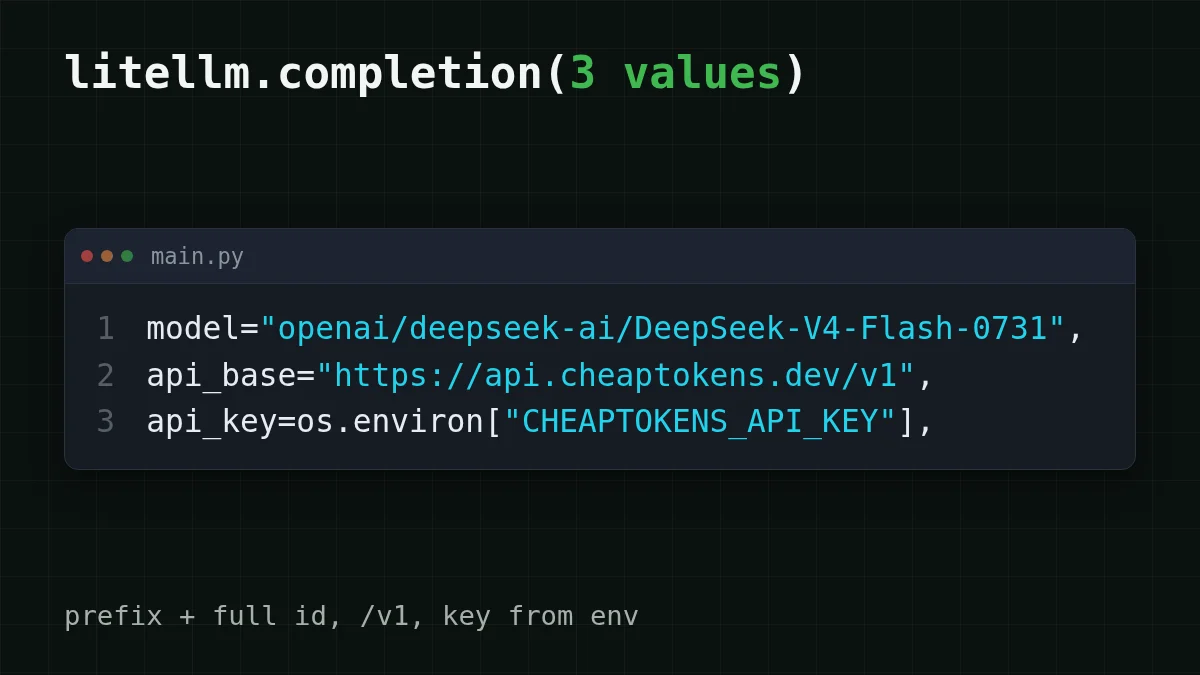
Để gửi LiteLLM đến CheapTokens, bạn thay đổi ba giá trị: model nhận tiền tố openai/ phía trước id model đầy đủ, api_base trở thành https:/, và api_key là key CheapTokens của bạn. Đó là toàn bộ việc chuyển đổi, cả cho litellm. trong Python và cho một proxy LiteLLM.
Giả sử bạn đã có một dự án gọi litellm. với model OpenAI hoặc Anthropic, và bạn muốn thử một model rẻ hơn mà không động đến phần còn lại của mã. Tiền tố là thứ giúp nó hoạt động: tài liệu nhà cung cấp tương thích OpenAI của LiteLLM (kiểm tra ngày 29 tháng 10 năm 2026) nói rằng với bất kỳ endpoint tương thích OpenAI nào, bạn đặt model với openai/ để LiteLLM định tuyến đến nhà cung cấp OpenAI, sau đó truyền api_base và api_key bên cạnh. CheapTokens nói định dạng OpenAI Chat Completions tại https:/, nên nó phù hợp.
Cùng một lệnh gọi trong Python và trong proxy#
Hai thiết lập đều ngắn. Chọn tab khớp với cách bạn chạy LiteLLM.
Một model CheapTokens, hai cách gọi
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Giữ key trong biến môi trường, không phải trong tệp.
Cấu hình proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Khởi động nó với litellm -. Client hỏi proxy cho cheap-chat và không bao giờ thấy id model thật.
Gọi proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Proxy lắng nghe trên cổng 4000 theo mặc định. Thay model phía sau cheap-chat sau này và yêu cầu này không thay đổi.
Id model là phần mọi người hay vấp. Id mà CheapTokens chấp nhận là id đầy đủ, deepseek-, và openai/ đứng trước nó. Không phải deepseek-, không chỉ tiền tố cộng với tên ngắn. Nếu bạn không chắc model tên là gì, liệt kê các model với GET /v1/models và sao chép id từ câu trả lời.
Những gì bạn nên thấy#
Chạy tab Python. Lần print đầu tiên hiển thị văn bản của model. Lần thứ hai hiển thị response.usage, số token cho lần gọi đó: prompt_tokens cho những gì bạn gửi và completion_ cho những gì model viết. LiteLLM trả chúng theo hình dạng OpenAI, nên mã đã đọc usage vẫn hoạt động. Nếu bạn muốn biến hai con số đó thành hóa đơn đang chạy, theo dõi chi phí token của agent trong Python chỉ cách làm.
Thêm nhiều model vào proxy#
Điểm mấu chốt của model_name là client của bạn giữ một bí danh trong khi bạn thay đổi thứ đứng sau nó. Một model_list có thể chứa nhiều mục, tất cả trỏ đến cùng api_base và cùng key, vì một số dư CheapTokens bao phủ mọi model:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Bí danh nào cho công việc nào? Cho các lệnh gọi chat và agent nơi câu trả lời có thể dài, DeepSeek-V4-Flash là lựa chọn để bắt đầu: ngữ cảnh 380K, tối đa 32.768 token đầu ra mỗi câu trả lời, và giá cố định không có giờ cao điểm. GLM-5.3-Flash có ngữ cảnh 390K và tối đa 8.192 token đầu ra. MiniMax-M2.7 có ngữ cảnh 180K. Trang DeepSeek có chi tiết, và bảng giá liệt kê mức giá hiện tại cho cả ba.
Khi nó hỏng: Not Found và 401#
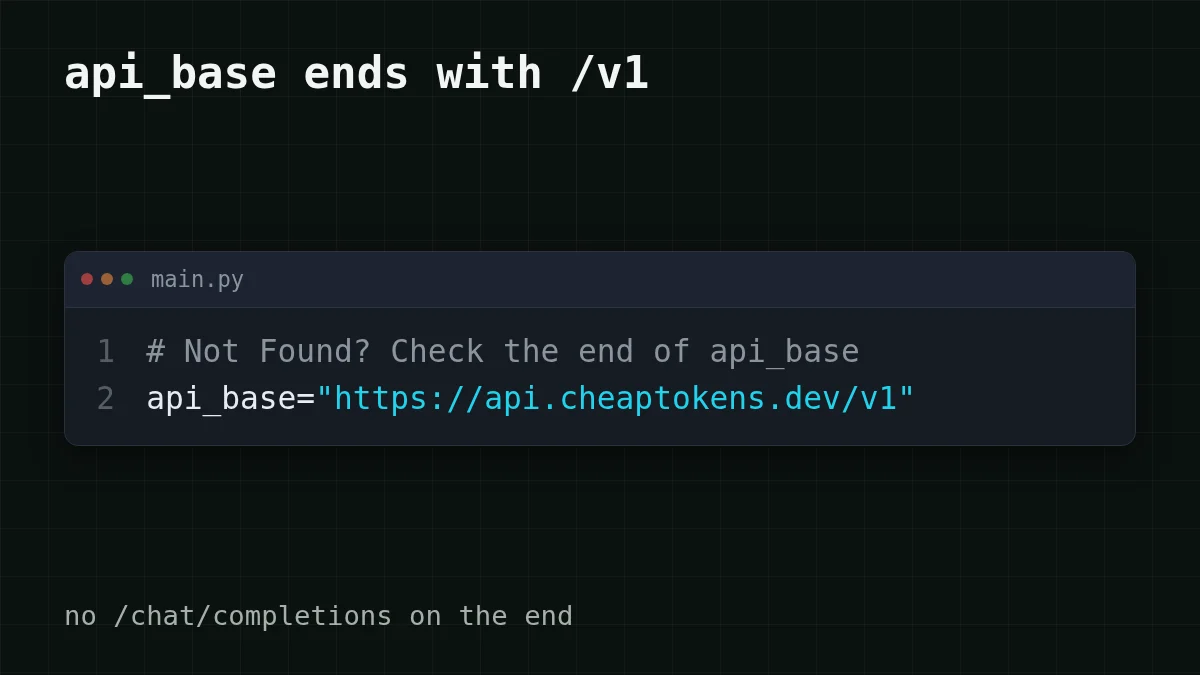
Hai lỗi bao phủ hầu hết các lần gọi đầu thất bại. Tài liệu LiteLLM nói không thêm bất cứ thứ gì vào base URL, và rằng với lỗi Not Found bạn nên kiểm tra rằng api_base kết thúc bằng /v1. Một điều cần lưu ý: ví dụ của chính tài liệu cho proxy cục bộ dùng http:/ không có /v1. Đó là một server khác. Với CheapTokens, /v1 vẫn giữ.
Chọn trường hợp của bạn
Lỗi của bạn trông như thế nào?
Chọn một tùy chọn để xem đáp án
Not Found (404)
Kiểm tra api_base. Nó phải chính xác là https:/, có /v1 và không có / ở cuối. LiteLLM tự thêm phần còn lại của đường dẫn.
401 Unauthorized
Key bị thiếu, sai, hoặc LiteLLM đọc một biến môi trường rỗng. In độ dài của os., không phải chính key, để kiểm tra nó đã được đặt, và đảm bảo bạn không vô tình truyền key OpenAI theo thói quen.
Model bị từ chối
So sánh id từng chữ cái với id từ /v1/models. Tiền tố openai/ chỉ dành cho LiteLLM; phần theo sau nó là id CheapTokens đầy đủ, bao gồm phần nhà phát triển trước dấu gạch chéo.
Để xem hướng dẫn đầy đủ về mã trạng thái, xem API 401 hoặc 404: sai key, base URL hoặc id model. Nếu bạn muốn ý tưởng đằng sau api_base trước, base_url là gì và cách chuyển đổi giải thích nó bằng phiên bản ngôn ngữ đơn giản.
Kiểm tra nhanh
api_base của bạn là https://api.cheaptokens.dev và lệnh gọi trả về Not Found. Bạn thay đổi gì trước tiên?
Hiện đáp án
Trả lời: Thêm /v1 để nó đọc là https://api.cheaptokens.dev/v1
Not Found chỉ vào đường dẫn. Key sẽ cho 401, và tiền tố là thứ báo LiteLLM dùng yêu cầu kiểu OpenAI.
Một nghìn lệnh gọi tốn bao nhiêu#
Giả sử một bot hỗ trợ phía sau proxy gửi 1.000 yêu cầu mỗi ngày, mỗi yêu cầu khoảng 2.000 token vào (câu hỏi cộng ngữ cảnh) và 500 token ra. Đây là tải đó trên giá hiện tại, với một cột OpenRouter để so sánh tổng, đầu vào và đầu ra cộng lại:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 token đầu vào và 500 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Với DeepSeek-V4-Flash, tải đó tốn $0.08 mỗi ngày, và bảng cho thấy nó rẻ hơn OpenRouter về tổng. Thay hai con số bằng yêu cầu trung bình của bạn và bạn có ngân sách của mình.
Đó là tất cả những gì LiteLLM cần: ba giá trị, một /v1, và một id model đầy đủ. Thêm key từ bảng điều khiển của bạn và chạy tab Python.


