API اور SDKگائیڈ
کسٹم api_base کے ساتھ LiteLLM: Python میں CheapTokens کال کریں
CheapTokens کو litellm.completion() اور LiteLLM پراکسی config.yaml سے کال کرنے کے لیے openai/ پری فکس، api_base اور مکمل ماڈل آئی ڈی استعمال کریں، اور Not Found ٹھیک کریں۔
اس صفحہ پر
LiteLLM کو CheapTokens پر بھیجنے کے لیے آپ تین ویلیوز تبدیل کرتے ہیں: model کو مکمل ماڈل آئی ڈی سے پہلے openai/ پری فکس ملتا ہے، api_base https:/ بن جاتا ہے، اور api_key آپ کی CheapTokens کلید ہے۔ بس یہی پورا سوئچ ہے، چاہے Python میں litellm. ہو یا LiteLLM پراکسی۔
فرض کریں آپ کے پاس پہلے سے ایک پروجیکٹ ہے جو OpenAI یا Anthropic ماڈل کے ساتھ litellm. کال کرتا ہے، اور آپ باقی کوڈ کو چھوئے بغیر کوئی سستا ماڈل آزمانا چاہتے ہیں۔ پری فکس ہی یہ کام کرتا ہے: LiteLLM کی OpenAI-compatible provider docs (29 اکتوبر 2026 کو چیک شدہ) کے مطابق کسی بھی OpenAI-compatible اینڈ پوائنٹ کے لیے آپ ماڈل کو openai/ کے ساتھ سیٹ کرتے ہیں تاکہ LiteLLM OpenAI پرووائیڈر کی طرف روٹ کرے، پھر اس کے ساتھ api_base اور api_key پاس کرتے ہیں۔ CheapTokens https:/ پر OpenAI Chat Completions فارمیٹ بولتا ہے، اس لیے یہ فٹ بیٹھتا ہے۔
Python اور پراکسی میں وہی کال#
دونوں سیٹ اپ مختصر ہیں۔ وہ ٹیب چنیں جو آپ کے LiteLLM چلانے کے طریقے سے میل کھاتا ہو۔
ایک CheapTokens ماڈل، کال کرنے کے دو طریقے
Python SDK
import os
import litellm

response = litellm.completion(
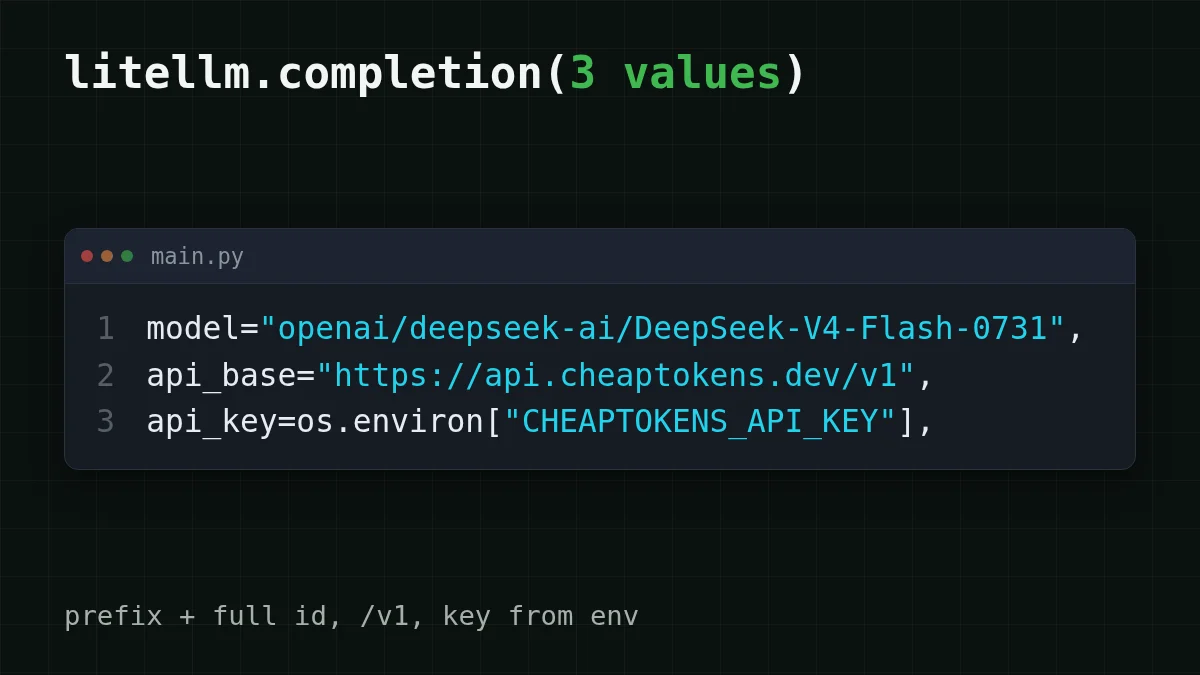
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
کلید کو ماحول کے متغیر میں رکھیں، فائل میں نہیں۔
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
اسے litellm - سے شروع کریں۔ کلائنٹس پراکسی سے cheap-chat مانگتے ہیں اور اصل ماڈل آئی ڈی کبھی نہیں دیکھتے۔
پراکسی کو کال کریں
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
پراکسی بطور ڈیفالٹ پورٹ 4000 پر سنتی ہے۔ بعد میں cheap-chat کے پیچھے ماڈل بدل دیں تو یہ درخواست تبدیل نہیں ہوتی۔
ماڈل آئی ڈی وہ حصہ ہے جہاں لوگ پھنس جاتے ہیں۔ CheapTokens جو آئی ڈی قبول کرتا ہے وہ مکمل ہے، deepseek-، اور openai/ اس کے آگے آتا ہے۔ نہ deepseek-، نہ صرف پری فکس اور کوئی مختصر نام۔ اگر آپ کو یقین نہ ہو کہ ماڈل کا نام کیا ہے تو GET /v1/models سے ماڈلز کی فہرست دیکھیں اور جواب سے آئی ڈی کاپی کریں۔
آپ کو کیا نظر آنا چاہیے#
Python ٹیب چلائیں۔ پہلا print ماڈل کا متن دکھاتا ہے۔ دوسرا response.usage دکھاتا ہے، یعنی اسی ایک کال کے ٹوکن شمار: آپ نے جو بھیجا اس کے لیے prompt_tokens اور ماڈل نے جو لکھا اس کے لیے completion_۔ LiteLLM انہیں OpenAI کی شکل میں واپس کرتا ہے، اس لیے جو کوڈ پہلے سے usage پڑھتا ہے وہ چلتا رہتا ہے۔ اگر آپ ان دو نمبروں کو جاری بل میں بدلنا چاہتے ہیں تو Python میں ایجنٹ ٹوکن لاگت ٹریک کرنا دکھاتا ہے کہ کیسے۔
پراکسی میں مزید ماڈلز شامل کرنا#
model_name کا مقصد یہ ہے کہ آپ کے کلائنٹس ایک ہی عرف (alias) رکھیں جبکہ آپ اس کے پیچھے رکھی چیز بدلتے رہیں۔ ایک model_list میں کئی اندراجات ہو سکتے ہیں، سب ایک ہی api_base اور ایک ہی کلید کی طرف اشارہ کرتے ہوئے، کیونکہ ایک CheapTokens بیلنس ہر ماڈل کو کور کرتا ہے:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
کون سا عرف کس کام کے لیے؟ چیٹ اور ایجنٹ کالز کے لیے جہاں جواب لمبا ہو سکتا ہے، DeepSeek-V4-Flash سے شروع کریں: 380K کانٹیکسٹ، فی جواب زیادہ سے زیادہ 32,768 آؤٹ پٹ ٹوکن، اور بغیر کسی پیک آورز کے مقررہ قیمت۔ GLM-5.3-Flash کا کانٹیکسٹ 390K اور آؤٹ پٹ زیادہ سے زیادہ 8,192 ٹوکن ہے۔ MiniMax-M2.7 کا کانٹیکسٹ 180K ہے۔ DeepSeek صفحہ پر تفصیلات ہیں، اور قیمتوں کی فہرست تینوں کے موجودہ ریٹ دکھاتی ہے۔
جب یہ ٹوٹے: Not Found اور 401#
دو غلطیاں زیادہ تر ناکام پہلی کالز کو کور کرتی ہیں۔ LiteLLM کی دستاویزات کہتی ہیں کہ بیس یو آر ایل میں کچھ اضافی نہ لگائیں، اور Not Found کی غلطی پر آپ کو چیک کرنا چاہیے کہ api_base کا اختتام /v1 پر ہو۔ ایک بات: دستاویزات کی اپنی مثال لوکل پراکسی کے لیے http:/ استعمال کرتی ہے جس میں /v1 نہیں ہے۔ وہ ایک مختلف سرور ہے۔ CheapTokens کے لیے /v1 برقرار رہتا ہے۔
اپنا کیس منتخب کریں
آپ کی غلطی کیسی دکھتی ہے؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
Not Found (404)
api_base چیک کریں۔ یہ بالکل https:/ ہونا چاہیے، /v1 کے ساتھ اور آخر میں / کے بغیر۔ LiteLLM باقی راستہ خود شامل کرتا ہے۔
401 Unauthorized
کلید غائب ہے، غلط ہے، یا LiteLLM نے خالی ماحول متغیر پڑھا ہے۔ یہ جانچنے کے لیے کہ یہ سیٹ ہے، os. کی لمبائی پرنٹ کریں، خود کلید نہیں، اور یقینی بنائیں کہ آپ نے عادتاً کوئی OpenAI کلید پاس نہیں کی۔
ماڈل مسترد ہو گیا
آئی ڈی کا /v1/models سے حرف بہ حرف موازنہ کریں۔ openai/ پری فکس صرف LiteLLM کے لیے ہے؛ اس کے بعد مکمل CheapTokens آئی ڈی آتی ہے، جس میں سلیش سے پہلے ڈویلپر والا حصہ بھی شامل ہے۔
اسٹیٹس کوڈز کی مکمل تفصیل کے لیے API 401 یا 404: غلط کلید، بیس یو آر ایل یا ماڈل آئی ڈی دیکھیں۔ اگر آپ پہلے api_base کے پیچھے کا خیال سمجھنا چاہتے ہیں تو base_url کیا ہے اور کیسے سوئچ کریں اسے آسان زبان میں بیان کرتا ہے۔
فوری جانچ
آپ کا api_base https://api.cheaptokens.dev ہے اور کال Not Found واپس کرتی ہے۔ آپ سب سے پہلے کیا بدلیں گے؟
جواب دکھائیں
جواب: /v1 شامل کریں تاکہ یہ https://api.cheaptokens.dev/v1 پڑھے
Not Found راستے کی طرف اشارہ کرتا ہے۔ کلید 401 دیتی، اور پری فکس ہی وہ چیز ہے جو LiteLLM کو بتاتی ہے کہ OpenAI طرز کی درخواست استعمال کرے۔
ایک ہزار کالز کی لاگت#
فرض کریں پراکسی کے پیچھے ایک سپورٹ بوٹ روزانہ 1,000 درخواستیں بھیجتا ہے، ہر ایک میں تقریباً 2,000 ٹوکن اندر (سوال اور کانٹیکسٹ) اور 500 ٹوکن باہر۔ یہ ہے وہ بوجھ زندہ قیمتوں پر، ساتھ میں OpenRouter کا کالم موازنے کے لیے، کل، ان پٹ اور آؤٹ پٹ ملا کر گنے گئے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
فی درخواست 2,000 ان پٹ اور 500 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
DeepSeek-V4-Flash کے لیے یہ بوجھ روزانہ $0.08 کا پڑتا ہے، اور جدول دکھاتا ہے کہ یہ کل کے لحاظ سے OpenRouter سے سستا ہے۔ دونوں نمبر اپنی اوسط درخواست کے مطابق بدل لیں اور آپ کا بجٹ تیار ہے۔
LiteLLM کو بس اتنا ہی چاہیے: تین ویلیوز، ایک /v1، اور مکمل ماڈل آئی ڈی۔ اپنے ڈیش بورڈ سے کلید شامل کریں اور Python ٹیب چلائیں۔


