API & SDKPanduan
LiteLLM dengan api_base kustom: memanggil CheapTokens di Python
Gunakan awalan openai/, api_base, dan id model lengkap untuk memanggil CheapTokens dari litellm.completion() dan config.yaml proxy LiteLLM, serta memperbaiki Not Found.
Di halaman ini
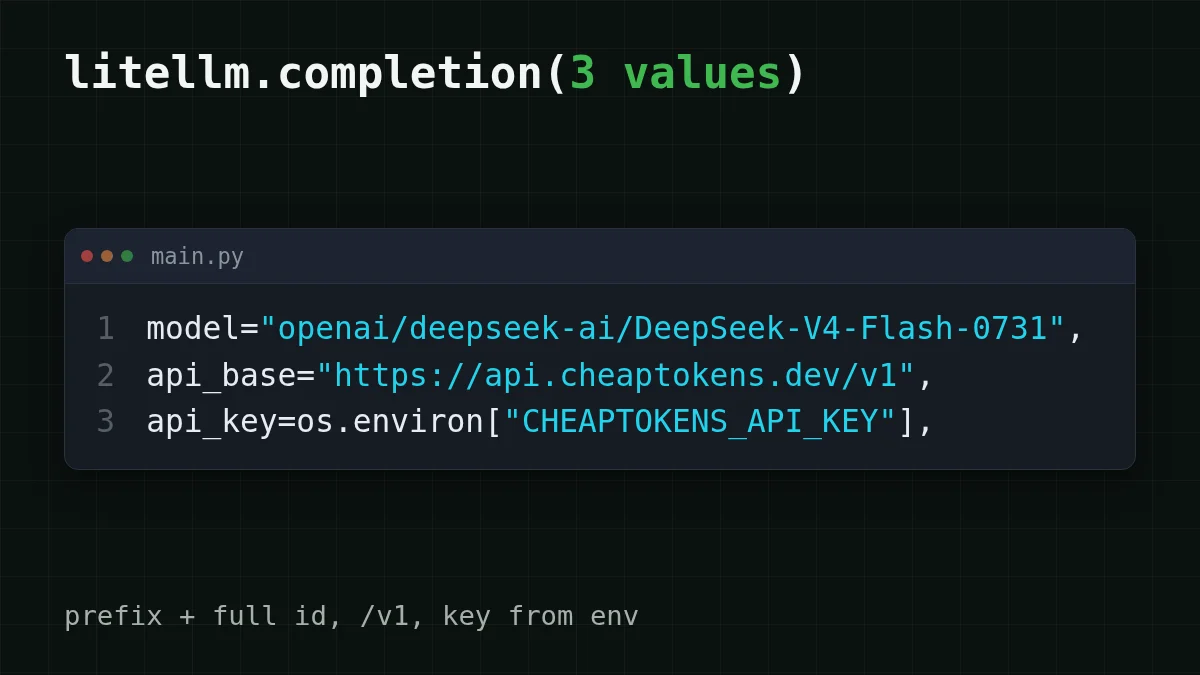
Untuk mengarahkan LiteLLM ke CheapTokens, Anda mengubah tiga nilai: model diberi awalan openai/ di depan id model lengkap, api_base menjadi https:/, dan api_key adalah kunci CheapTokens Anda. Itulah seluruh peralihannya, baik untuk litellm. di Python maupun untuk proxy LiteLLM.
Misalkan Anda sudah punya proyek yang memanggil litellm. dengan model OpenAI atau Anthropic, dan Anda ingin mencoba model yang lebih murah tanpa menyentuh sisa kodenya. Awalan itulah yang membuatnya berfungsi: dokumentasi provider yang kompatibel dengan OpenAI milik LiteLLM (diperiksa 29 Oktober 2026) menyatakan bahwa untuk endpoint apa pun yang kompatibel dengan OpenAI Anda menetapkan model dengan openai/ agar LiteLLM merutekan ke provider OpenAI, lalu meneruskan api_base dan api_key di sampingnya. CheapTokens berbicara dalam format OpenAI Chat Completions di https:/, jadi cocok.
Panggilan yang sama di Python dan di proxy#
Kedua pengaturan ini singkat. Pilih tab yang sesuai dengan cara Anda menjalankan LiteLLM.
Satu model CheapTokens, dua cara memanggilnya
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Simpan kunci di variabel lingkungan, bukan di dalam file.
Proxy config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Jalankan dengan litellm -. Klien meminta cheap-chat ke proxy dan tidak pernah melihat id model sebenarnya.
Panggil proxy
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Proxy mendengarkan di port 4000 secara default. Ganti model di balik cheap-chat nanti dan permintaan ini tidak berubah.
Id model adalah bagian yang sering membuat orang tersandung. Id yang diterima CheapTokens adalah id lengkap, deepseek-, dan openai/ diletakkan di depannya. Bukan deepseek-, bukan hanya awalan ditambah nama pendek. Jika Anda tidak yakin nama sebuah model, daftar model dengan GET /v1/models dan salin id dari jawabannya.
Yang seharusnya Anda lihat#
Jalankan tab Python. print pertama menampilkan teks model. Yang kedua menampilkan response.usage, jumlah token untuk satu panggilan itu: prompt_tokens untuk yang Anda kirim dan completion_ untuk yang ditulis model. LiteLLM mengembalikannya dalam bentuk OpenAI, jadi kode yang sudah membaca usage tetap berfungsi. Jika Anda ingin mengubah kedua angka itu menjadi tagihan berjalan, melacak biaya token agen di Python menunjukkan caranya.
Menambahkan lebih banyak model ke proxy#
Inti dari model_name adalah klien Anda tetap memakai satu alias sementara Anda mengganti apa yang ada di baliknya. Sebuah model_list dapat memuat beberapa entri, semuanya mengarah ke api_base yang sama dan kunci yang sama, karena satu saldo CheapTokens mencakup semua model:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Alias mana untuk tugas apa? Untuk panggilan chat dan agen yang jawabannya bisa panjang, DeepSeek-V4-Flash adalah pilihan awal: konteks 380K, hingga 32.768 token keluaran per jawaban, dan harga tetap tanpa jam sibuk. GLM-5.3-Flash memiliki konteks 390K dan hingga 8.192 token keluaran. MiniMax-M2.7 memiliki konteks 180K. Halaman DeepSeek berisi detailnya, dan harga mencantumkan tarif terkini untuk ketiganya.
Saat gagal: Not Found dan 401#
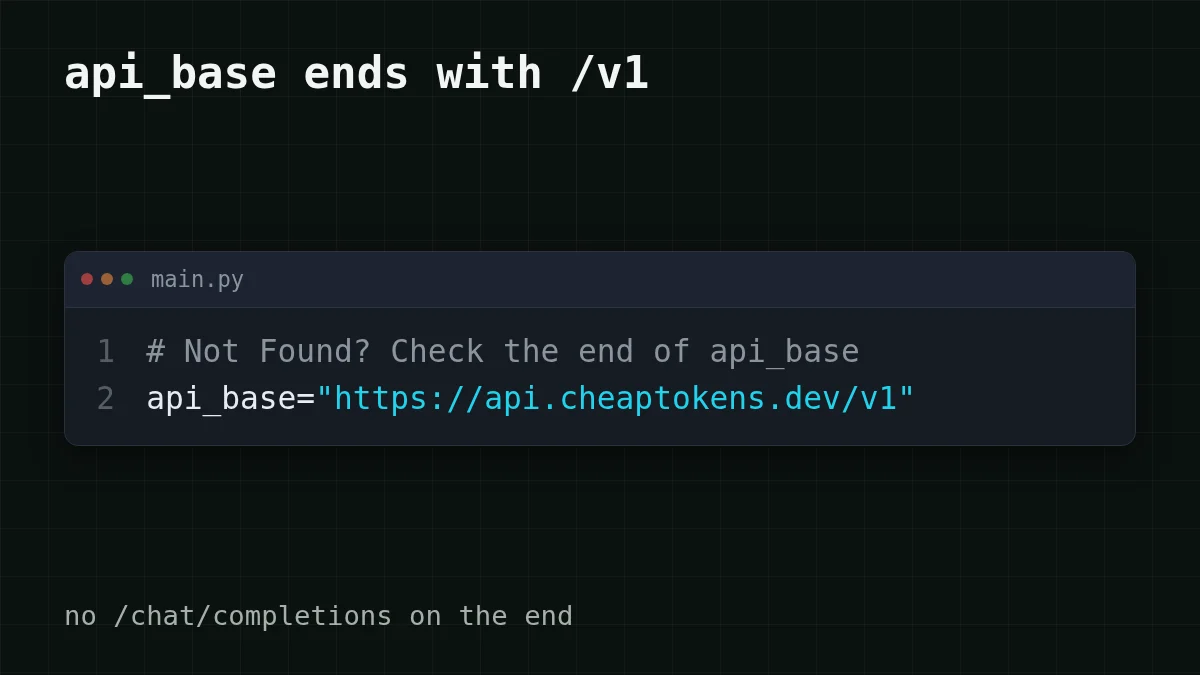
Dua error mencakup sebagian besar panggilan pertama yang gagal. Dokumentasi LiteLLM menyatakan jangan menambahkan apa pun ke base URL, dan pada error Not Found Anda harus memeriksa bahwa api_base diakhiri dengan /v1. Satu jebakan: contoh di dokumentasi itu sendiri untuk proxy lokal memakai http:/ tanpa /v1. Itu server yang berbeda. Untuk CheapTokens, /v1 tetap ada.
Pilih kasus Anda
Seperti apa error Anda?
Pilih opsi untuk melihat jawabannya
Not Found (404)
Periksa api_base. Nilainya harus persis https:/, dengan /v1 dan tanpa / di akhir. LiteLLM menambahkan sisa path-nya sendiri.
401 Unauthorized
Kuncinya hilang, salah, atau LiteLLM membaca variabel lingkungan yang kosong. Cetak panjang os., bukan kuncinya, untuk memeriksa apakah sudah diatur, dan pastikan Anda tidak secara refleks meneruskan kunci OpenAI.
Model ditolak
Bandingkan id huruf demi huruf dengan yang dari /v1/models. Awalan openai/ hanya untuk LiteLLM; yang mengikutinya adalah id CheapTokens lengkap, termasuk bagian developer sebelum garis miring.
Untuk panduan lengkap tentang kode status, lihat API 401 atau 404: kunci, base URL, atau id model yang salah. Jika Anda ingin memahami ide di balik api_base terlebih dahulu, apa itu base_url dan cara menggantinya menjelaskannya dengan versi bahasa sederhana.
Cek cepat
api_base Anda adalah https://api.cheaptokens.dev dan panggilan mengembalikan Not Found. Apa yang Anda ubah lebih dulu?
Tampilkan jawaban
Jawaban: Tambahkan /v1 sehingga menjadi https://api.cheaptokens.dev/v1
Not Found menunjuk ke path. Kunci yang salah akan memberi 401, dan awalan itulah yang memberi tahu LiteLLM untuk memakai permintaan bergaya OpenAI.
Berapa biaya seribu panggilan#
Anggap sebuah bot dukungan di balik proxy mengirim 1.000 permintaan sehari, masing-masing sekitar 2.000 token masuk (pertanyaan plus konteks) dan 500 token keluar. Berikut beban itu pada harga terkini, dengan kolom OpenRouter untuk perbandingan total, input dan output dihitung bersama:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2.000 token input dan 500 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Untuk DeepSeek-V4-Flash beban itu berbiaya $0.08 per hari, dan tabel menunjukkan totalnya lebih murah daripada OpenRouter. Ganti kedua angka itu dengan rata-rata permintaan Anda sendiri dan Anda sudah punya anggarannya.
Itulah semua yang dibutuhkan LiteLLM: tiga nilai, satu /v1, dan id model lengkap. Tambahkan kunci dari dasbor Anda dan jalankan tab Python.


