API та SDKПосібник
LiteLLM із власним api_base: виклик CheapTokens у Python
Використовуйте префікс openai/, api_base і повний ідентифікатор моделі, щоб викликати CheapTokens з litellm.completion() і config.yaml проксі LiteLLM, та виправте Not Found.
На цій сторінці
Щоб спрямувати LiteLLM на CheapTokens, змініть три значення: model отримує префікс openai/ перед повним ідентифікатором моделі, api_base стає https:/, а api_key — це ваш ключ CheapTokens. Це весь перемикач, як для litellm. у Python, так і для проксі LiteLLM.
Припустімо, у вас уже є проєкт, який викликає litellm. з моделлю OpenAI або Anthropic, і ви хочете спробувати дешевшу, не змінюючи решту коду. Префікс — це те, що робить це можливим: документація провайдера, сумісного з OpenAI від LiteLLM (перевірено 29 жовтня 2026 року) каже, що для будь-якої кінцевої точки, сумісної з OpenAI, ви задаєте модель за допомогою openai/, щоб LiteLLM спрямовував запити до провайдера OpenAI, а потім передаєте api_base і api_key поруч із нею. CheapTokens підтримує формат OpenAI Chat Completions за адресою https:/, тож це підходить.
Той самий виклик у Python і в проксі#
Обидва налаштування короткі. Виберіть вкладку, що відповідає тому, як ви запускаєте LiteLLM.
Одна модель CheapTokens, два способи виклику
Python SDK
import os
import litellm

response = litellm.completion(
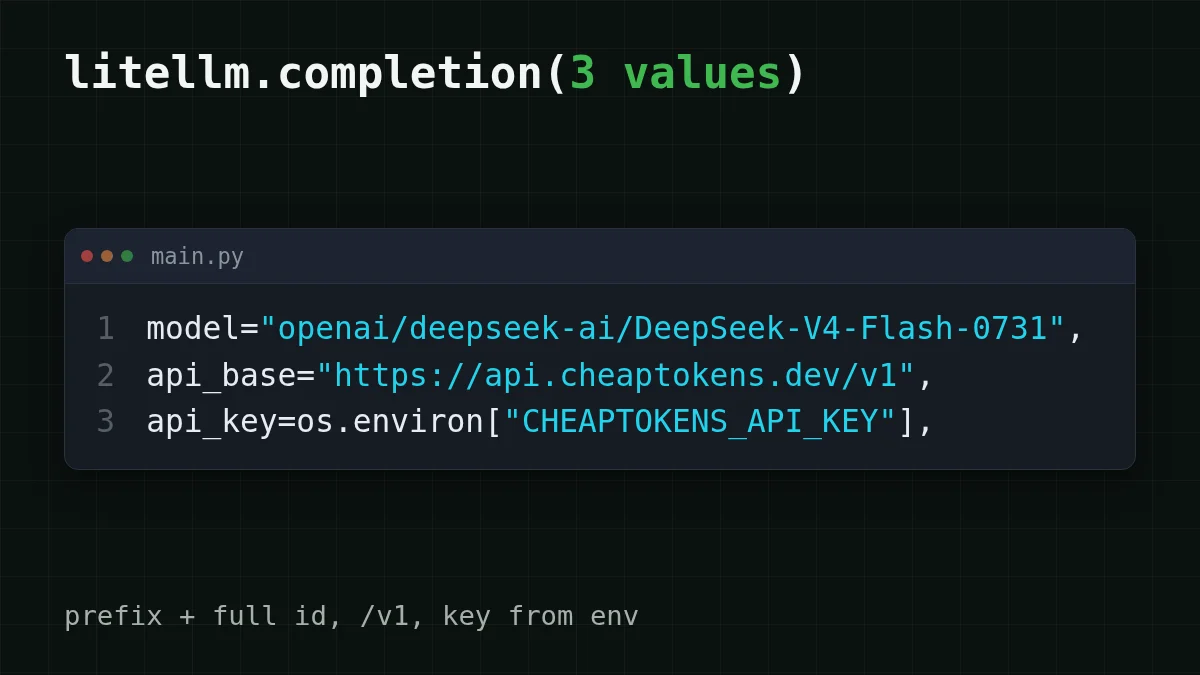
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
Тримайте ключ у змінній середовища, а не у файлі.
Конфігурація проксі config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Запустіть його за допомогою litellm -. Клієнти звертаються до проксі за cheap-chat і ніколи не бачать справжній ідентифікатор моделі.
Виклик проксі
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
Проксі за замовчуванням слухає порт 4000. Змініть модель за cheap-chat пізніше, і цей запит не зміниться.
Ідентифікатор моделі — це те, на чому люди спотикаються. Ідентифікатор, який приймає CheapTokens, — це повний, deepseek-, і openai/ ставиться перед ним. Не deepseek-, не просто префікс плюс коротка назва. Якщо ви не впевнені, як називається модель, перелічіть моделі за допомогою GET /v1/models і скопіюйте ідентифікатор з відповіді.
Що ви маєте побачити#
Запустіть вкладку Python. Перший print показує текст моделі. Другий показує response.usage, кількість токенів для цього одного виклику: prompt_tokens для того, що ви надіслали, і completion_ для того, що написала модель. LiteLLM повертає їх у форматі OpenAI, тож код, який уже читає usage, продовжує працювати. Якщо ви хочете перетворити ці два числа на поточний рахунок, відстеження вартості токенів агента в Python показує як.
Додавання інших моделей до проксі#
Сенс model_name у тому, що ваші клієнти зберігають один псевдонім, поки ви змінюєте те, що за ним стоїть. model_list може містити кілька записів, усі вказують на той самий api_base і той самий ключ, бо один баланс CheapTokens покриває кожну модель:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
Який псевдонім для якої роботи? Для чатів і викликів агентів, де відповідь може бути довгою, DeepSeek-V4-Flash — це те, з чого варто почати: контекст 380K, до 32 768 вихідних токенів на відповідь і фіксована ціна без пікових годин. GLM-5.3-Flash має контекст 390K і до 8 192 вихідних токенів. MiniMax-M2.7 має контекст 180K. Сторінка DeepSeek містить подробиці, а ціни перелічують поточні тарифи для всіх трьох.
Коли ламається: Not Found і 401#
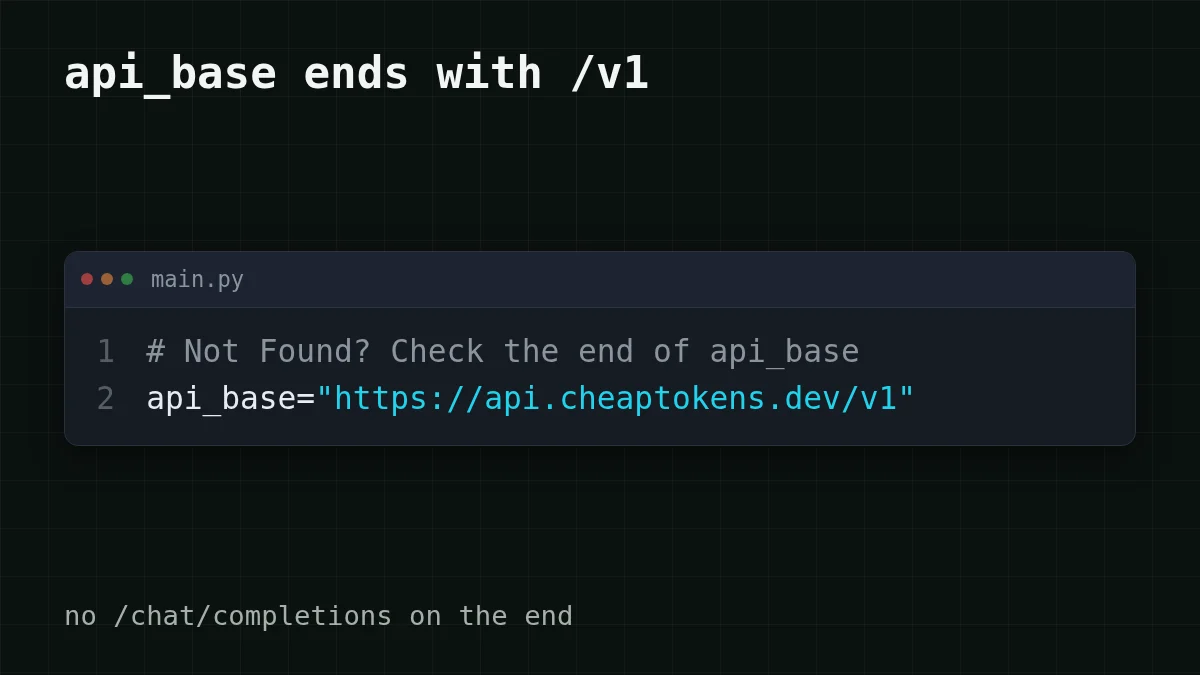
Дві помилки охоплюють більшість невдалих перших викликів. Документація LiteLLM каже не додавати нічого зайвого до базової URL-адреси і що при помилці Not Found слід перевірити, чи api_base закінчується на /v1. Одна зачіпка: власний приклад документації для локального проксі використовує http:/ без /v1. Це інший сервер. Для CheapTokens /v1 залишається.
Оберіть свій випадок
Як виглядає ваша помилка?
Виберіть варіант, щоб побачити відповідь
Not Found (404)
Перевірте api_base. Він має бути точно https:/, з /v1 і без / у кінці. LiteLLM додає решту шляху сам.
401 Unauthorized
Ключ відсутній, неправильний або LiteLLM прочитав порожню змінну середовища. Надрукуйте довжину os., а не сам ключ, щоб перевірити, що він встановлений, і переконайтеся, що ви не передали ключ OpenAI за звичкою.
Модель відхилено
Порівняйте ідентифікатор літера за літерою з тим, що з /v1/models. Префікс openai/ призначений лише для LiteLLM; те, що йде після нього, — це повний ідентифікатор CheapTokens, включно з частиною розробника перед слешем.
Повний огляд кодів стану дивіться в API 401 або 404: неправильний ключ, базова URL-адреса або ідентифікатор моделі. Якщо ви хочете спершу зрозуміти ідею api_base, що таке base_url і як перемикатися пояснює це простою мовою.
Швидка перевірка
Ваш api_base — це https://api.cheaptokens.dev, і виклик повертає Not Found. Що ви змінюєте першим?
Показати відповідь
Відповідь: Додати /v1, щоб він читався як https://api.cheaptokens.dev/v1
Not Found вказує на шлях. Ключ дав би 401, а префікс — це те, що каже LiteLLM використовувати запит у стилі OpenAI.
Скільки коштують тисяча викликів#
Припустімо, бот підтримки за проксі надсилає 1000 запитів на день, кожен приблизно з 2000 токенів на вході (питання плюс контекст) і 500 токенів на виході. Ось це навантаження за поточними цінами, зі стовпцем OpenRouter для порівняння загалом, з урахуванням входу і виходу разом:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
2 000 вхідних і 500 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Для DeepSeek-V4-Flash це навантаження коштує $0.08 на день, і таблиця показує, що загалом це дешевше, ніж OpenRouter. Змініть ці два числа на ваш середній запит, і ви отримаєте свій бюджет.
Це все, що потрібно LiteLLM: три значення, один /v1 і повний ідентифікатор моделі. Додайте ключ зі своєї панелі керування і запустіть вкладку Python.


