API ও SDKগাইড
কাস্টম api_base সহ LiteLLM: Python-এ CheapTokens কল করুন
litellm.completion() এবং একটি LiteLLM প্রক্সি config.yaml থেকে CheapTokens কল করতে openai/ প্রিফিক্স, api_base এবং সম্পূর্ণ মডেল আইডি ব্যবহার করুন, এবং Not Found ঠিক করুন।
এই পৃষ্ঠায়
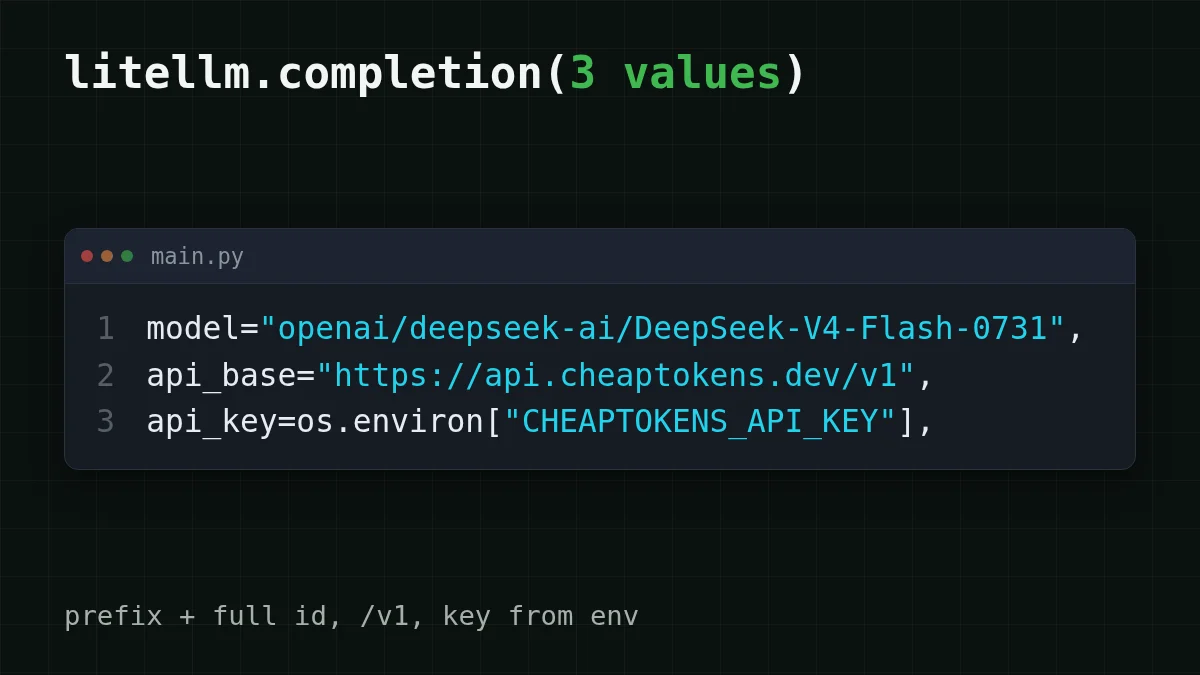
LiteLLM-কে CheapTokens-এ পাঠাতে তিনটি মান পরিবর্তন করতে হয়: model-এ সম্পূর্ণ মডেল আইডির সামনে openai/ প্রিফিক্স বসে, api_base হয়ে যায় https:/, এবং api_key হলো আপনার CheapTokens কী। Python-এ litellm. এবং LiteLLM প্রক্সি—উভয়ের জন্যই এটাই সম্পূর্ণ পরিবর্তন।
ধরুন আপনার একটি প্রজেক্ট আছে যা OpenAI বা Anthropic মডেল দিয়ে litellm. কল করে, এবং আপনি বাকি কোড না ছুঁয়ে একটি সস্তা মডেল চেষ্টা করতে চান। প্রিফিক্সই এটা কাজ করায়: LiteLLM-এর OpenAI-সামঞ্জস্যপূর্ণ প্রোভাইডার ডকুমেন্টেশন (২৯ অক্টোবর ২০২৬-এ যাচাইকৃত) বলছে, যেকোনো OpenAI-সামঞ্জস্যপূর্ণ এন্ডপয়েন্টের জন্য আপনি মডেলটি openai/ দিয়ে সেট করেন যাতে LiteLLM OpenAI প্রোভাইডারে রাউট করে, তারপর তার পাশে api_base এবং api_key পাস করেন। CheapTokens https:/-এ OpenAI Chat Completions ফরম্যাটে কথা বলে, তাই এটি মানানসই।
Python এবং প্রক্সিতে একই কল#
দুটি সেটআপই সংক্ষিপ্ত। আপনি কীভাবে LiteLLM চালান তার সাথে মিলে যাওয়া ট্যাবটি বেছে নিন।
একটি CheapTokens মডেল, কল করার দুটি উপায়
Python SDK
import os
import litellm

response = litellm.completion(
    model="openai/deepseek-ai/DeepSeek-V4-Flash-0731",
    api_base="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
    messages=[{"role": "user", "content": "Explain what api_base does in one sentence."}],
    max_tokens=200,
)

print(response.choices[0].message.content)
print(response.usage)
কীটি ফাইলে নয়, একটি এনভায়রনমেন্ট ভেরিয়েবলে রাখুন।
প্রক্সি config.yaml
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
এটি litellm - দিয়ে চালু করুন। ক্লায়েন্টরা প্রক্সিকে cheap-chat জিজ্ঞাসা করে এবং আসল মডেল আইডি কখনো দেখে না।
প্রক্সি কল করুন
curl http://localhost:4000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "cheap-chat", "messages": [{"role": "user", "content": "Say hi"}]}'
প্রক্সি ডিফল্টভাবে পোর্ট 4000-এ শোনে। পরে cheap-chat-এর পেছনের মডেল বদলান, এই রিকোয়েস্ট বদলাবে না।
মডেল আইডি হলো সেই অংশ যেখানে মানুষ হোঁচট খায়। CheapTokens যে আইডি গ্রহণ করে তা সম্পূর্ণটি, deepseek-, এবং openai/ তার সামনে বসে। deepseek- নয়, শুধু প্রিফিক্স প্লাস একটি সংক্ষিপ্ত নামও নয়। কোনো মডেলের নাম কী তা নিশ্চিত না হলে, GET /v1/models দিয়ে মডেলগুলো তালিকাভুক্ত করুন এবং উত্তর থেকে আইডিটি কপি করুন।
আপনার যা দেখা উচিত#
Python ট্যাবটি চালান। প্রথম print মডেলের টেক্সট দেখায়। দ্বিতীয়টি দেখায় response.usage, সেই একটি কলের টোকেন গণনা: আপনি যা পাঠিয়েছেন তার জন্য prompt_tokens এবং মডেল যা লিখেছে তার জন্য completion_। LiteLLM সেগুলো OpenAI আকৃতিতে ফেরত দেয়, তাই যে কোড ইতিমধ্যে usage পড়ে তা কাজ করতে থাকে। আপনি যদি ওই দুটি সংখ্যাকে চলমান বিলে পরিণত করতে চান, Python-এ এজেন্ট টোকেন খরচ ট্র্যাকিং দেখায় কীভাবে।
প্রক্সিতে আরও মডেল যোগ করা#
model_name-এর মূল কথা হলো আপনার ক্লায়েন্টরা একটি অ্যালিয়াস রাখে যখন আপনি এর পেছনে কী আছে তা বদলান। একটি model_list একাধিক এন্ট্রি ধারণ করতে পারে, সবগুলো একই api_base এবং একই কী-তে নির্দেশ করে, কারণ একটি CheapTokens ব্যালেন্স প্রতিটি মডেল কভার করে:
model_list:
  - model_name: cheap-chat
    litellm_params:
      model: openai/deepseek-ai/DeepSeek-V4-Flash-0731
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-glm
    litellm_params:
      model: openai/zai-org/GLM-5.3-Flash
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
  - model_name: cheap-minimax
    litellm_params:
      model: openai/MiniMaxAI/MiniMax-M2.7
      api_base: https://api.cheaptokens.dev/v1
      api_key: os.environ/CHEAPTOKENS_API_KEY
কোন কাজের জন্য কোন অ্যালিয়াস? চ্যাট এবং এজেন্ট কলের জন্য যেখানে উত্তর দীর্ঘ হতে পারে, DeepSeek-V4-Flash দিয়ে শুরু করুন: 380K কনটেক্সট, প্রতি উত্তরে সর্বোচ্চ 32,768 আউটপুট টোকেন, এবং পিক আওয়ার ছাড়া নির্দিষ্ট মূল্য। GLM-5.3-Flash-এর 390K কনটেক্সট এবং সর্বোচ্চ 8,192 আউটপুট টোকেন। MiniMax-M2.7-এর 180K কনটেক্সট। DeepSeek পৃষ্ঠা-তে বিস্তারিত আছে, এবং মূল্য তালিকা তিনটিরই বর্তমান হার দেখায়।
যখন এটি ভেঙে যায়: Not Found এবং 401#
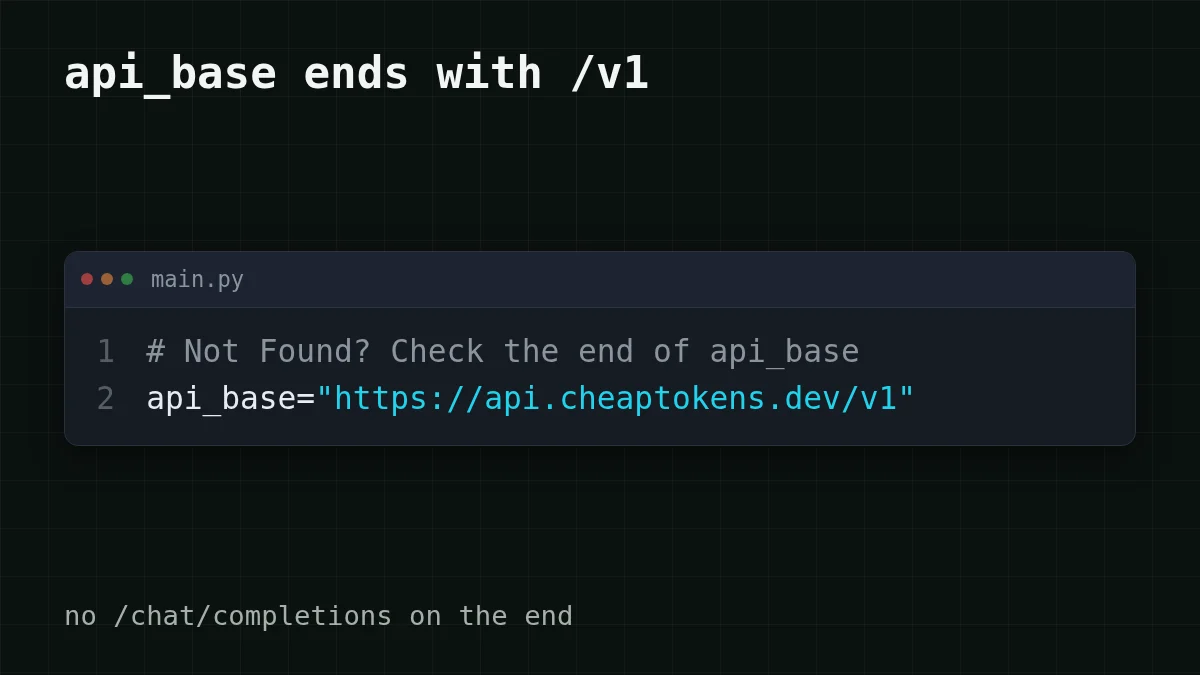
দুটি ত্রুটি বেশিরভাগ ব্যর্থ প্রথম কল কভার করে। LiteLLM ডকুমেন্টেশন বলে বেস URL-এ অতিরিক্ত কিছু যোগ করবেন না, এবং Not Found ত্রুটিতে আপনার পরীক্ষা করা উচিত যে api_base /v1-এ শেষ হয়। একটি দিক: ডকুমেন্টেশনের নিজস্ব স্থানীয় প্রক্সির উদাহরণ http:/ ব্যবহার করে /v1 ছাড়া। সেটি ভিন্ন সার্ভার। CheapTokens-এর জন্য /v1 থাকে।
আপনার কেস বেছে নিন
আপনার ত্রুটি কেমন দেখায়?
উত্তর দেখতে একটি বিকল্প বেছে নিন
Not Found (404)
api_base পরীক্ষা করুন। এটি অবশ্যই ঠিক https:/ হতে হবে, /v1 সহ এবং শেষে / ছাড়া। LiteLLM বাকি পাথ নিজেই যোগ করে।
401 Unauthorized
কীটি অনুপস্থিত, ভুল, অথবা LiteLLM একটি খালি এনভায়রনমেন্ট ভেরিয়েবল পড়েছে। এটি সেট আছে কিনা পরীক্ষা করতে os.-এর দৈর্ঘ্য প্রিন্ট করুন, কী নিজে নয়, এবং নিশ্চিত করুন যে অভ্যাসবশত আপনি একটি OpenAI কী পাস করেননি।
মডেল প্রত্যাখ্যাত
/v1/models থেকে আইডিটি অক্ষর ধরে ধরে তুলনা করুন। openai/ প্রিফিক্স শুধু LiteLLM-এর জন্য; এর পরে যা আসে তা হলো সম্পূর্ণ CheapTokens আইডি, স্ল্যাশের আগের ডেভেলপার অংশসহ।
স্ট্যাটাস কোডের সম্পূর্ণ বিবরণের জন্য দেখুন API 401 বা 404: ভুল কী, বেস URL বা মডেল আইডি। আপনি যদি প্রথমে api_base-এর ধারণা চান, base_url কী এবং কীভাবে বদলাবেন সহজ ভাষায় ব্যাখ্যা করে।
দ্রুত যাচাই
আপনার api_base হলো https://api.cheaptokens.dev এবং কলটি Not Found ফেরত দেয়। আপনি প্রথমে কী পরিবর্তন করবেন?
উত্তর দেখান
উত্তর: /v1 যোগ করুন যাতে এটি https://api.cheaptokens.dev/v1 পড়ে
Not Found পাথের দিকে ইঙ্গিত করে। কী দিলে 401 হতো, এবং প্রিফিক্সই LiteLLM-কে বলে OpenAI-শৈলীর রিকোয়েস্ট ব্যবহার করতে।
এক হাজার কলে কত খরচ#
ধরুন প্রক্সির পেছনে একটি সাপোর্ট বট দিনে 1,000 রিকোয়েস্ট পাঠায়, প্রতিটিতে প্রায় 2,000 টোকেন ইন (প্রশ্ন প্লাস কনটেক্সট) এবং 500 টোকেন আউট। এখানে লাইভ মূল্যে সেই লোড, সাথে OpenRouter কলাম মোট, ইনপুট ও আউটপুট একসাথে গণনা করে তুলনার জন্য:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00006 | $0.06 | $0.121 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00008 | $0.08 | $0.173 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00018 | $0.175 | $1.20 |
প্রতি অনুরোধে ২,০০০ ইনপুট এবং ৫০০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
DeepSeek-V4-Flash-এর জন্য সেই লোডের খরচ দিনে $0.08, এবং টেবিল দেখায় এটি মোটে OpenRouter-এর চেয়ে সস্তা। দুটি সংখ্যা আপনার নিজের গড় রিকোয়েস্টে বদলান এবং আপনার বাজেট তৈরি।
LiteLLM-এর যা দরকার তা এটুকুই: তিনটি মান, একটি /v1, এবং একটি সম্পূর্ণ মডেল আইডি। আপনার ড্যাশবোর্ড থেকে কী যোগ করুন এবং Python ট্যাব চালান।


